
 Assistant scénario▸
 Apps AI
 Actualités AI
FireRedASR : modèle de reconnaissance vocale open source de Xiaohongshu
FireRedASR : modèle de reconnaissance vocale open source de XiaohongshuIntroduction
FireRedASR est un modèle de reconnaissance vocale basé sur un grand modèle de langage, publié et open-sourcé le 9 février 2025 par l'équipe FireRed de Xiaohongshu. Il atteint un nouveau SOTA dans le domaine de la reconnaissance vocale du mandarin (taux d'erreur de caractères CER de 3,05 %), et prend en charge la reconnaissance des dialectes, de l'anglais et des paroles.
Principales fonctionnalités de FireRedASR :
Reconnaissance vocale de haute précision : FireRedASR-LLM (8,3 milliards de paramètres) atteint un taux d'erreur de caractères (CER) de 3,05 % sur des ensembles de tests publics, devenant ainsi le nouveau SOTA, avec une réduction du taux d'erreur de 8,4 % par rapport au précédent modèle SOTA Seed-ASR (12 milliards+ de paramètres).
Inférence efficace : FireRedASR-AED (1,1 milliard de paramètres) améliore considérablement l'efficacité d'inférence tout en maintenant une précision élevée, avec un CER de 3,18 %.
Adaptation multi-scénarios : FireRedASR est performant dans divers scénarios quotidiens tels que les courtes vidéos, le streaming en direct, la saisie vocale et les assistants intelligents. Par rapport aux principaux fournisseurs de services ASR du secteur et à Paraformer-Large, le CER est réduit de manière relative de 23,7 % à 40,0 %.
Capacité de reconnaissance des paroles : dans les scénarios nécessitant la reconnaissance des paroles, FireRedASR-LLM atteint une réduction relative du CER de 50,2 % à 66,7 %, démontrant une très forte capacité d'adaptation.
Support multilingue : FireRedASR prend en charge le mandarin et est performant dans la reconnaissance vocale des dialectes chinois et de l'anglais, élargissant ainsi davantage son champ d'application.
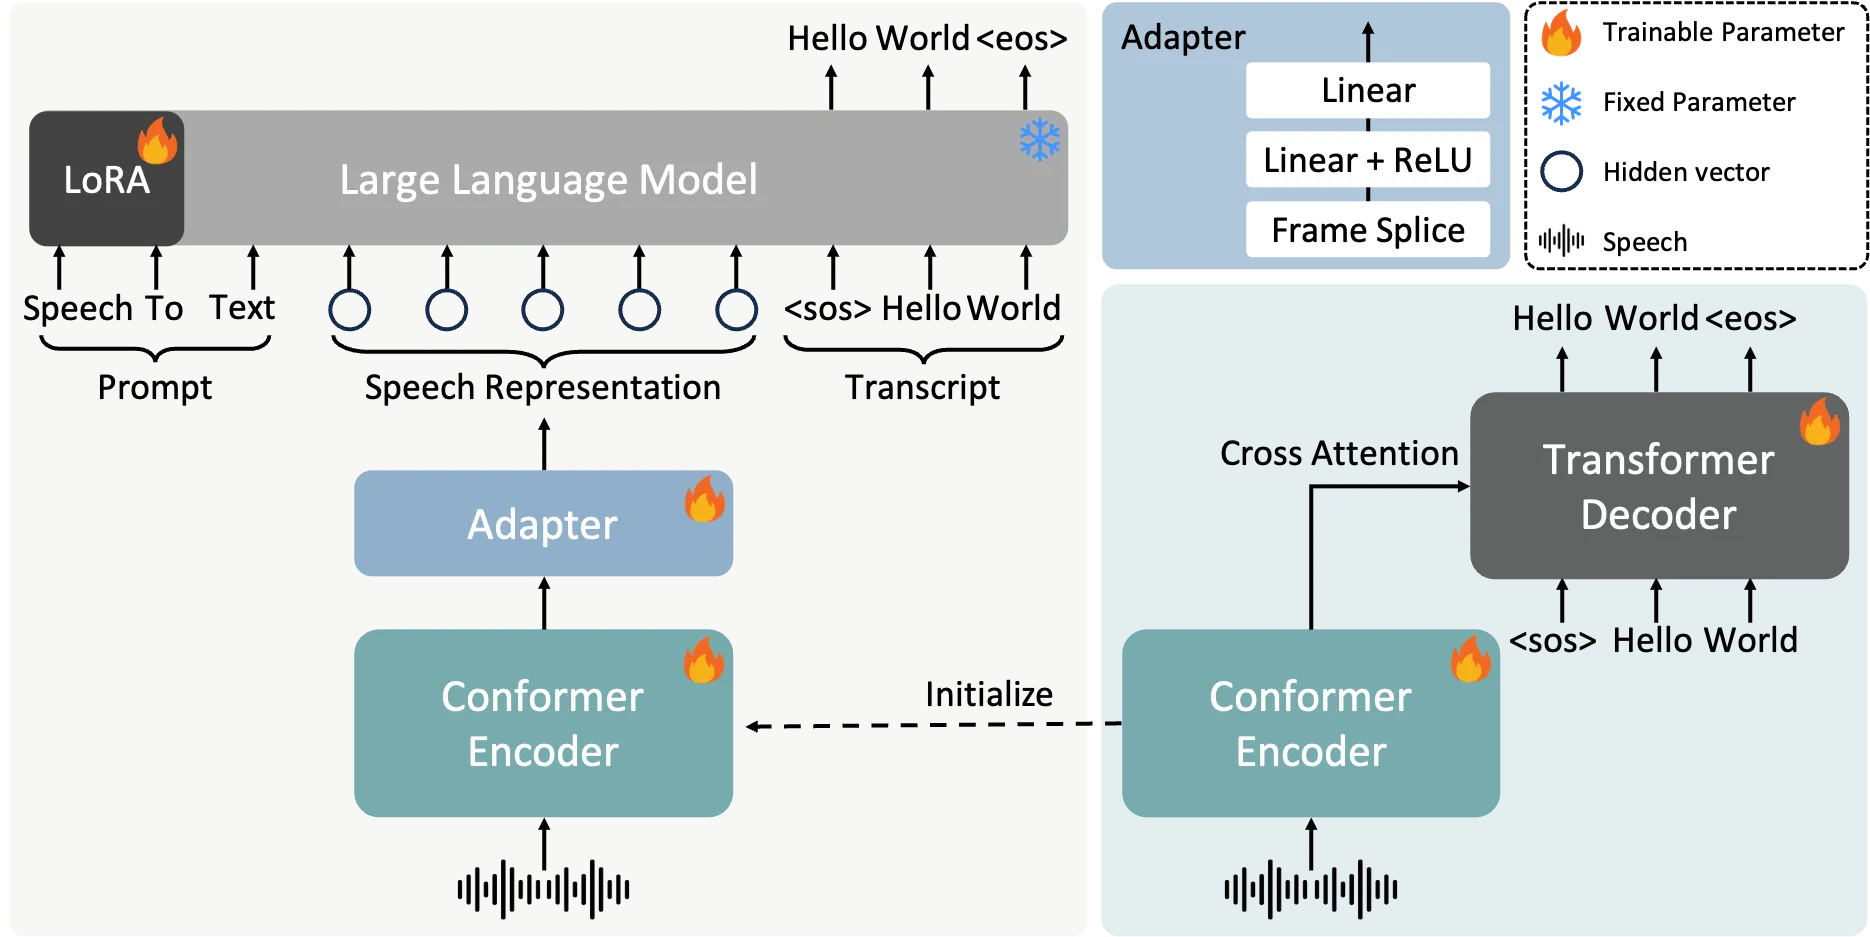
Les deux versions principales du modèle FireRedASR :
FireRedASR-LLM
Architecture : adopte un cadre Encoder-Adapter-LLM, combiné au grand modèle de langage Qwen2-7B-Instruct, et réalise une interaction vocale de bout en bout grâce au fine-tuning LoRA.
Performances : CER de 3,05 % sur les benchmarks en mandarin, avec une réduction du taux d'erreur de 8,4 % par rapport au précédent modèle SOTA ; réduction relative du CER de 50,2 % à 66,7 % dans les scénarios de reconnaissance de paroles.
Caractéristiques : 8,3 milliards de paramètres, axé sur une précision extrême, adapté aux scénarios exigeants tels que la génération de sous-titres professionnelle.
FireRedASR-AED
Architecture : basé sur un encodeur-décodeur à attention (encodeur Conformer + décodeur Transformer), avec 1,1 milliard de paramètres.
Performances : CER de 3,18 %, supérieur à Seed-ASR avec 12 milliards de paramètres, avec une efficacité d'inférence plus élevée.
Caractéristiques : équilibre entre précision et efficacité de calcul, adapté aux applications en temps réel telles que les sous-titres de streaming en direct et les assistants vocaux.
Points forts techniques de FireRedASR :
Adaptation multi-scénarios : dans les scénarios quotidiens tels que les vidéos courtes et le streaming en direct, le CER est réduit de manière relative de 23,7 % à 40,0 % ; prend en charge les dialectes chinois et l'anglais.
Écosystème open source : le modèle et le code sont open source (GitHub), adoptent une conception de niveau industriel et prennent en charge le développement secondaire par la communauté.
Stratégie d'entraînement : la version LLM fixe la plupart des paramètres et n'entraîne que l'encodeur et l'adaptateur, préservant ainsi les capacités pré-entraînées.
Scénarios d'application de FireRedASR
Interaction vocale intelligente : FireRedASR peut être appliqué dans des scénarios tels que les assistants vocaux intelligents et la saisie vocale, offrant des services de reconnaissance vocale de haute précision.
Compréhension du contenu multimédia : FireRedASR est performant dans les scénarios de compréhension de contenu multimédia tels que la génération de sous-titres vidéo et la reconnaissance des paroles.
Applications dans des scénarios quotidiens : FireRedASR est performant dans divers scénarios quotidiens tels que les vidéos courtes, le streaming en direct, la saisie vocale et les assistants intelligents. Par rapport aux principaux fournisseurs de services ASR du secteur et à Paraformer-Large, le CER est réduit de manière relative de 23,7 % à 40,0 %.
Liens liés à FireRedASR :
Adresse du projet : https://github.com/FireRedTeam/FireRedASR
Adresse de l'article : https://arxiv.org/abs/2501.14350














