
 Assistant scénario▸
 Apps AI
 Actualités AI
Kokoro TTS : un modèle de synthèse vocale (TTS) open source et hautes performances
Kokoro TTS : un modèle de synthèse vocale (TTS) open source et hautes performancesIntroduction
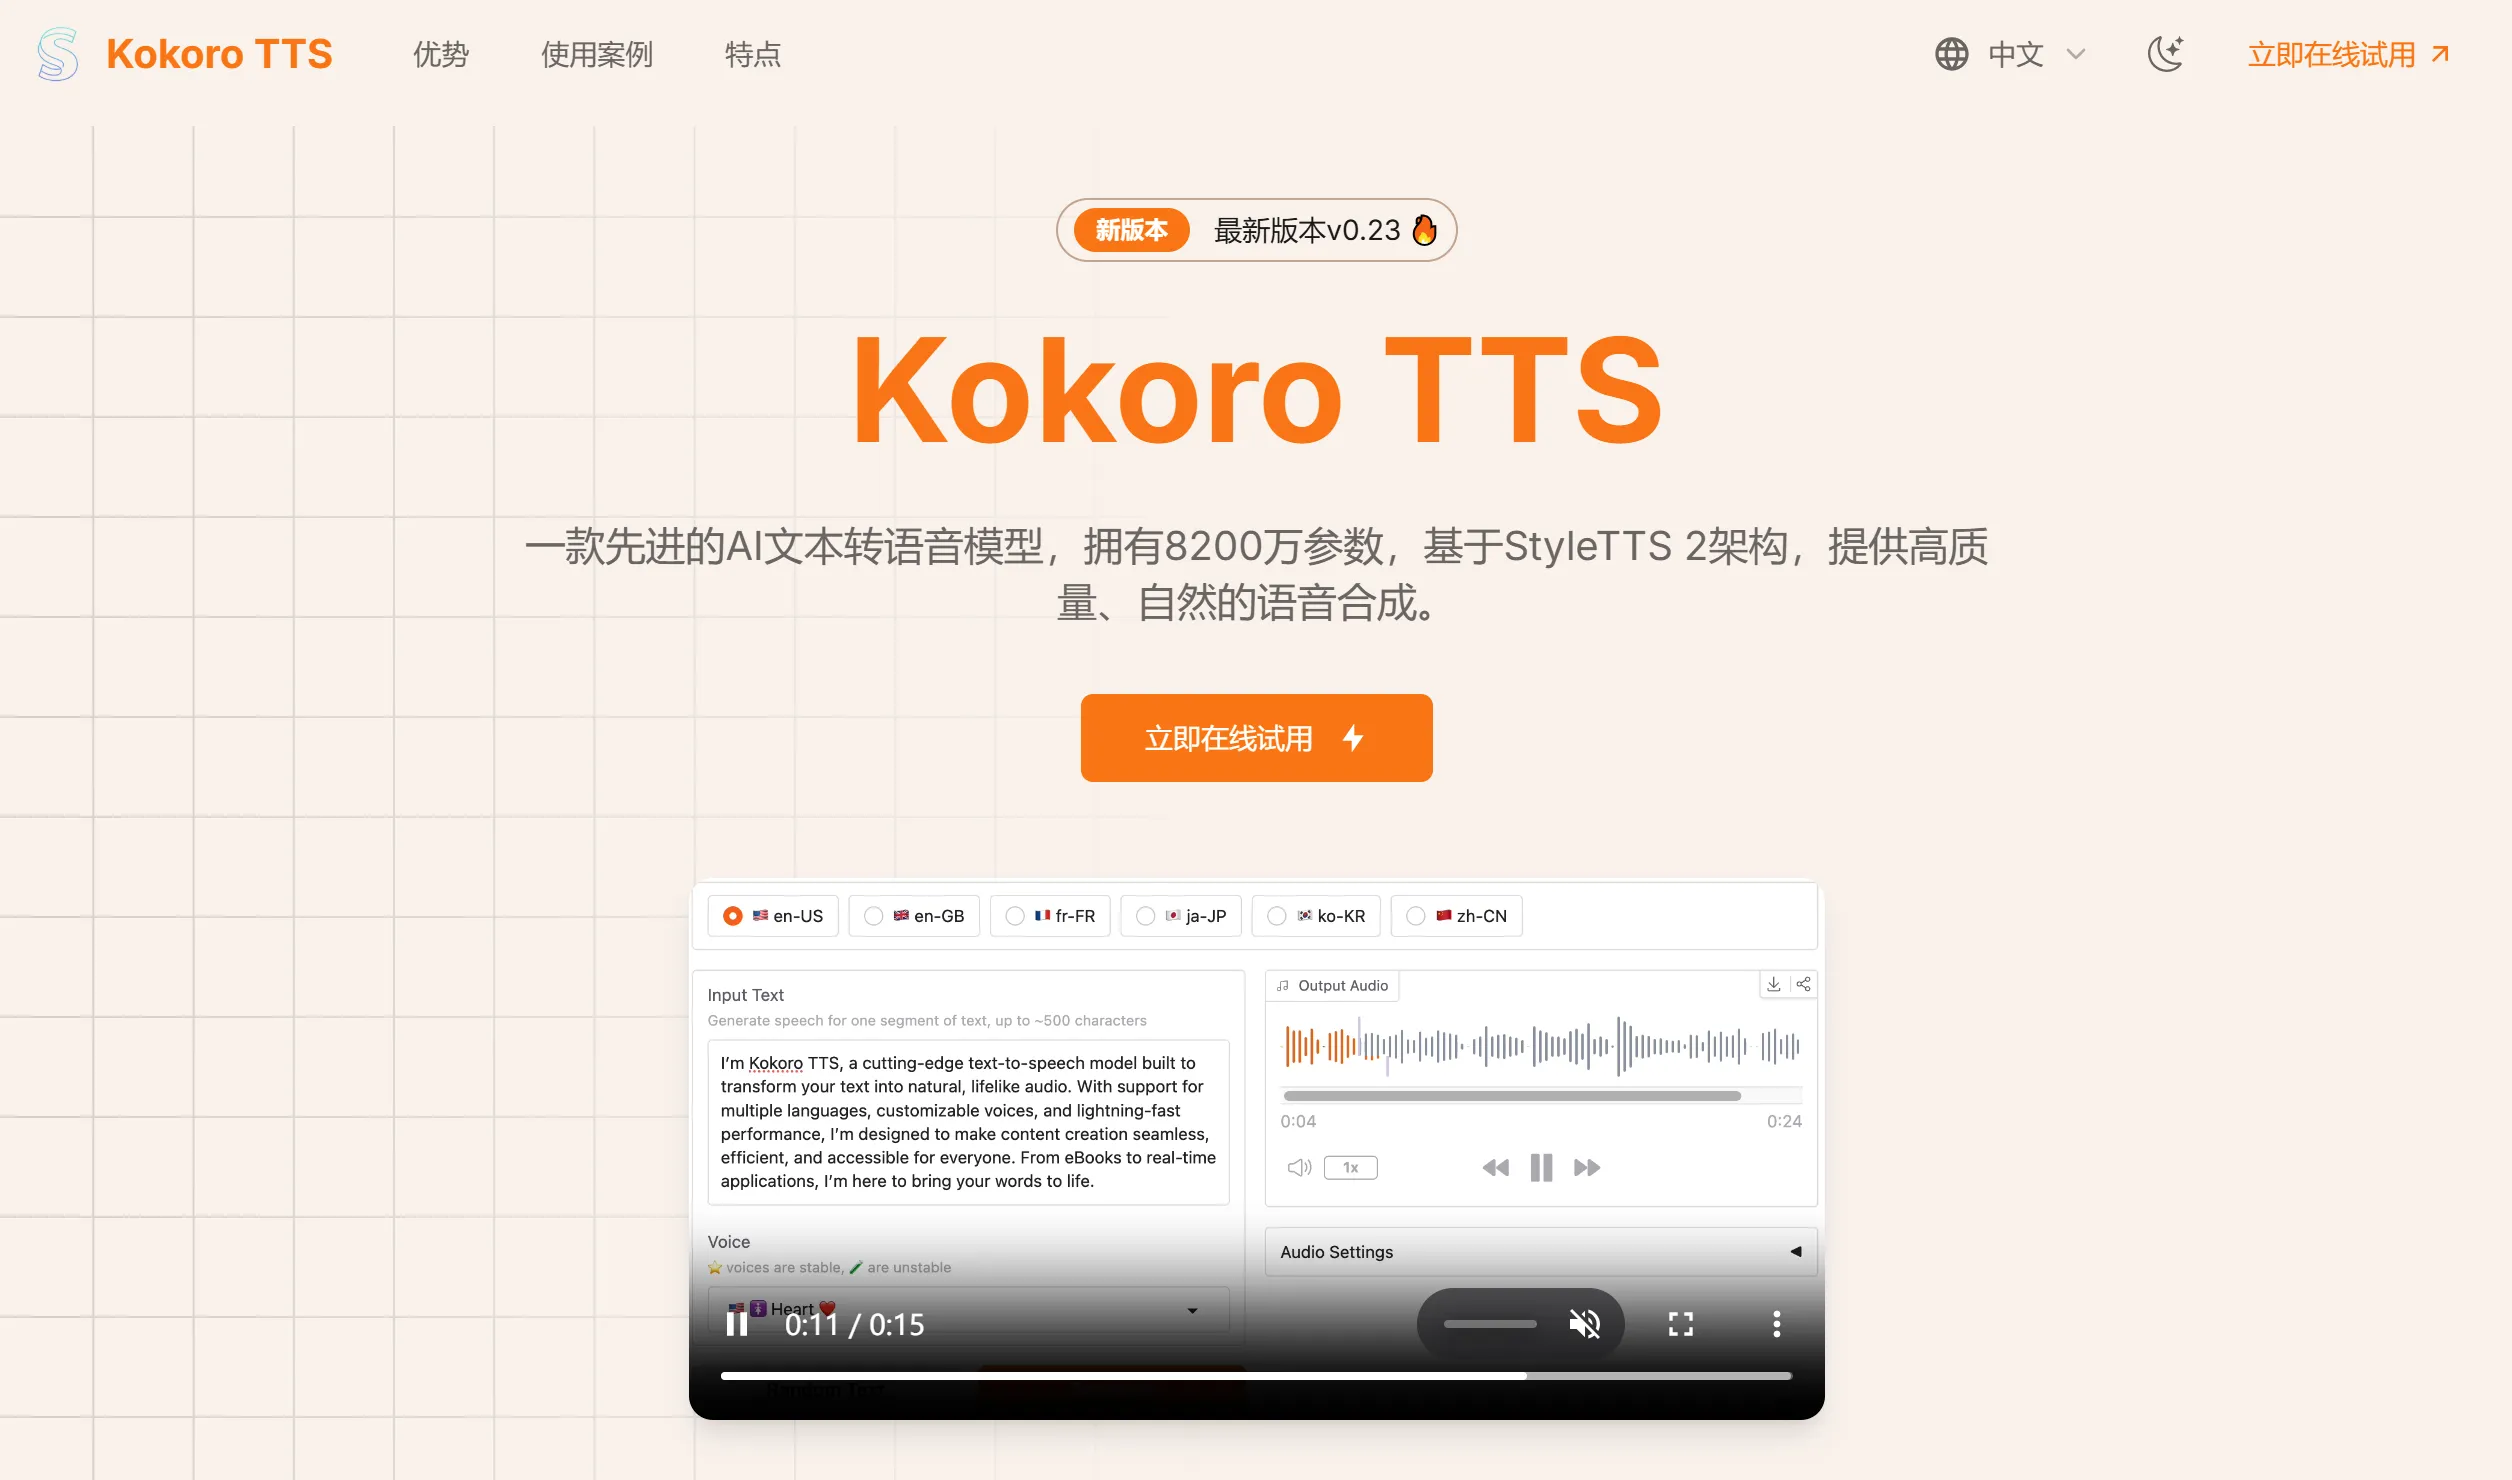
Kokoro TTS est un modèle de text-to-speech (TTS) open source, léger et performant, doté de 82 millions de paramètres, basé sur l'architecture StyleTTS 2, offrant une synthèse vocale de haute qualité et naturelle, adapté aux livres audio, podcasts, etc., et est devenu un produit phare dans le domaine du TTS.
Fonctionnalités de Kokoro TTS
Synthèse vocale de haute qualité : Kokoro TTS est capable de convertir du texte en une voix naturelle et fluide, prenant en charge plusieurs langues, notamment l'anglais américain et britannique, le français, le japonais, le coréen et le chinois.
Prise en charge multilingue : prend en charge des langues telles que l'anglais américain, l'anglais britannique, le français, le coréen, le japonais et le mandarin.
Diversité des styles vocaux : Kokoro TTS est non seulement capable de générer une voix naturelle et fluide, mais prend également en charge des styles spéciaux tels que le chuchotement, ainsi que 10 packs vocaux différents, couvrant différents genres et caractéristiques.
Faible consommation de ressources : Kokoro TTS ne comporte que 82M de paramètres, ce qui, comparé à de nombreux modèles TTS courants, lui permet de consommer moins de ressources et de fonctionner efficacement sur un ordinateur standard.
Génération en temps réel : Kokoro TTS prend en charge la génération vocale en temps réel, permettant aux utilisateurs d'obtenir instantanément la sortie vocale souhaitée.
Prise en charge de plusieurs formats d'entrée : cet outil prend en charge divers formats d'entrée, notamment les fichiers texte et les livres électroniques (comme l'EPUB).
Caractéristiques principales de Kokoro TTS :
Légèreté et haute performance
Avec seulement 82 millions de paramètres, Kokoro TTS, grâce à une architecture hybride optimisée de StyleTTS 2 et d'ISTFTNet, offre une qualité vocale comparable à celle de grands modèles comportant des milliards de paramètres (tels que MetaVoice et XTTS)37. Sa conception purement décodeur abandonne la structure d'encodeur traditionnelle, réduit la complexité de calcul et permet une synthèse en temps quasi réel sur CPU ainsi qu'un traitement accéléré par GPU710.
Vitesse et efficacité : temps de synthèse inférieur à 100 ms, prenant en charge l'edge computing et le déploiement sur des appareils à faibles ressources.
Prise en charge multilingue : actuellement axée sur l'anglais (américain/britannique), mais l'architecture prend en charge une extension future à plusieurs langues telles que le chinois, le français et le japonais.
Open source et commercial
Adopte la licence Apache 2.0, autorisant l'usage commercial gratuit et le développement secondaire, ce qui convient aux développeurs individuels ainsi qu'à l'intégration en entreprise. La plateforme Hugging Face fournit les poids du modèle et la documentation de déploiement, abaissant ainsi la barrière d'utilisation.
Styles vocaux diversifiés
Propose plus de 10 packs vocaux pré-entraînés (tels que Bella, Adam, Sarah), couvrant différents genres et accents, et prend en charge des styles spéciaux comme le chuchotement, enhancing the diversity of expression.
Avantages techniques de kokoroTTS :
Innovation architecturale :combine le contrôle de la prosodie de StyleTTS 2 et la génération de spectres efficace d'ISTFTNet, sans dépendre des modèles de diffusion, réduisant ainsi la consommation de ressources de calcul tout en maintenant une qualité sonore haute fidélité.
Entraînement et conformité des données :basé sur un ensemble de données sélectionné de 100 heures, dont les données proviennent d'audio du domaine public et de contenus synthétiques conformes, garantissant la sécurité des droits d'auteur.
Flexibilité de déploiement :prend en charge l'optimisation via le runtime ONNX, peut être déployé localement ou dans le cloud, sans dépendre d'un GPU, est compatible avec des outils tels que Docker et FastAPI, et fournit une interface API REST.
Scénarios d'application de kokoroTTS :
Systèmes d'interaction en temps réel : tels que les assistants vocaux et le service client, exploitant la faible latence pour obtenir un retour vocal instantané710.
Création de contenu : livres audio, doublage publicitaire, génération de voix de personnages de jeux, prenant en charge le choix de tonalités personnalisées712.
Services d'accessibilité : fournit une prise en charge du text-to-speech pour les utilisateurs malvoyants, offrant des services de lecture de texte pour les aider à accéder aux informations.
Éducation et médias : explication de cours en ligne, production de podcasts, génération de vidéos de formation multilingues ou de contenus audio éducatifs.
Jeux et réalité virtuelle : dans les applications de jeu et de réalité virtuelle, Kokoro TTS peut fournir une voix naturelle pour les personnages.
Conversion de livres électroniques en livres audio Kokoro : transformez facilement votre bibliothèque de livres électroniques en livres audio de haute qualité, même pour des titres à faible tirage, grâce aux voix multilingues naturelles de Kokoro.
Démarrage rapide
Téléchargez depuis Github, installez les dépendances via pip ou npm ;
Clonez le modèle Kokoro TTS depuis Hugging Face et chargez le pack vocal ;
Appelez l'API pour générer un audio 24 kHz, prenant en charge une exécution locale ou sur des appareils en edge.
Grâce à son caractère open source et à sa licence commerciale favorable, Kokoro TTS présente un avantage concurrentiel sur le marché, en particulier dans les applications commerciales nécessitant une synthèse vocale de haute qualité
Articles connexes :
llasa 3B TTS : un modèle de text-to-speech (TTS) basé sur l'architecture LLaMA
Recommandation de 10 excellents modèles vocaux TTS open source
Seed-TTS : un modèle TTS (text-to-speech) de haute qualité développé par ByteDance














