
 Assistant scénario▸
 Apps AI
 Actualités AI

DeepSeek Coder : grand modèle open-source de génération de code par DeepSeek
DeepSeek Coder : grand modèle open-source de génération de code par DeepSeekIntroduction
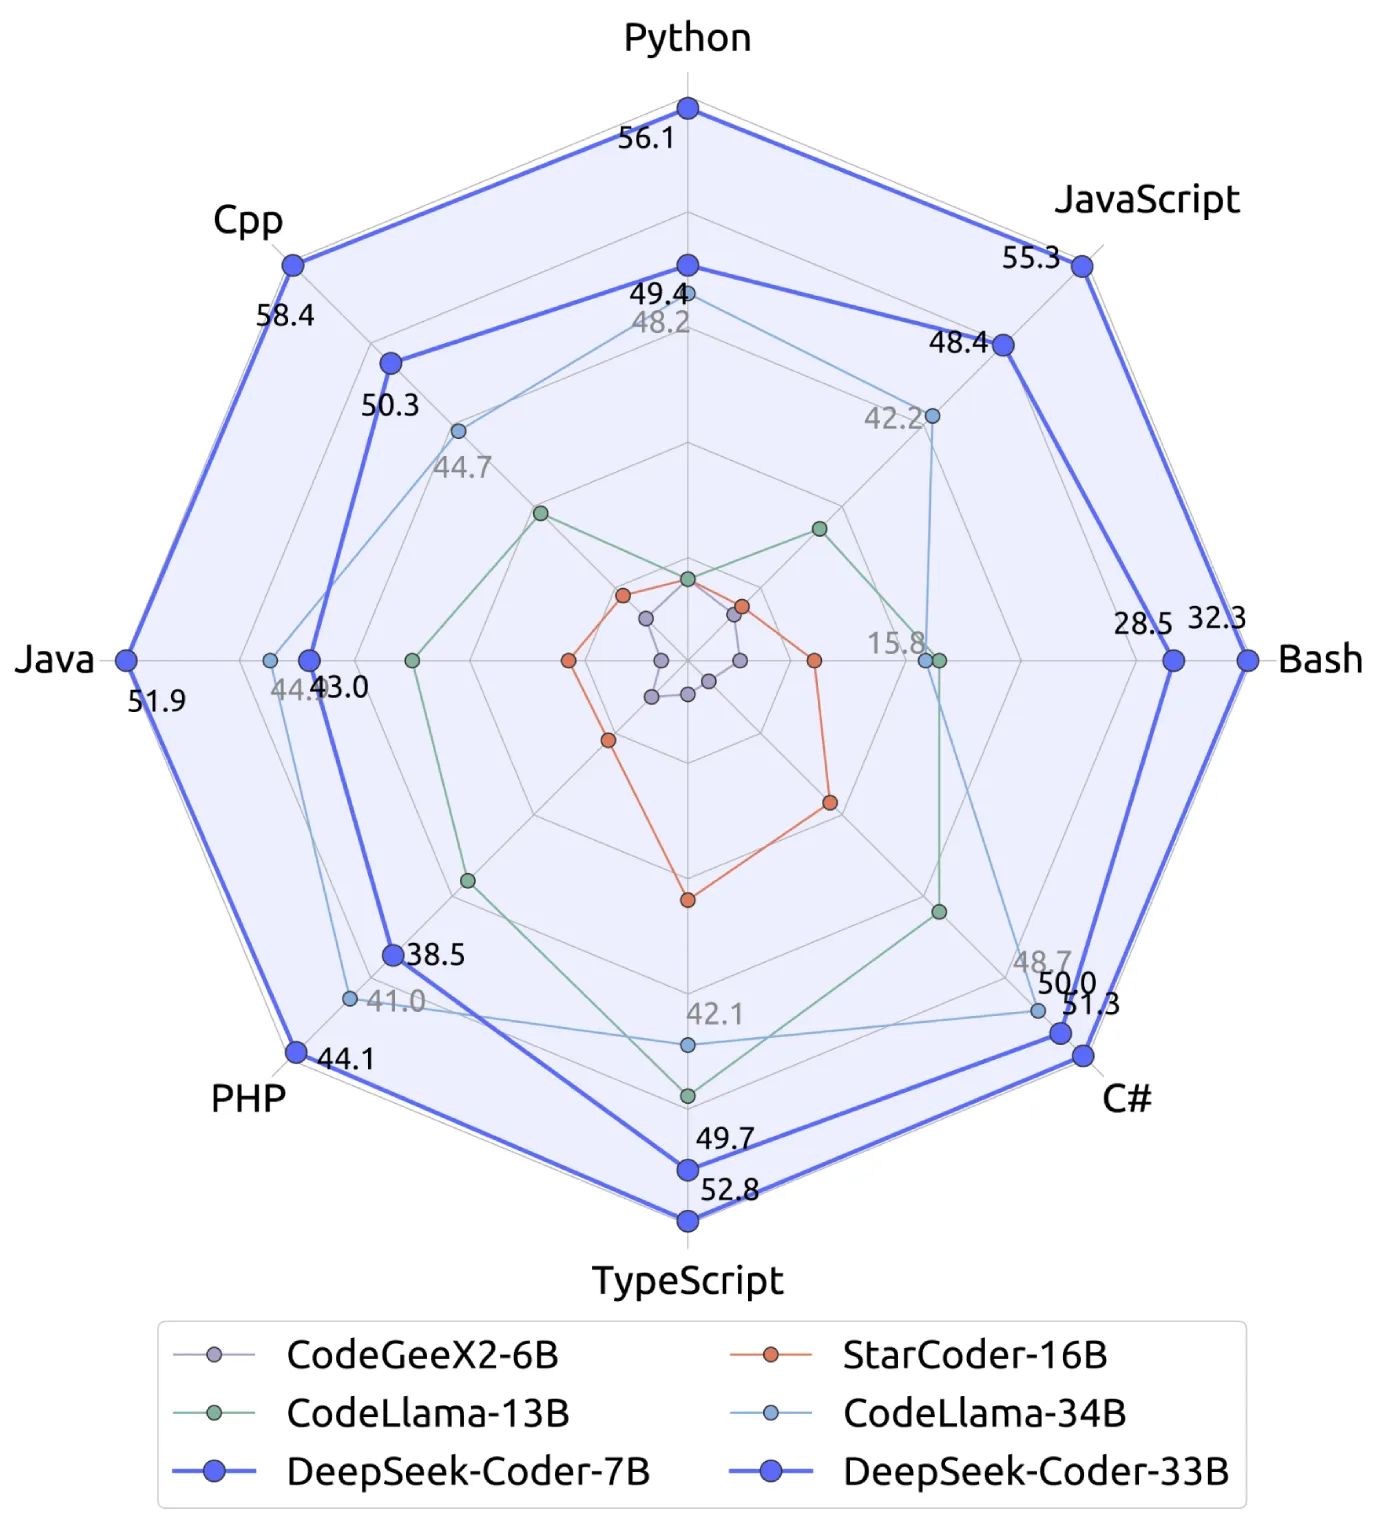
DeepSeek Coder est une série de modèles linguistiques de grande taille open source dédiés à la génération de code, lancée par l'entreprise chinoise d'intelligence artificielle DeepSeek. Grâce à des techniques d'apprentissage profond, elle améliore la génération et la compréhension de code, augmente l'efficacité de programmation des développeurs, et atteint ou dépasse les performances des principaux modèles propriétaires dans plusieurs benchmarks.
I. Architecture du modèle et technologies clés
Architecture à mixture d'experts (MoE)
DeepSeek Coder V2 adopte une architecture MoE, avec un total de 236 milliards de paramètres et 21 milliards de paramètres activés, améliorant l'adaptabilité aux tâches grâce à la sélection dynamique des réseaux d'experts. Ses données d'entraînement couvrent 338 langages de programmation (contre 86 pour la V1), et il prend en charge une fenêtre de contexte de 128K, permettant de traiter des dépôts de code complexes et des tâches de long texte.
Méthodes d'entraînement innovantes
Fill-In-Middle (FIM) : en divisant aléatoirement le code en préfixe (Prefix), milieu (Middle) et suffixe (Suffix), le modèle est entraîné à compléter la partie manquante, renforçant ainsi ses capacités de complétion de code.
Pré-entraînement au niveau du dépôt (Repo-Level) : un jeu de données est construit à partir des dépendances du dépôt de code, en utilisant un tri topologique pour gérer les dépendances inter-fichiers, améliorant la capacité de génération de code au niveau du projet.
Optimisation par apprentissage par renforcement
L'algorithme GRPO (Group Relative Policy Optimization) est utilisé pour aligner les préférences humaines, combiné avec les retours du compilateur et des cas de test afin d'optimiser l'exactitude du code.
II. Performances et benchmarks
Capacité de génération de code
Sur le benchmark HumanEval, DeepSeek Coder V2 atteint un taux de précision de 90,2 %, surpassant GPT-4-Turbo et Claude 3 Opus8.
Sur SWE-Bench (test de tâches de code complexes), c'est le premier modèle open source à obtenir un score supérieur à 10 %.
Il prend en charge la génération multilingue, couvrant 338 langages dont Python, Java, Rust, et sa vitesse de génération est 20 % supérieure à celle de GPT-4.
Capacités mathématiques et de raisonnement
Sur les benchmarks de niveau compétition mathématique tels que MATH et aiME, ses performances sont comparables à celles de GPT-4o et Gemini 1.5 Pro.
Le raisonnement en chaîne de pensée (Chain-of-Thought, CoT) améliore significativement la résolution de problèmes complexes.
Traitement général du langage
Sur le test MMLU (compréhension linguistique multitâche), il obtient un score de 79,2 %, maintenant une capacité générale comparable à celle des modèles généralistes (comme DeepSeek-V2).
III. Écosystème développeur et cas d'usage
Open source et faible coût
Le modèle, le code et le rapport technique sont entièrement open source (licence MIT), permettant un usage commercial gratuit et un développement dérivé.
La tarification de l'API est très compétitive : le coût d'entrée n'est que de 0,27 dollar par million de tokens (et seulement 0,07 dollar en cas de cache hit), bien inférieur aux 18 dollars de GPT-4.
Intégration et déploiement
Des modèles pré-entraînés sont fournis sur Hugging Face, ainsi que des solutions de déploiement privé en local, prenant en charge un déploiement sur une seule machine avec 880 Go de VRAM ou une version légère sur une seule carte de 40 Go (V2-Lite).
Intégration d'une chaîne d'outils de développement (comme le framework vLLM), optimisant le mécanisme d'attention sparse, réduisant l'occupation mémoire et améliorant la vitesse d'inférence.
Cas d'usage
Revue de code automatisée : identification des vulnérabilités du code et proposition d'optimisations, accélérant le cycle de développement.
Construction d'API : génération automatique de services RESTful, de requêtes GraphQL, etc., réduisant l'écriture de code boilerplate.
Projets de machine learning : génération de pipelines de données et de code d'algorithmes, prenant en charge le développement IA de bout en bout.
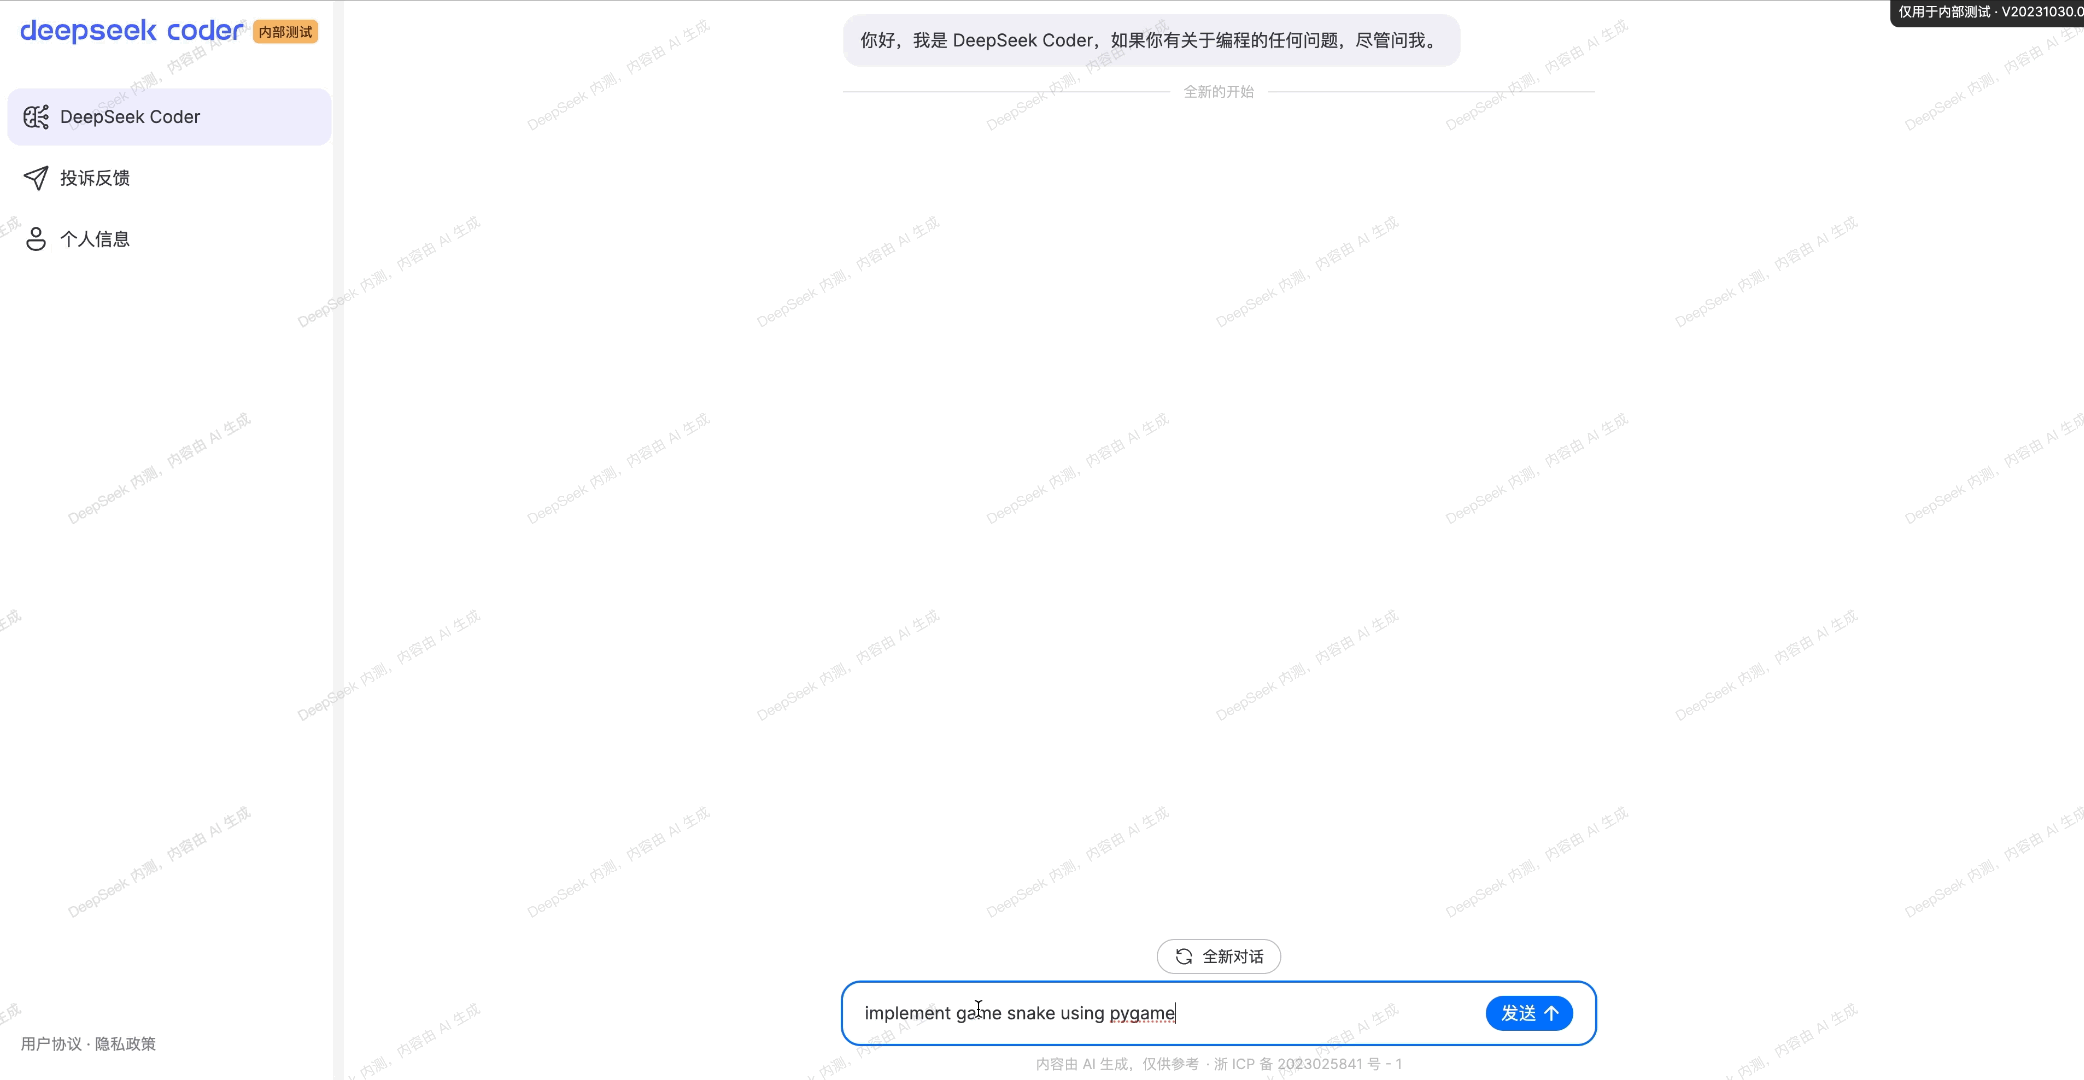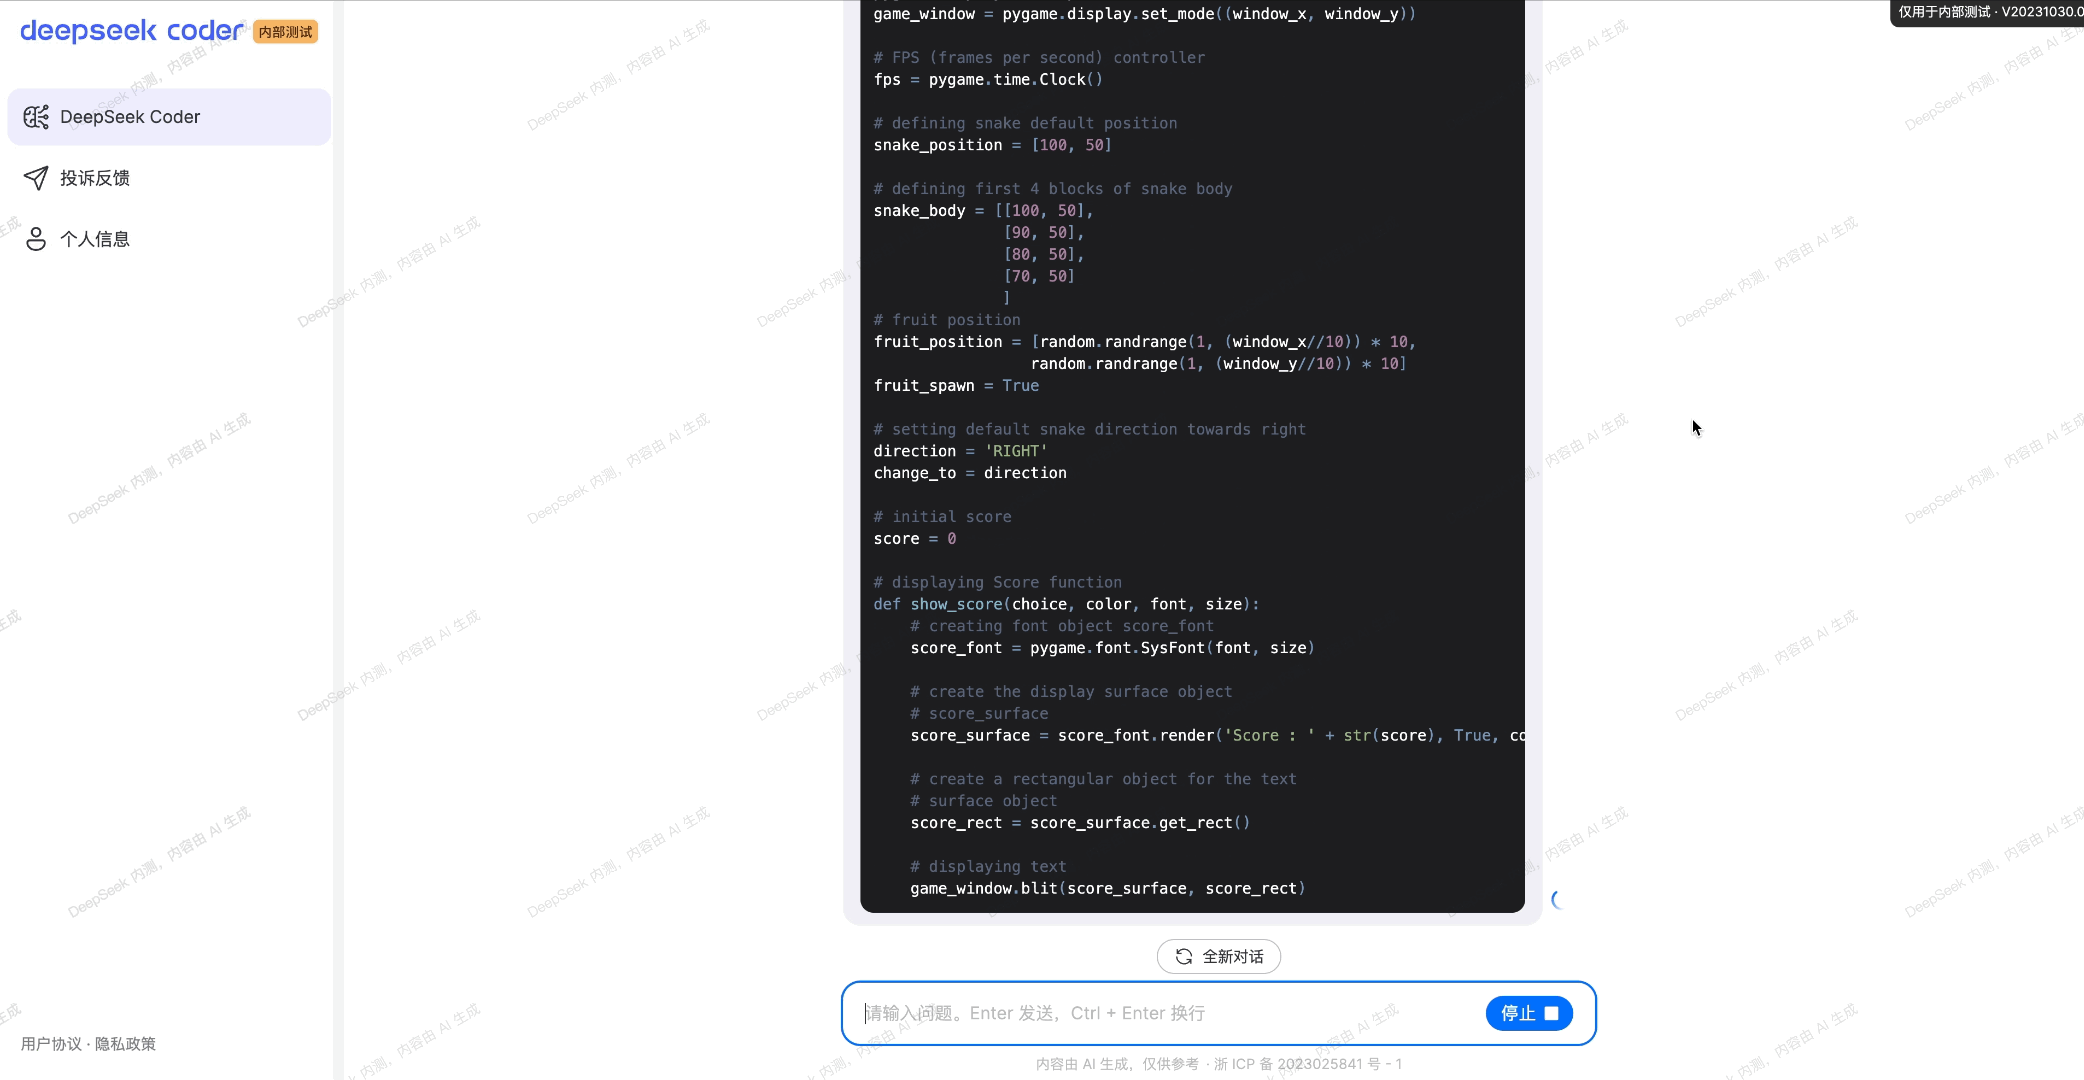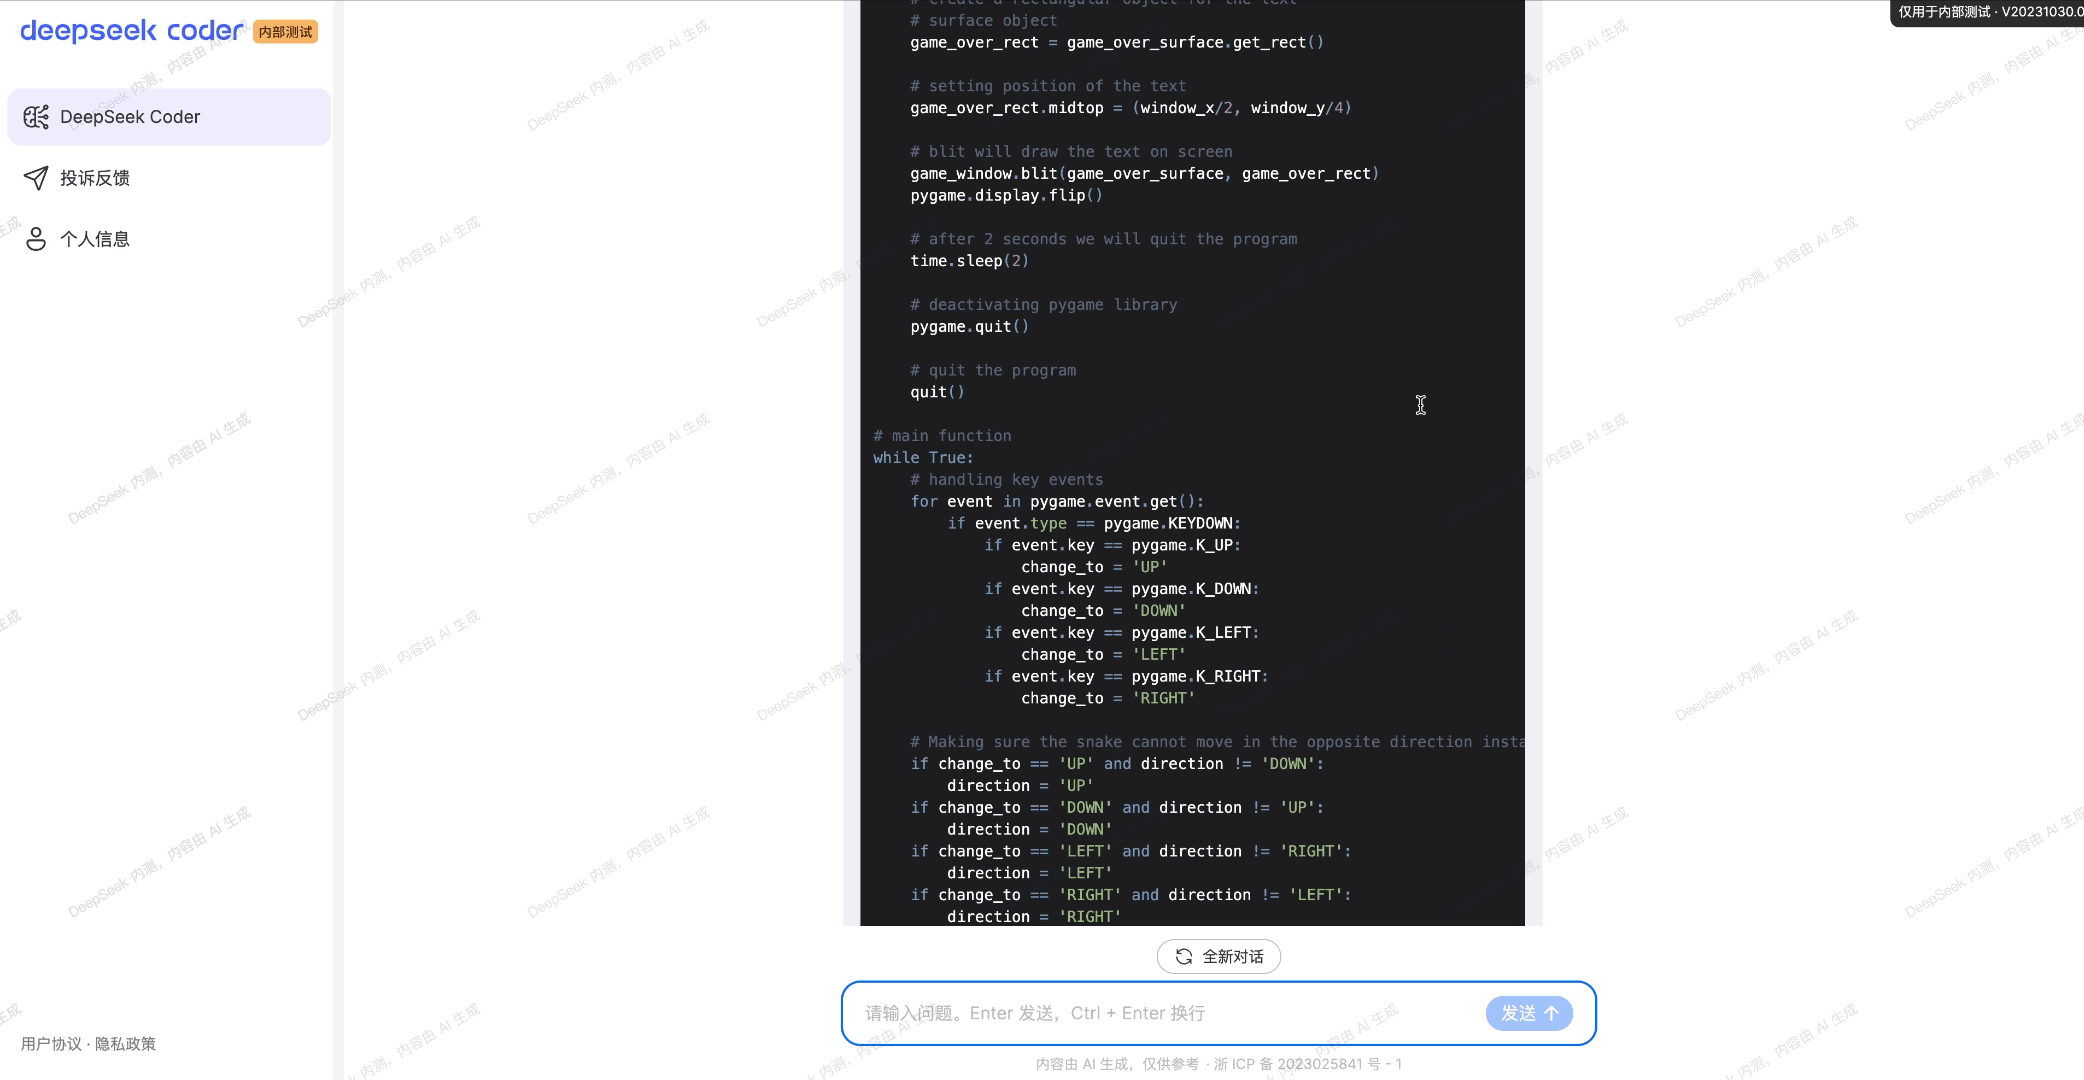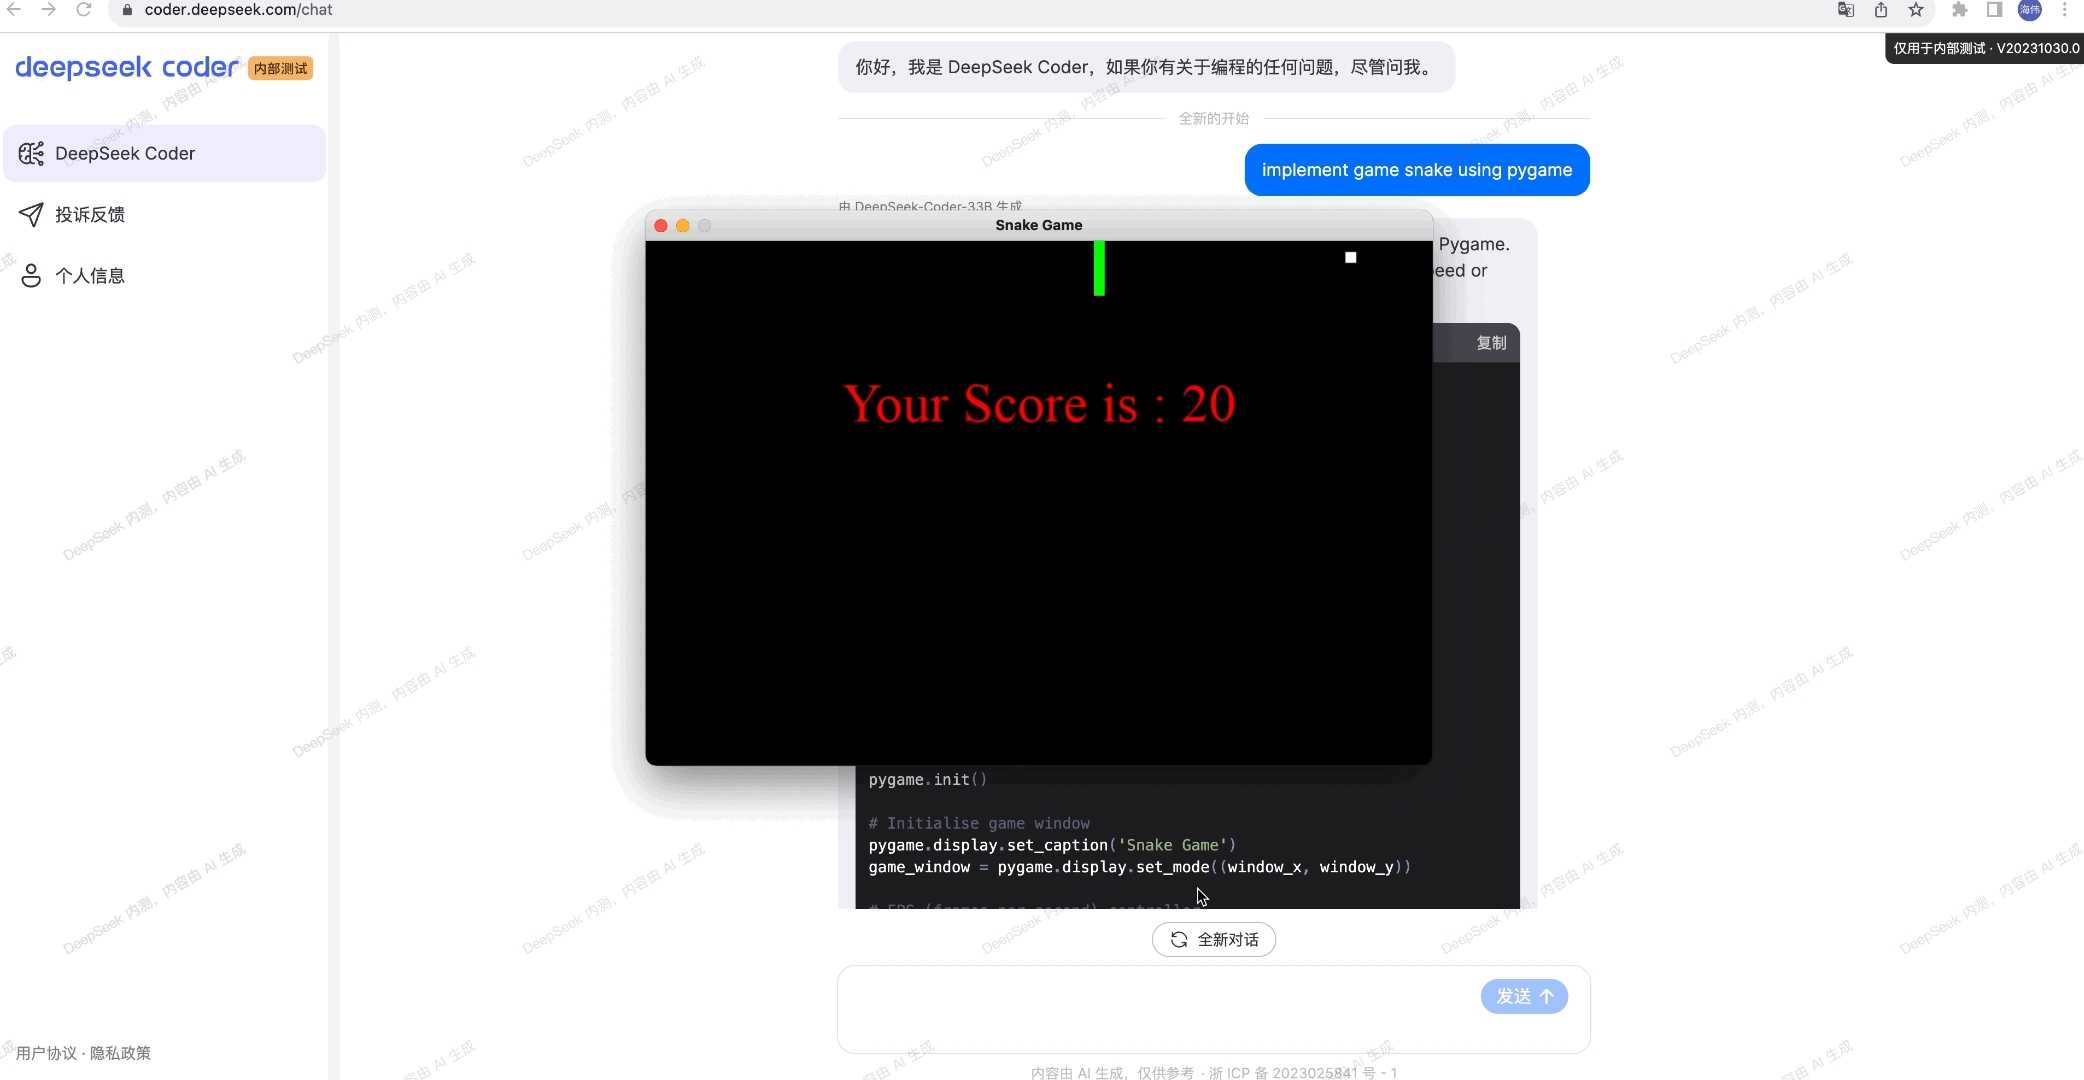
DeepSeek Coder peut être largement utilisé dans le développement logiciel, l'analyse de données, les tests automatisés et d'autres domaines. Il est non seulement capable de générer du code, mais peut également répondre à des questions liées à la programmation, aidant ainsi les développeurs à améliorer leur efficacité au travail.
Grâce à ses innovations technologiques (comme l'architecture MoE et l'entraînement FIM) et à son écosystème open source, DeepSeek Coder redéfinit les limites de performance des modèles de génération de code. Son excellent rapport qualité-prix, sa prise en charge multilingue et sa capacité à traiter du code au niveau du projet en font un outil central pour améliorer l'efficacité des développeurs, tout en favorisant la collaboration et les progrès de la communauté open source IA mondiale. Avec le lancement futur de modèles multimodaux et à plus grande échelle, DeepSeek pourrait devenir une référence dans le domaine de la génération de code à l'ère de l'AGI.
Dépôt GitHub :https://github.com/deepseek-ai/DeepSeek-Coder












