Assistant scénario▸
 Apps AI
 Actualités AI
Firecrawl Extract : récupérez n'importe quelle donnée web avec une simple requête
Firecrawl Extract : récupérez n'importe quelle donnée web avec une simple requêteIntroduction
Firecrawl Extract combine la puissance des grands modèles de langage (LLM) pour extraire intelligemment des données à partir du contenu web, en les convertissant dans des formats adaptés à un traitement ultérieur, tels que Markdown ou des données JSON structurées. Cela est particulièrement adapté aux scénarios nécessitant de grandes quantités de données web pour entraîner des modèles d'IA ou réaliser de l'analyse de données.
Principales caractéristiques de Firecrawl Extract :
Extraction intelligente : en définissant un schéma d'extraction de données ou en utilisant un JSON Schema, les utilisateurs peuvent spécifier la structure de données souhaitée. Firecrawl Extract récupérera et analysera automatiquement les données en fonction de ces instructions.
Aucun codage requis : les utilisateurs peuvent effectuer l'extraction de données via de simples appels API ou une interface graphique, sans avoir à écrire de code de爬 (scraping) complexe.
Gestion du contenu dynamique : même si le site web utilise JavaScript pour charger du contenu de manière dynamique, Firecrawl peut capturer ces données, garantissant ainsi l'exhaustivité des données.
Extraction à grande échelle : prend en charge l'extraction simultanée de plusieurs URL, adapté aux projets nécessitant de grandes quantités de données.
Intégration API et SDK : fournit un SDK Python, un SDK Node, etc., facilitant l'intégration de la fonctionnalité Firecrawl Extract dans les applications des développeurs.
Assistance LLM : exploite les LLM pour comprendre le contexte de la page web et identifier et extraire plus précisément les informations clés à partir de données non structurées.
Facilité d'utilisation : le processus d'extraction de données peut être lancé via une simple commande ou un appel, comme dans l'exemple d'appel API fourni.
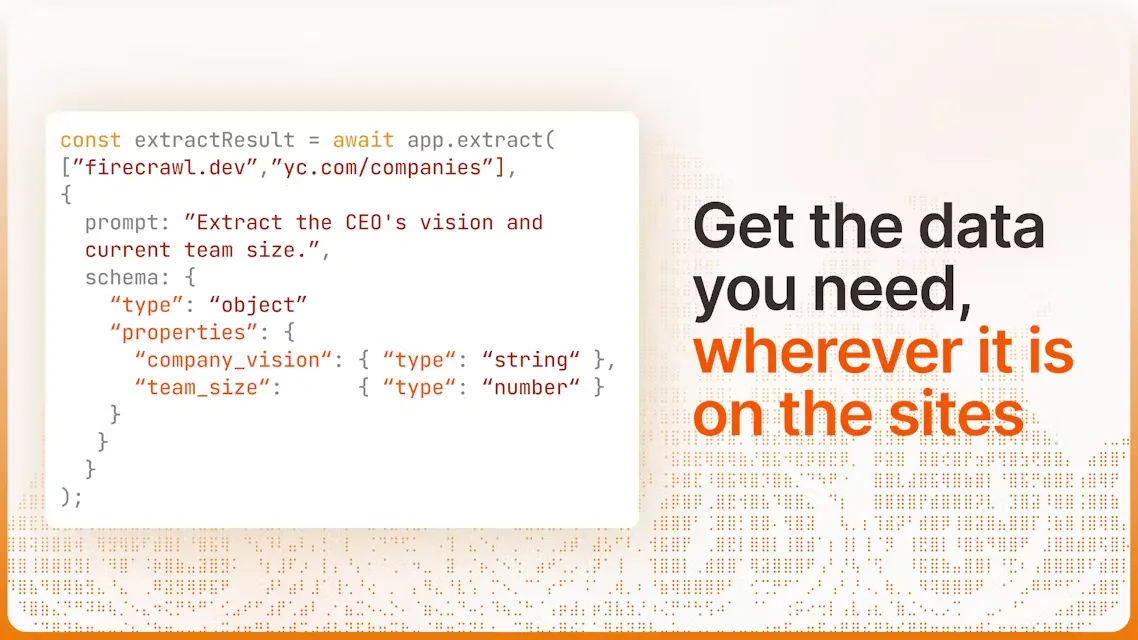
Étapes d'utilisation de Firecrawl Extract :
1. Définir les besoins en données : précisez clairement quelles données vous souhaitez extraire des pages web et préparez le schéma de données correspondant ou utilisez un modèle prédéfini.
2. Appel API ou intégration SDK :
Lors de l'utilisation de l'API, construisez la requête en spécifiant l'URL cible et le schéma d'extraction des données.
Si vous utilisez le SDK Python, initialisez l'objet FirecrawlApp et appelez la méthode d'extraction correspondante, en passant l'URL et les instructions d'extraction.
Exemple de code (SDK Python) :
from firecrawl.firecrawl import FirecrawlApp
app = FirecrawlApp(api_key="YOUR_API_KEY")
result = app.extract([ '你的网站地址URL'], {
prompt: "提取特定数据",
schema: { /* 定义你的数据结构 */ }
})
3. Obtenir les résultats : une fois l'extraction terminée, Firecrawl renvoie les données traitées, qui peuvent être directement utilisées pour l'analyse de données ultérieure ou l'entraînement de modèles.
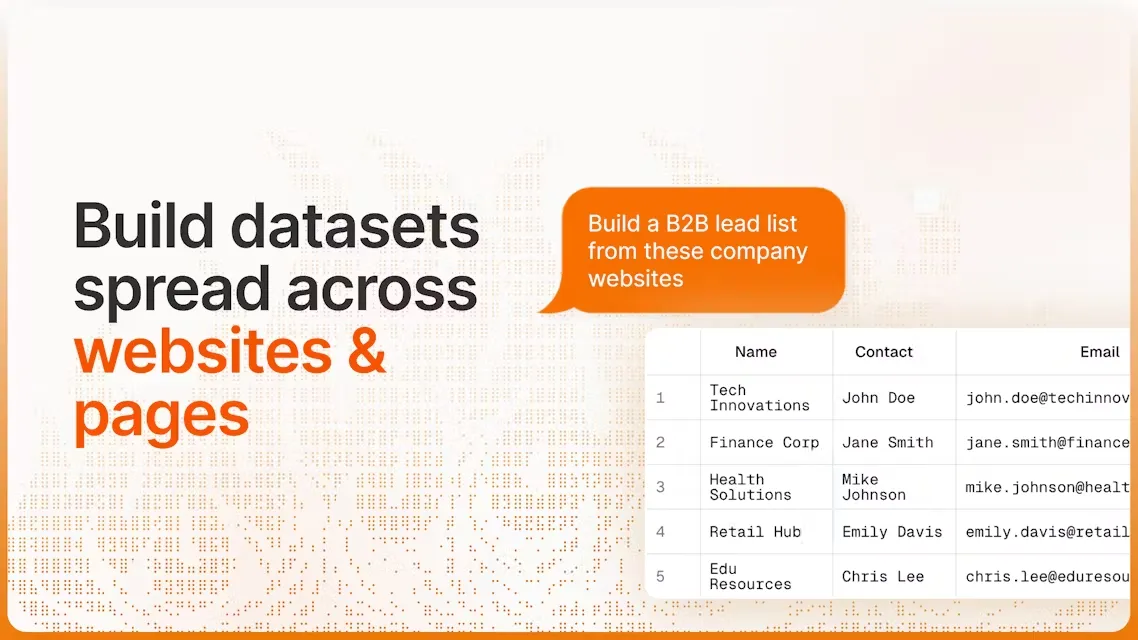
Scénarios d'application de Firecrawl Extract :
Firecrawl convient à divers scénarios d'application, tels que l'enrichissement des informations sur les prospects, l'automatisation KYB et les flux de travail sans code. Les services fournis par Firecrawl permettent de convertir facilement et efficacement les données des sites web dans un format adapté à l'utilisation par les grands modèles de langage (LLM) :
Entraînement de modèles d'IA : fournir des données d'entraînement riches pour les grands modèles de langage.
Agrégation de contenu : construire rapidement des résumés de contenu ou des services d'agrégation d'actualités.
Analyse de marché : extraire les prix ou les informations produits des sites web des concurrents.
Recherche de données : collecter des données publiques sur le web pour la recherche académique ou commerciale.
Le point de terminaison /extract de Firecrawl est un outil puissant, capable d'extraire des données structurées à partir de n'importe quel site web. Les utilisateurs peuvent obtenir les données souhaitées via un simple appel API, sans avoir à effectuer de scraping manuel. Grâce à la fonctionnalité Extract de Firecrawl, les utilisateurs peuvent facilement relever les défis courants du scraping web, tels que les proxies furtifs, les limites de débit, etc., garantissant ainsi le bon déroulement de l'extraction des données.