
 Assistant scénario▸
 Apps AI
 Actualités AI

ExtractPDF : extrayez images, texte et polices de vos fichiers PDF
ExtractPDF : extrayez images, texte et polices de vos fichiers PDFIntroduction
ExtractPDF est un outil en ligne spécialement conçu pour extraire du texte et des images à partir de fichiers PDF. Aucun logiciel ni plugin n'est nécessaire : les utilisateurs peuvent utiliser ses fonctionnalités directement dans le navigateur. Le site propose une interface simple et facile à utiliser, permettant une extraction rapide et efficace des informations souhaitées.
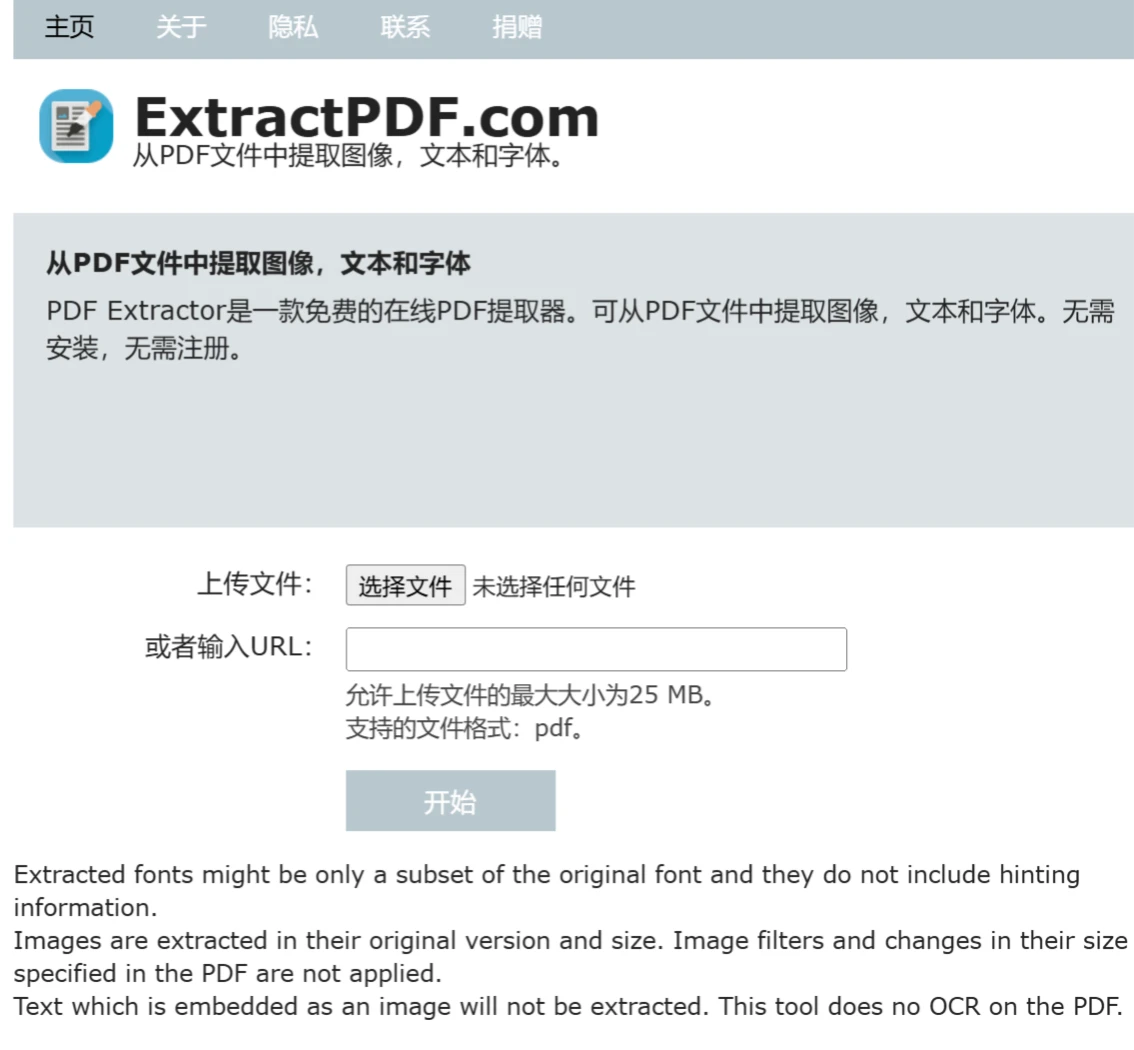
Fonctionnalités d'ExtractPDF :
Extraction de texte : permet d'extraire le contenu en texte brut d'un fichier PDF.
Extraction d'images : permet d'extraire les images d'un fichier PDF ; l'utilisateur peut choisir d'enregistrer une ou plusieurs images.
Prise en charge linguistique : ExtractPDF prend en charge la reconnaissance de texte dans plusieurs langues, notamment l'anglais, le chinois, le japonais, etc.
Utilisation d'ExtractPDF :
L'utilisation est très simple : il suffit de télécharger un fichier PDF ou de saisir l'URL d'un PDF, puis de soumettre,
Accéder au site : ouvrez votre navigateur et rendez-vous sur le site officiel d'ExtractPDF.
Télécharger un fichier PDF : téléchargez un fichier PDF ou saisissez l'URL d'un PDF (ExtractPDF autorise le téléchargement de fichiers d'une taille maximale de 25 Mo, dans le format de fichier pdf).
Démarrer l'extraction : cliquez sur le bouton « Démarrer », ExtractPDF commencera alors à traiter le fichier et à extraire le contenu souhaité.
Télécharger les résultats : une fois l'extraction terminée, les utilisateurs peuvent télécharger directement le texte et les images extraits.
Avantages d'ExtractPDF :
Aucune installation requise : les utilisateurs n'ont pas besoin de télécharger de logiciel, un navigateur suffit.
Prise en charge multilingue : ExtractPDF prend en charge de nombreuses langues, y compris le chinois.
Remarques :
Les polices extraites peuvent n'être qu'un sous-ensemble de la police d'origine et ne contiennent pas d'informations de crénage (hinting).
Les images sont extraites dans leur version et leur taille d'origine. Les filtres d'image spécifiés dans le PDF, ainsi que les modifications de taille, ne seront pas appliqués.
Le texte intégré en tant qu'image ne sera pas extrait. Cet outil n'effectue pas d'OCR sur les PDF.
Questions fréquentes sur ExtractPDF :
1. Pourquoi les images extraites apparaissent-elles différentes de celles du fichier PDF ?
Cet outil extrait les images d'origine du fichier PDF. Les traitements d'image effectués dans le PDF, tels que le recadrage, la rotation ou l'inversion des couleurs, seront ignorés.
2. Pourquoi certaines glyphes sont-ils manquants dans les polices extraites du fichier PDF ?
Lorsqu'une police est intégrée dans un fichier PDF, celui-ci ne contient que les glyphes des caractères qui apparaissent. Si votre fichier PDF ne contient pas la lettre « P », le fichier de police extrait ne contiendra pas non plus la lettre « P ».
3. Pourquoi la mise en page semble-t-elle étrange lors de l'utilisation des fichiers de polices extraits du PDF ?
Les fichiers PDF ne contiennent généralement pas de fichiers de spécifications de police (fichiers .pfm ou .afm), car les lecteurs PDF n'en ont pas besoin. L'absence de fichiers de spécifications de police empêchera l'utilisation normale des fichiers de polices extraits.
4. Est-il légal d'extraire des fichiers de polices d'un PDF ?
Extraire des fichiers de polices d'un PDF est légal. Cependant, si vous souhaitez utiliser les fichiers de polices extraits, vous devez obtenir l'autorisation du créateur de la police.
Cependant, en raison de l'absence de données de métriques de police, les fichiers de polices extraits ne peuvent généralement pas être utilisés directement. Ils servent principalement à aider à identifier les polices utilisées dans le fichier PDF.
Si vous décidez d'utiliser les polices extraites d'un fichier PDF, vous devez être conscient des risques juridiques liés à leur utilisation.













