
 Assistant scénario▸
 Apps AI
 Actualités AI
ChatTTS-Forge : outil TTS tout-en-un
ChatTTS-Forge : outil TTS tout-en-unIntroduction
ChatTTS-Forge est un projet développé autour d'un modèle de génération TTS, offrant aux utilisateurs des capacités flexibles de génération TTS. Il prend en charge plusieurs voix, le contrôle du style, l'inférence de longs textes, et bien d'autres fonctionnalités. ChatTTS-Forge fournit diverses API (interfaces de programmation d'applications), que les développeurs peuvent utiliser directement pour convertir facilement du texte en parole.
ChatTTS-Forge est un projet développé autour d'un modèle de génération TTS (texte vers parole). Il offre aux utilisateurs des capacités flexibles de génération TTS, prenant en charge plusieurs voix, le contrôle du style, l'inférence de longs textes, et bien d'autres fonctionnalités.
ChatTTS-Forge fournit diverses API (interfaces de programmation d'applications) que les développeurs peuvent utiliser directement pour convertir facilement du texte en parole. De plus, il propose une interface web (WebUI) facile à utiliser, permettant aux utilisateurs de saisir du texte directement sur une page web et de générer de la parole sans programmation.
Principales caractéristiques de ChatTTS-Forge :
Génération TTS : prend en charge l'inférence de plusieurs modèles TTS, notamment ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS, etc. Les utilisateurs peuvent librement choisir et changer de voix.
Gestion des voix : intègre plusieurs voix prédéfinies et permet de télécharger des voix personnalisées. Les utilisateurs peuvent créer et utiliser des sonneries personnalisées en téléchargeant des fichiers audio ou du texte.
Contrôle du style : offre plusieurs options de contrôle du style, notamment le réglage de la vitesse, de la hauteur et du volume de la voix, ainsi que l'ajout d'un amplificateur vocal (Enhancer) pour améliorer la qualité de sortie.
Traitement des longs textes : prend en charge la segmentation automatique et l'inférence de textes très longs, permettant de générer du contenu audio à partir de longs textes.
Prise en charge de SSML : utilise la syntaxe SSML, similaire à XML, pour un contrôle avancé de la synthèse TTS, adaptée aux scénarios de génération vocale plus détaillés.
ASR (Reconnaissance Automatique de la Parole) : intègre le modèle Whisper, prenant en charge la conversion de la parole en texte.
Technologies et méthodes de ChatTTS-Forge :
Serveur API : un serveur API écrit en Python fournit un service TTS efficace, prenant en charge plusieurs requêtes simultanées et une configuration personnalisée.
WebUI : une interface utilisateur basée sur Gradio, permettant aux utilisateurs de découvrir les fonctionnalités TTS via une interface simple.
Prise en charge de Docker : fournit des options de déploiement conteneurisé avec Docker pour simplifier le processus de déploiement en local et sur serveur.
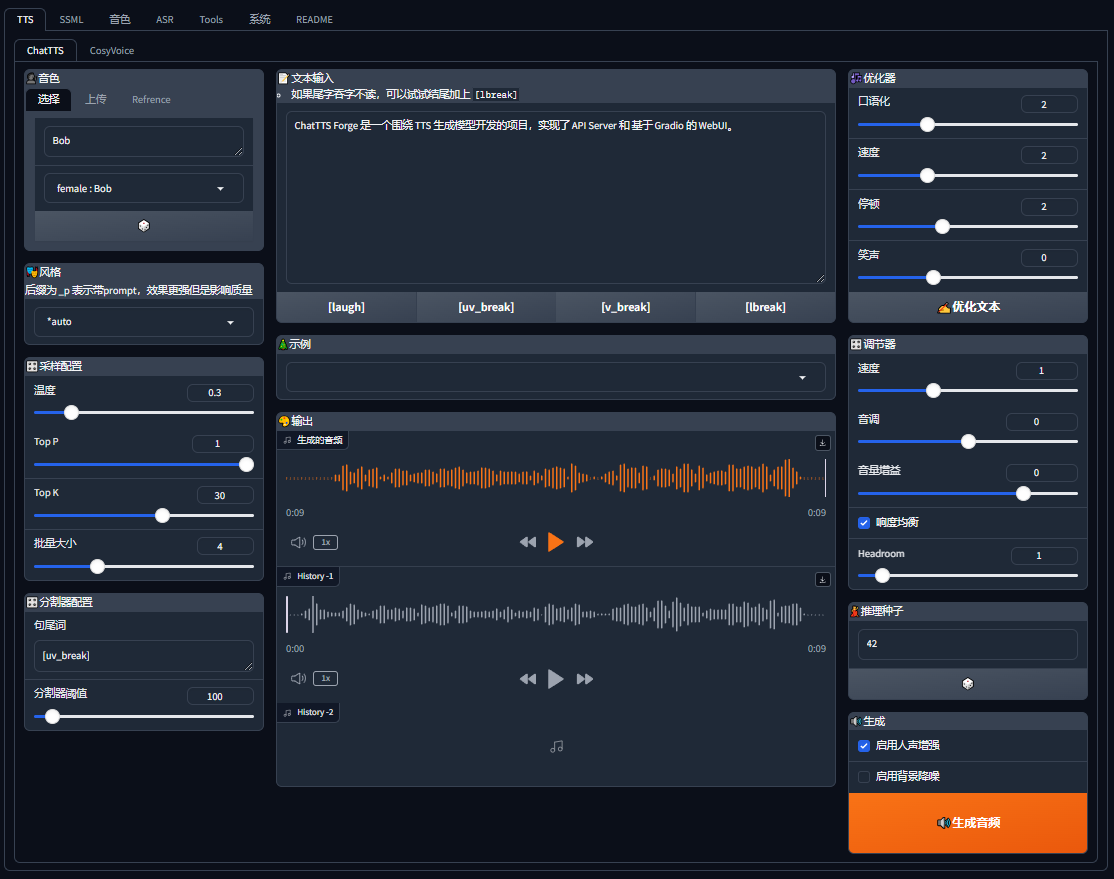
Caractéristiques de ChatTTS-Forge WebUI :
TTS (texte vers parole) : via la WebUI, les utilisateurs peuvent saisir du texte et générer de la parole à l'aide de différents modèles TTS.
Changement de voix : prend en charge le basculement entre plusieurs voix prédéfinies, permettant aux utilisateurs de choisir différentes voix pour générer la parole.
Téléchargement de voix personnalisées : les utilisateurs peuvent télécharger leurs propres fichiers vocaux pour générer en temps réel une voix personnalisée.
Contrôle du style : il est possible d'ajuster le style de la voix, notamment la vitesse, la hauteur et le volume, afin de produire une voix répondant à des besoins spécifiques.
Traitement des longs textes : prend en charge le traitement de très longs textes en les divisant automatiquement en petits segments et en générant la parole séquentiellement, ce qui est adapté à la création de contenus audio longs.
Traitement par lots : les utilisateurs peuvent définir la taille du lot pour améliorer la vitesse d'inférence des longs textes.
Raffineur : cet outil permet d'affiner le texte afin d'optimiser la parole générée, particulièrement utile pour traiter des textes de longueur illimitée.
Amélioration vocale : intègre un modèle d'amélioration pour augmenter la qualité de la voix générée et la rendre plus naturelle.
Historique de génération : conserve les 3 derniers résultats générés, facilitant la comparaison des effets vocaux selon différents réglages.
Prise en charge multi-modèles : la WebUI prend en charge plusieurs modèles TTS, notamment ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS, etc. Les utilisateurs peuvent choisir le modèle adapté à leurs besoins.
Prise en charge de SSML : utilise la syntaxe SSML, similaire à XML, pour contrôler le processus de synthèse vocale, adaptée aux scénarios nécessitant un contrôle plus complexe.
Outil de podcast : aide les utilisateurs à créer du contenu audio long format et multi-personnages à partir de scripts de blog.
Génération de sous-titres : crée des scripts SSML à partir de fichiers de sous-titres pour générer divers contenus vocaux.
GitHub : https://github.com/lenML/ChatTTS-Forge
Expérience en ligne : https://huggingface.co/spaces/lenML/ChatTTS-Forge














