
 Assistant scénario▸
 Apps AI
 Actualités AI
CosyVoice : voix naturelle semblable à celle d'un humain
CosyVoice : voix naturelle semblable à celle d'un humainIntroduction
CosyVoice est un grand modèle de génération vocale basé sur le codage quantifié de la voix, une nouvelle technologie de synthèse vocale qui permet une fusion approfondie de la compréhension textuelle et de la génération vocale. Il discrétise la voix et s'appuie sur la technologie des grands modèles pour offrir une expérience de génération vocale naturelle et fluide. Par rapport aux technologies traditionnelles de génération vocale, CosyVoice est capable d'analyser et d'interpréter avec précision divers contenus textuels, en les transformant en une voix naturelle semblable à celle d'une vraie personne.
Il vous suffit de fournir 3 à 10 secondes d'audio original, et CosyVoice peut générer une voix simulée, incluant même des détails tels que le rythme et l'émotion, ainsi que la génération vocale multilingue.
Site officiel du projet CosyVoice :https://www.modelscope.cn/studios/iic/CosyVoice-300M
Adresse du code source de CosyVoice :https://github.com/FunAudioLLM/CosyVoice
Adresse de l'API CosyVoice :https://help.aliyun.com/zh/model-studio/developer-reference/cosvoice-large-model-for-speech-synthesis/?spm=a2c4g.11186623.0.0.56f01751Ke29mh
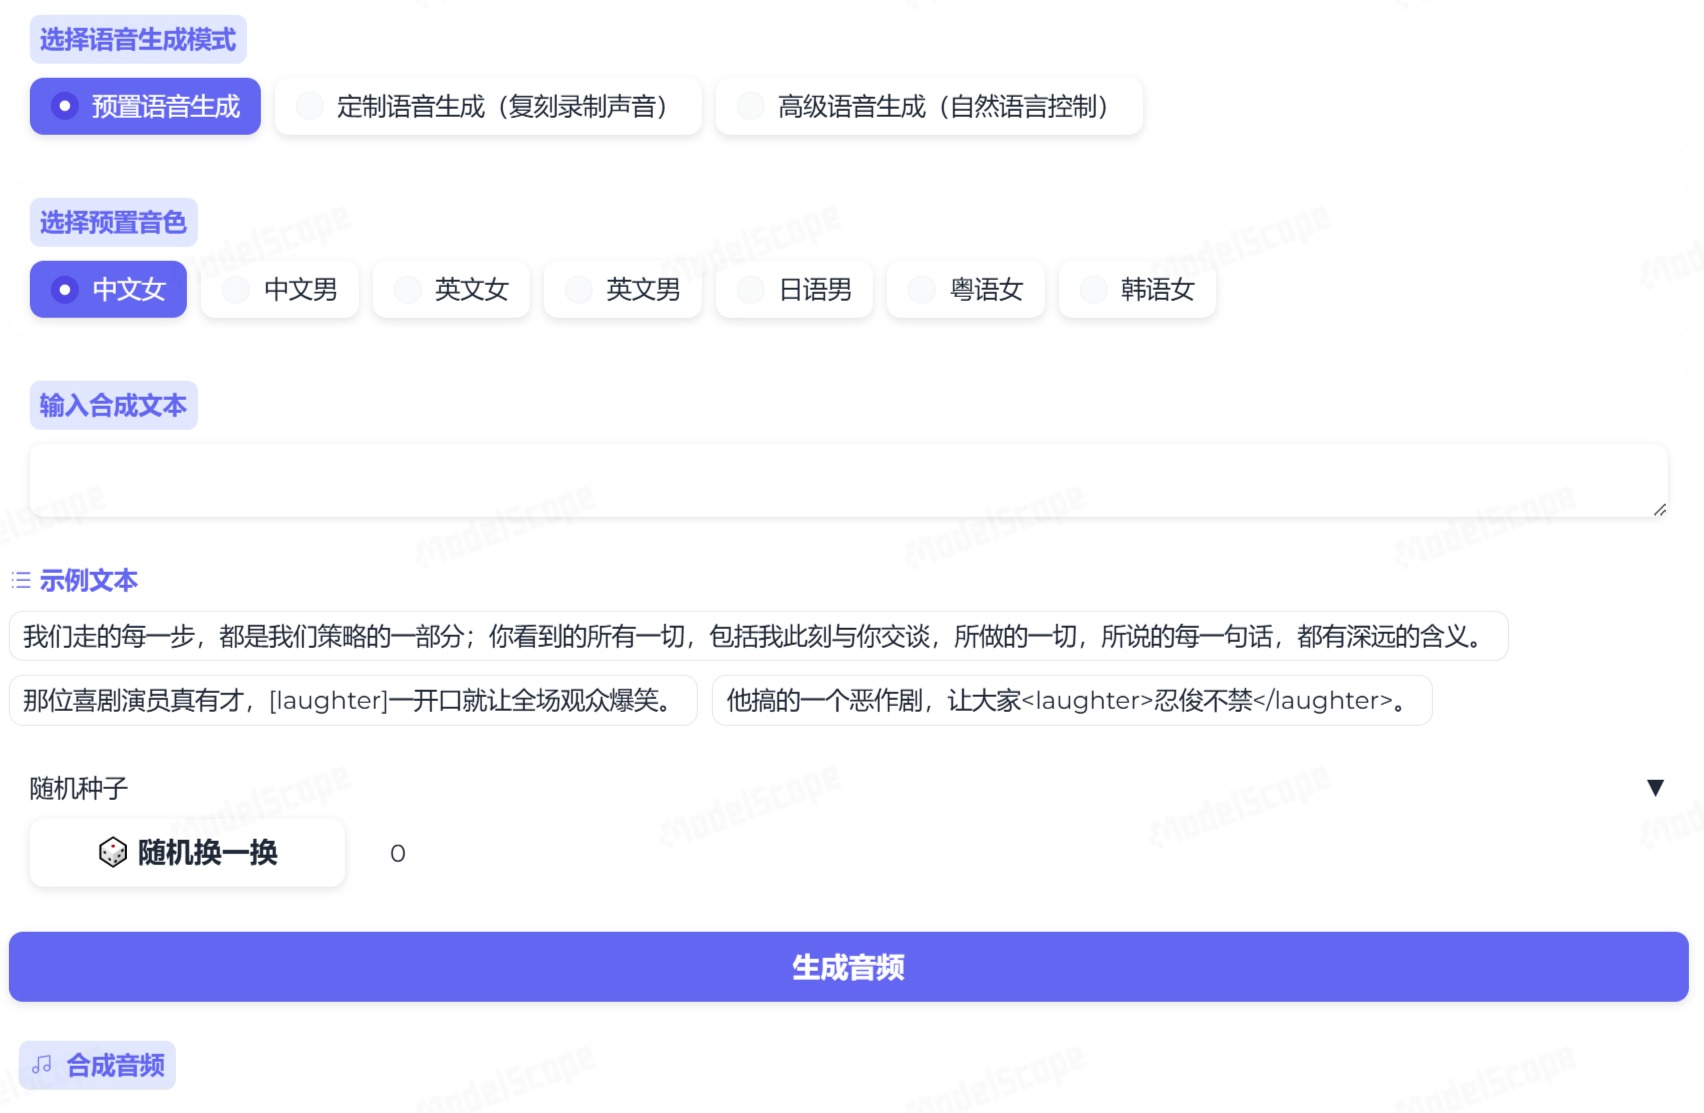
Caractéristiques et fonctions de CosyVoice :
Hautement anthropomorphique : adopte l'algorithme de grand modèle vocal neuronal génératif CosyVoice développé en interne par le laboratoire vocal Tongyi d'Alibaba, permettant à la voix générée d'atteindre un degré d'anthropomorphisme exceptionnel en termes d'intonation, de rythme et d'expression émotionnelle.
Multilingue : CosyVoice prend en charge la génération en 5 langues : chinois, anglais, japonais, cantonais et coréen. Il se concentre sur la génération vocale naturelle, prend en charge le contrôle multilingue, de la tonalité et des émotions, et offre des performances nettement supérieures à celles des modèles traditionnels de génération vocale.
Choix varié de voix : fournit une vaste bibliothèque de ressources vocales de haute qualité, incluant différents sexes, âges, dialectes et diverses voix caractéristiques, afin de répondre aux besoins personnalisés des utilisateurs dans différents scénarios. Qu'il s'agisse de la gravité d'un journal d'information ou de la richesse émotionnelle d'un récit, tout est facilement maîtrisé.
Synthèse en temps réel et efficace : le système offre une excellente vitesse de réponse et des capacités de synthèse vocale en flux continu, permettant une synthèse vocale rapide et précise en temps réel, qu'il s'agisse de longs documents ou de courtes instructions.
Contrôle des émotions et du rythme : CosyVoice prend en charge la génération de voix hautement anthropomorphique avec des événements sonores linguistiques riches et de multiples émotions, tels que des rires, des interjections, etc., ainsi que la génération de voix hautement expressive avec différentes émotions.
Clonage vocal : il suffit de fournir 3 à 10 secondes d'audio original pour que CosyVoice clone et génère une voix simulée, incluant même des détails tels que le rythme et l'émotion, ainsi que la génération vocale multilingue.
Applications de CosyVoice :
CosyVoice convient à de nombreux scénarios d'application, tels que le service client intelligent, les livres audio, la navigation embarquée, le soutien éducatif, etc.
Contenu vocal pour les appareils intelligents/robots, tels que les robots de service client intelligents, les enceintes intelligentes, les humains numériques, les assistants vocaux, etc.
Scénarios de création audio et vidéo nécessitant la conversion de texte en parole, tels que la lecture de romans, les journaux d'information, les commentaires cinématographiques, le doublage de scénarios, etc.
CosyVoice élargit considérablement les possibilités de l'interaction vocale, améliore l'expérience utilisateur tout en offrant un soutien puissant à la transformation intelligente des entreprises.
Comparé à ChatTTS, qui fait beaucoup parler de lui récemment, on peut constater que la synthèse audio de CosyVoice présente une meilleure cohérence du contenu. CosyVoice assure un contrôle fin des émotions et du rythme de la voix générée, améliorant nettement l'expressivité émotionnelle de l'audio, avec très peu de cas d'hallucinations générant des mots supplémentaires. CosyVoice modélise parfaitement les informations sémantiques du texte synthétisé, surpassant les performances humaines en termes de cohérence du contenu et de similarité avec le locuteur.














