
 Assistant scénario▸
 Apps AI
 Actualités AI
ToucanTTS : grand modèle multilingue couvrant plus de 7 000 langues
ToucanTTS : grand modèle multilingue couvrant plus de 7 000 languesIntroduction
ToucanTTS, une boîte à outils pour la synthèse vocale à la pointe de la technologie, est un modèle complet de synthèse texte-à-parole (Text-to-Speech, TTS) développé par l'Institut de traitement du langage naturel (IMS) de l'Université de Stuttgart. ToucanTTS couvre un grand modèle multilingue prenant en charge plus de 7 000 langues.
ToucanTTS ne se contente pas de prendre en charge plusieurs langues, il offre également une fonctionnalité de synthèse vocale multi-locuteurs, capable d'imiter le rythme, l'accentuation et l'intonation de différents locuteurs.
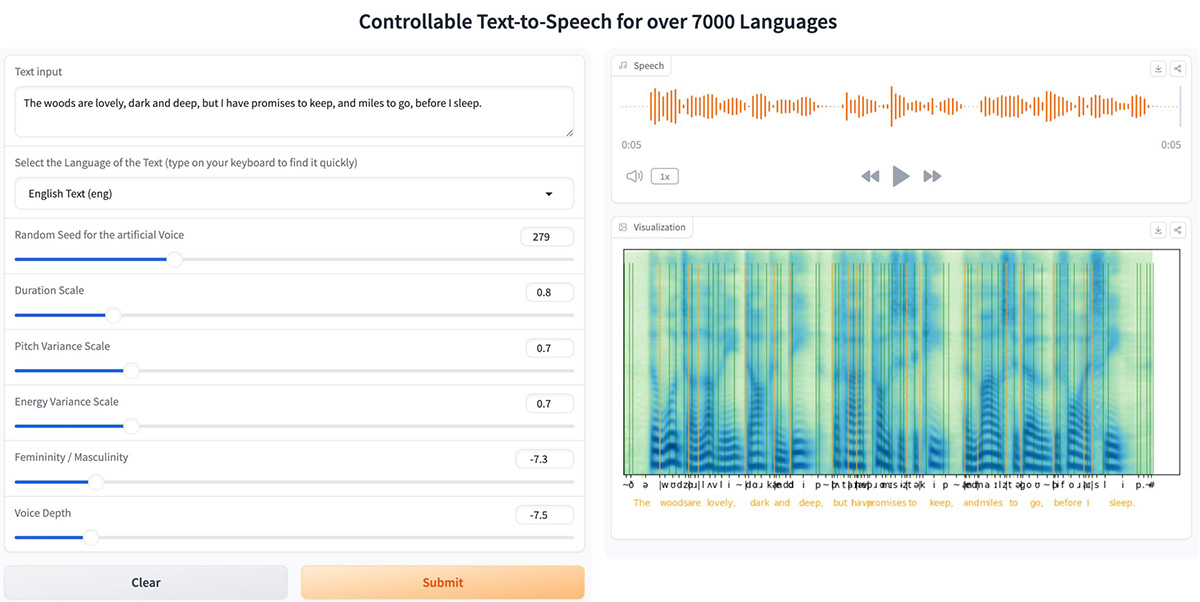
Il propose également des démonstrations interactives pour diverses applications, notamment la conception vocale, le clonage de style, la synthèse vocale multilingue et la lecture de poésie éditée manuellement, démontrant ainsi sa polyvalence et ses performances robustes.
Fonctionnalités de ToucanTTS :
Support multilingue : ToucanTTS est capable de synthétiser la parole dans plus de 7 000 langues, ce qui en fait le modèle TTS disponible couvrant le plus grand nombre de langues. Ce vaste support linguistique s'adresse à un large public international.
Synthèse vocale multi-locuteurs : ToucanTTS prend en charge la synthèse vocale multi-locuteurs, permettant aux utilisateurs d'imiter le rythme, l'accentuation et l'intonation de différents locuteurs. C'est particulièrement utile pour les applications nécessitant une diversité stylistique et une personnalisation vocale.
Édition collaborative homme-machine : ToucanTTS permet aux utilisateurs de personnaliser la parole synthétisée pour répondre à des exigences spécifiques, ce qui est particulièrement utile pour la recherche littéraire et les travaux de lecture poétique.
Architecture : ToucanTTS est construit sur l'architecture FastSpeech 2, avec des améliorations inspirées de PortaSpeech. Il inclut un PostNet basé sur des flux de normalisation et un aligneur autonome entraîné via la classification temporelle connexionniste (CTC) et la reconstruction de spectrogrammes, permettant une synthèse vocale de haute qualité et naturelle.
Représentation articulatoire : Une fonctionnalité unique de ToucanTTS est l'utilisation de la représentation articulatoire des phonèmes en entrée. Cela permet d'exploiter les données multilingues pour améliorer la qualité et la disponibilité de la synthèse vocale pour les langues à faibles ressources.
Démonstrations interactives : ToucanTTS propose des démonstrations interactives pour diverses applications, telles que la conception vocale, le clonage de style, la synthèse vocale multilingue et la lecture de poésie éditée manuellement. Ces démonstrations mettent en valeur la polyvalence et la robustesse de la boîte à outils.
Entraînement et inférence : La boîte à outils fournit des instructions complètes pour l'installation des dépendances, la configuration du stockage, le téléchargement des modèles pré-entraînés et l'exécution du pipeline d'entraînement. Elle prend en charge le fine-tuning à partir de modèles pré-entraînés ainsi que l'entraînement à partir de zéro.
Caractéristiques de ToucanTTS :
Support multilingue et multi-locuteurs : Grâce à un modèle pré-entraîné multilingue à grande échelle, il prend en charge la synthèse vocale multilingue couvrant plus de 7 000 langues. Il permet la synthèse vocale multi-locuteurs et clone la prosodie telle que le rythme, l'accentuation et l'intonation entre les locuteurs.
Édition collaborative homme-machine : Permet l'édition collaborative homme-machine de la parole synthétisée, par exemple pour la récitation de poésie et la recherche littéraire.
Démonstrations interactives : Fournit des démonstrations interactives de synthèse vocale multilingue à grande échelle, de clonage de style inter-locuteurs, de conception vocale et de récitation de poésie éditée manuellement.
Architecture et composants : Principalement basé sur l'architecture FastSpeech 2, avec quelques modifications, telles qu'un PostNet basé sur des flux de normalisation inspiré de PortaSpeech. Comprend un aligneur autonome entraîné via CTC et la reconstruction de spectrogrammes pour diverses applications. Fournit des modèles pré-entraînés pour le modèle multilingue, l'aligneur, la fonction d'embedding, le vocodeur et l'embedding GAN.
Facilité d'utilisation : Entièrement construit en Python et PyTorch, conçu pour être simple et adapté aux débutants, tout en étant puissant.
Représentation articulatoire : Le système IMS Toucan prend en entrée la représentation articulatoire des phonèmes, permettant aux données multilingues de bénéficier aux langues à faibles ressources.
Applications de ToucanTTS :
Synthèse vocale pour les applications multilingues : ToucanTTS prend en charge plus de 7 000 langues, ce qui est très avantageux pour créer des applications multilingues, telles que les plateformes de service client mondiales, les outils éducatifs et les fonctionnalités d'accessibilité pour les personnes non natives.
Conception et personnalisation vocales : La fonctionnalité de synthèse vocale multi-locuteurs permet de créer des voix personnalisées utilisables dans diverses applications, telles que les assistants virtuels, les livres audio et les messages marketing personnalisés.
Édition collaborative homme-machine : Cette fonctionnalité est particulièrement utile dans la recherche littéraire et les travaux de lecture poétique, où un contrôle précis de la sortie vocale est nécessaire pour répondre à des exigences stylistiques spécifiques.
Comment utiliser ToucanTTS ?
Quelques étapes simples suffisent pour commencer à utiliser ToucanTTS.
1. Télécharger depuis GitHub
Téléchargez le code depuis GitHub. git clone https://github.com/2noise/ToucanTTS pour télécharger ToucanTTS
2. Installer les dépendances
Avant de commencer, assurez-vous que les packages requis sont installés. Vous aurez besoin de torch et ToucanTTS. S'ils ne sont pas encore installés, vous pouvez les installer avec pip :
3. Importer les bibliothèques nécessaires
Importez les bibliothèques nécessaires pour votre script. Vous aurez besoin de torch, ToucanTTS et Audio depuis IPython.display.
4. Initialiser ToucanTTS, créez une instance de la classe ToucanTTS et chargez le modèle pré-entraîné.
5. Préparez le texte, définissez le texte à convertir en parole. Remplacez <YOUR TEXT HERE> par le texte souhaité.
6. Générez la parole, utilisez la méthode infer pour générer la parole à partir du texte. Définissez use_decoder=True pour activer le décodeur.
7. Lire l'audio
Utilisez la classe Audio d'IPython.display pour lire l'audio généré. Définissez la fréquence d'échantillonnage sur 24 000 Hz et activez la lecture automatique.
8. Finaliser le script
Lien GitHub de ToucanTTS : https://github.com/DigitalPhonetics/IMS-Toucan
Lien de démonstration en ligne : https://huggingface.co/spaces/Flux9665/MassivelyMultilingualTTS
Lien du jeu de données : https://huggingface.co/datasets/Flux9665/BibleMMS














