
 Assistant scénario▸
 Apps AI
 Actualités AI
Etna : modèle AIGC de génération vidéo à partir de texte
Etna : modèle AIGC de génération vidéo à partir de texteIntroduction
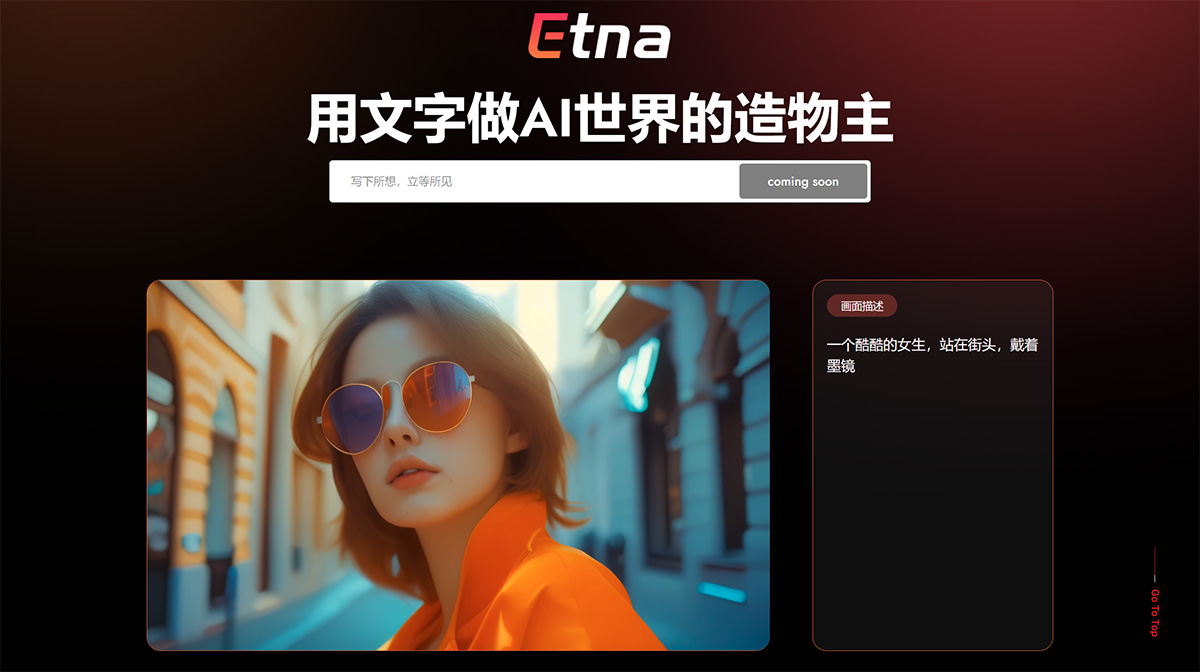
Le modèle Etna est un logiciel avancé de conversion de texte en vidéo développé par Seven Volcanoes Technology, qui mène des recherches et des applications approfondies dans les domaines du traitement du langage naturel, des réseaux antagonistes génératifs et de la vision par ordinateur.
Le modèle Etna adopte la toute dernière architecture de réseau neuronal, fusionnant habilement les capacités de compréhension sémantique du modèle Transformer et la stratégie de génération de contenu du modèle Diffusion, permettant ainsi une conversion efficace du texte en vidéo. Ce modèle prend en charge la génération de vidéos d'une durée de 8 à 15 secondes, avec une fluidité extrêmement élevée pouvant atteindre 60 images par seconde.
Caractéristiques techniques du modèle Etna :
Utilisation de la toute dernière architecture de réseau neuronal
Fusion des capacités de compréhension sémantique du modèle Transformer et de la stratégie de génération de contenu du modèle Diffusion
Prise en charge de la conversion efficace du texte en vidéo
Scénarios d'application du modèle Etna :
Les scénarios d'application du modèle Etna sont très variés, incluant, sans s'y limiter, la création de contenu vidéo, le développement de jeux, l'art et le divertissement, ainsi que l'éducation et la formation.
Création de contenu vidéo : films, animations, publicités et plateformes de médias sociaux
Développement de jeux : création d'animations et de scènes dans les jeux
Art et divertissement : création d'œuvres d'art visuel uniques
Éducation et formation : production de vidéos éducatives pour améliorer l'intérêt et l'efficacité de l'apprentissage
Ces scénarios d'application démontrent le large potentiel d'application et la capacité d'innovation du modèle Etna dans différents domaines.
FAQ sur le modèle Etna :
Que peut faire Etna ?
Le modèle Etna (Etna) de Seven Volcanoes Technology est un modèle texte-vers-vidéo aiGC, capable de générer du contenu vidéo correspondant à partir de brèves descriptions textuelles.
Quelle architecture technique Etna adopte-t-il ?
Le réseau principal actuel du modèle Etna utilise l'architecture Diffusion, tout en expérimentant et en adaptant une architecture Diffusion+Transform similaire à celle de Sora sur un ensemble de données plus volumineux.
Quel est le principe technique d'Etna ?
Le modèle Etna insère des convolutions spatio-temporelles et des couches d'attention entre le modèle de langage et le modèle d'image, lui permettant de traiter des données vidéo, c'est-à-dire de prendre en compte la continuité temporelle dans les séquences d'images. Cela signifie qu'Etna possède une certaine capacité de compréhension spatio-temporelle, lui permettant de comprendre et de générer du contenu vidéo avec une dimension temporelle.
Comment Etna entraîne-t-il son modèle ?
Le modèle Etna est pleinement entraîné sur un vaste ensemble de données vidéo, en utilisant des stratégies avancées de technologie deep-learning, incluant l'entraînement大规模 LDS, l'optimisation complexe des hyperparamètres HPO et le fine-tuning DPO, garantissant ainsi les performances puissantes et la capacité de génération du modèle.
Le modèle Etna, en tant que réalisation importante de Seven Volcanoes Technology dans le domaine de la technologie vidéo IA, réalise une conversion efficace du texte en vidéo de haute qualité grâce à la combinaison de la toute dernière architecture de réseau neuronal et de stratégies techniques avancées, démontrant un large éventail de scénarios d'application et un potentiel commercial.











