
 Assistant scénario▸
 Apps AI
 Actualités AI
CogVideo : générer des vidéos à partir de descriptions textuelles
CogVideo : générer des vidéos à partir de descriptions textuellesIntroduction
CogVideo est actuellement le plus grand modèle de pré-entraînement de génération de vidéo à partir de texte dans le domaine général, avec 9,4 milliards de paramètres. CogVideo exploite efficacement le modèle de pré-entraînement de génération d'images à partir de texte (CogView2) pour en faire un modèle de génération de vidéo à partir de texte, et utilise une stratégie d'entraînement hiérarchique multi-fréquences d'images.
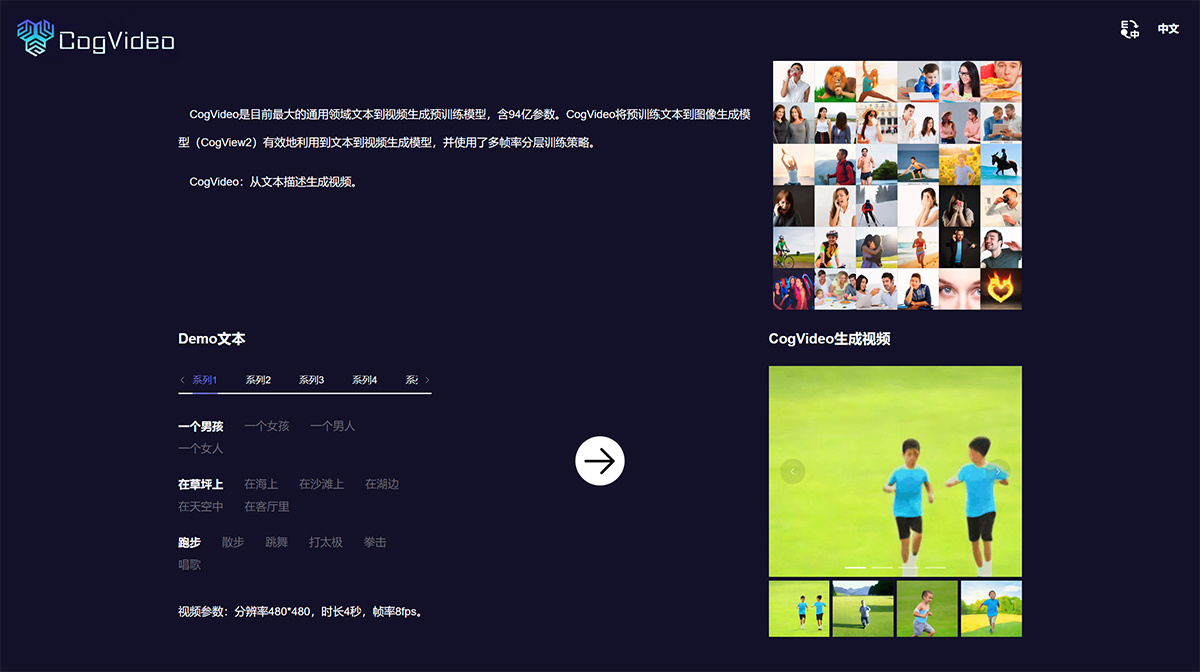
CogVideo est un modèle open source de génération de vidéo à partir de texte en pré-entraînement proposé par l'équipe de Tang Jie de l'Université Tsinghua et de BAai, qui a suscité une large attention sur GitHub. Sa technologie de base repose sur des algorithmes d'apprentissage profond et une architecture de modèle, capables de transformer des descriptions textuelles en contenus vidéo vivants et réalistes.
CogVideo adopte une stratégie d'entraînement hiérarchique multi-fréquences d'images et, en héritant du modèle pré-entraîné de génération texte-image (CogView), permet une conversion efficace du texte vers la vidéo. De plus, CogVideo dispose d'une fonctionnalité avancée de construction de scènes dynamiques, capable de générer des environnements 3D et des animations à partir des descriptions textuelles détaillées fournies par l'utilisateur. Parallèlement, CogVideo permet un réglage fin efficace du pré-entraînement texte-à-image pour la génération texte-à-vidéo, évitant ainsi le coût prohibitif d'un pré-entraînement complet à partir de zéro.
L'entraînement de CogVideo repose principalement sur un cadre de génération hiérarchique multi-images : il génère d'abord plusieurs images à partir du texte d'entrée via CogView2, puis augmente la fréquence d'images par interpolation pour compléter la séquence vidéo globale. Cette stratégie d'entraînement confère à CogVideo la capacité de contrôler l'intensité des variations au cours du processus de génération, contribuant à un meilleur alignement entre la sémantique du texte et celle de la vidéo. Le modèle utilise 9,4 milliards de paramètres et compte parmi les plus grands modèles de pré-entraînement de génération de vidéo à partir de texte dans le domaine général.
CogVideo prend non seulement en charge la saisie en chinois, mais fournit également une documentation et des tutoriels détaillés, facilitant son utilisation et sa personnalisation par les chercheurs et les développeurs. Son caractère open source et sa facilité d'utilisation lui confèrent une valeur applicative importante dans le domaine de la compréhension vidéo multimodale. De plus, l'émergence de CogVideo marque une avancée majeure de l'IA dans le domaine de la génération vidéo, offrant un espace d'imagination révolutionnaire pour la création future.
En résumé, CogVideo, en tant que puissant modèle de génération de vidéo à partir de texte, est capable d'exploiter efficacement des modèles pré-entraînés pour produire des vidéos de haute qualité. Cependant, le processus de génération vidéo se heurte encore à certains défis, notamment la rareté et la faible corrélation des jeux de données texte-vidéo, qui entravent la capacité du modèle à comprendre les sémantiques de mouvements complexes — autant de problèmes qui nécessitent des recherches et des améliorations supplémentaires.















