
 Assistant scénario▸
 Apps AI
 Actualités AI
DiffusionGPT : système de génération d'images à partir de texte alimenté par un LLM
DiffusionGPT : système de génération d'images à partir de texte alimenté par un LLMIntroduction
DiffusionGPT4 est un système tout-en-un de génération d'images à partir de texte, piloté par un LLM, développé par ByteDance, spécialement conçu pour générer des images de haute qualité à partir de différentes invites d'entrée. Son objectif principal est d'analyser l'invite d'entrée et de déterminer le modèle génératif qui produit les meilleurs résultats, un modèle caractérisé par une grande généralisation, une grande efficacité et une grande commodité.
Ce qui rend DiffusionGPT si impressionnant, c'est qu'il intègre plusieurs modèles experts de génération d'images issus de domaines variés. Il utilise ensuite un LLM pour interfacer ces modèles de génération d'images, laissant le LLM traiter et comprendre diverses invites textuelles. Enfin, en fonction des informations comprises, il sélectionne le modèle d'image le plus approprié pour générer l'image. C'est ainsi que, tout comme GPT-4, il dessine via la conversation...
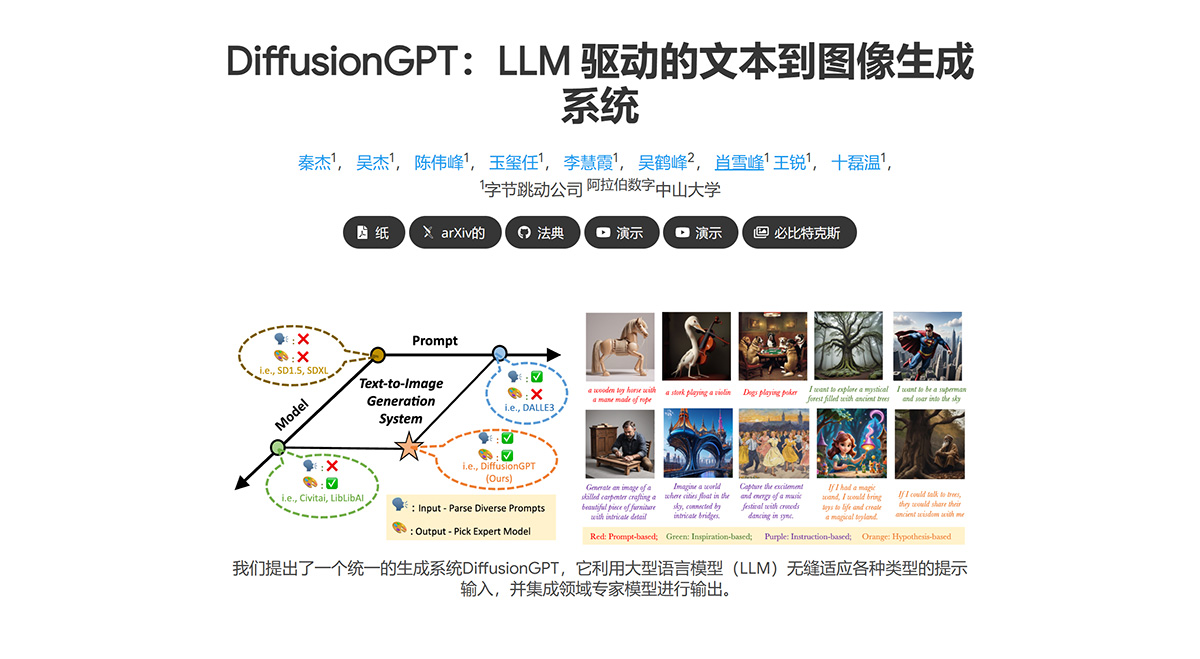
Principales caractéristiques de DiffusionGPT :
1. Traitement diversifié des invites textuelles : DiffusionGPT est capable de comprendre et de traiter divers types d'invites textuelles, y compris des instructions concrètes, des inspirations abstraites, des hypothèses complexes, etc.
2. Intégration de plusieurs modèles experts spécialisés : le système intègre plusieurs modèles de diffusion d'images spécialisés dans divers domaines, chaque modèle possédant des capacités expertes de génération d'images dans son domaine spécifique. Ces modèles se concentrent sur la génération d'images dans des domaines précis, comme les paysages naturels, les portraits de personnes, les œuvres d'art, etc.
Cela signifie que le système est non seulement capable de générer des images ordinaires, mais aussi de gérer des tâches de génération d'images plus spécifiques et complexes, comme un style ou un type d'image particulier, en imitant le style d'un artiste spécifique, le style bande dessinée ou des techniques photographiques.
3. Piloté par un grand modèle de langage : DiffusionGPT utilise un grand modèle de langage (LLM) pour analyser et comprendre les invites textuelles saisies par l'utilisateur. Ce processus est similaire à la façon dont d'autres systèmes basés sur LLM (comme GPT-4) traitent le texte, mais il est spécifiquement appliqué à la compréhension des instructions et des descriptions destinées à la génération d'images.
4. Sélection intelligente du modèle d'image approprié : sur la base de sa compréhension de l'invite textuelle, DiffusionGPT4 est capable de sélectionner intelligemment le modèle de génération d'images le plus approprié pour générer l'image. Cela inclut non seulement le choix du bon modèle, mais aussi l'ajustement des paramètres de génération afin de répondre au mieux aux besoins de l'utilisateur.
5. Sortie d'images de haute qualité : en associant précisément les invites textuelles au meilleur modèle génératif, Diffusion2024 peut générer des images de haute qualité qui correspondent étroitement aux besoins de l'utilisateur.
6. Base de données des préférences et des retours utilisateurs : en combinant les retours des utilisateurs et une base de données des préférences, le système peut ajuster la sélection des modèles en fonction des préférences des utilisateurs, améliorant ainsi la pertinence et la qualité de la génération d'images.
Par exemple : lors des premières utilisations du système, les utilisateurs peuvent fournir des retours sur les images générées, comme « les couleurs de cette image sont trop sombres ». DiffusionGPT4 utilise ces retours pour ajuster sa sélection de modèles, rendant les futures générations d'images plus conformes aux préférences des utilisateurs.
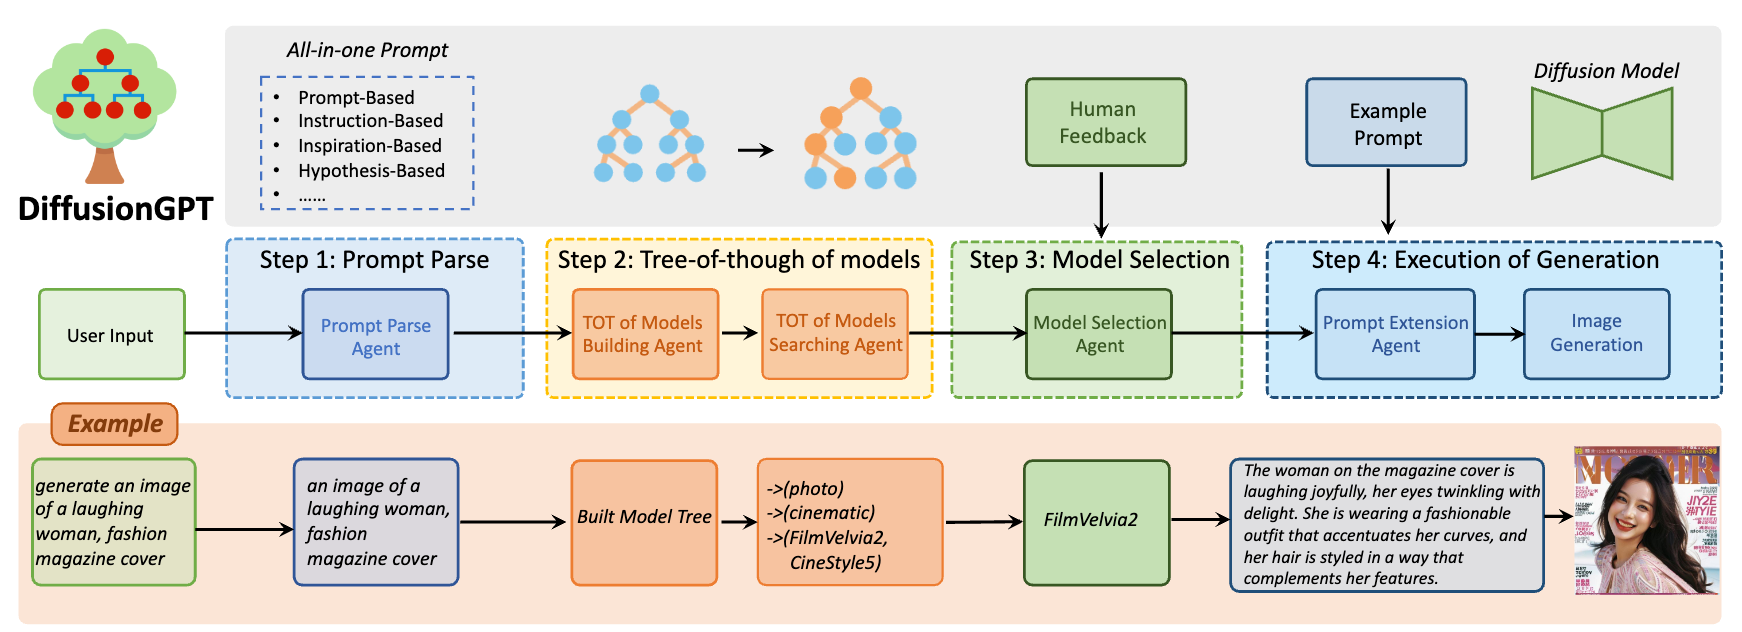
Principe de fonctionnement principal de DiffusionGPT :
1. Analyse de l'entrée : l'utilisateur fournit une invite textuelle, telle qu'une description, une instruction ou une inspiration.
Le grand modèle de langage (LLM) est chargé d'analyser ces invites textuelles, d'en comprendre le sens et les besoins.
2. Construction d'un arbre de pensées (Tree-of-Thought) : en fonction des différentes tâches de génération d'images, le système construit un « arbre de pensées », une structure organisant les différents modèles de génération d'images.
L'arbre de pensées repose sur des connaissances a priori et les retours humains, et couvre des modèles experts dans divers domaines.
3. Sélection du modèle : en fonction du résultat de l'analyse par le LLM, le système utilise l'arbre de pensées pour déterminer le modèle de génération d'images le plus adapté à l'invite textuelle en cours. Lors du processus de sélection, les préférences de l'utilisateur et les retours historiques, stockés dans la base de données des préférences, peuvent également être pris en compte.
4. Génération de l'image : une fois le modèle approprié sélectionné, celui-ci est utilisé pour générer l'image. L'image générée sera étroitement liée à l'invite textuelle d'entrée et reflétera l'intention et les préférences de l'utilisateur.
5. Sortie du résultat : l'image finalement générée est présentée à l'utilisateur.
Ces images peuvent être diversifiées, incluant, sans s'y limiter, des scènes décrites précisément, des œuvres d'art conceptuelles ou des images correspondant à un style particulier.
6. Processus d'optimisation par les retours utilisateurs :
Les retours des utilisateurs sur les images générées servent à enrichir la base de données des préférences, aidant ainsi le système à mieux comprendre les préférences des utilisateurs et à optimiser la sélection de modèles ainsi que la génération d'images ultérieures.
Diffusion2024 fait preuve d'un haut degré de réalisme et de détail dans la génération d'images de catégories telles que les humains et les scènes.Par rapport aux modèles de référence (comme SD1.5), les images générées par DiffusionGPT présentent une amélioration notable en termes de fidélité visuelle et de capture des détails.DiffusionGPT obtient de meilleurs résultats que les modèles de diffusion stable traditionnels en termes de récompense d'image et de scores esthétiques.Lors de l'évaluation quantitative de la qualité de génération d'images, DiffusionGPT affiche des scores élevés, ce qui indique que les images qu'il génère sont préférées en termes de qualité et d'esthétique.














