
 Assistant scénario▸
 Apps AI
 Actualités AI
Audio2Photoreal : générer des personnages virtuels réalistes à partir de l'audio
Audio2Photoreal : générer des personnages virtuels réalistes à partir de l'audioIntroduction
Meta aia récemment publié une technologie révolutionnaire : Audio2PhotoReal, qui génère des avatars de personnages virtuels réalistes de tout le corps à partir de l'audio.Elle peut générer, à partir de la voix de conversations à plusieurs, des expressions faciales réalistes correspondant à la conversation, ainsi que des mouvements complets du corps et des gestes des mains.
Ces personnages virtuels générés sont non seulement visuellement réalistes, mais aussi capables de refléter fidèlement les détails des gestes et des expressions de la conversation, tels que pointer du doigt, secouer le poignet, hausser les épaules, sourire, se moquer, etc.
Principe de fonctionnement d'Audio2PhotoReal :
Audio2PhotoReal combine les avantages de la diversité des échantillons quantifiés vectoriellement et des détails haute fréquence obtenus par diffusion, afin de générer des mouvements plus dynamiques et expressifs.
1. Capture des données : tout d'abord, un ensemble riche de données de conversations à deux est capturé, permettant une reconstruction réaliste.
2. Construction du modèle de mouvement : le projet construit un modèle de mouvement composite comprenant un modèle de mouvement facial, un prédicteur de pose de guidage et un modèle de mouvement corporel.
3. Génération des mouvements faciaux : un régresseur de lèvres pré-entraîné est utilisé pour traiter l'audio et extraire les caractéristiques liées aux mouvements faciaux.
Un modèle de diffusion conditionnelle est utilisé pour générer les mouvements faciaux à partir de ces caractéristiques.
4. Génération des mouvements corporels : à partir de l'audio en entrée, une pose de guidage quantifiée vectoriellement (VQ) à raison d'une image par seconde est produite de manière auto-régressive. L'audio et la pose de guidage sont ensuite injectés dans un modèle de diffusion, qui génère des mouvements corporels haute fréquence à une vitesse de 30 images/seconde.
5. Rendu du personnage virtuel : les mouvements faciaux et corporels générés sont transmis à un rendu de personnage virtuel entraîné, produisant ainsi un personnage virtuel réaliste.
6. Présentation des résultats : le résultat final est un personnage virtuel réaliste de tout le corps, généré à partir de l'audio, capable d'exprimer les expressions subtiles et les gestes de la conversation.
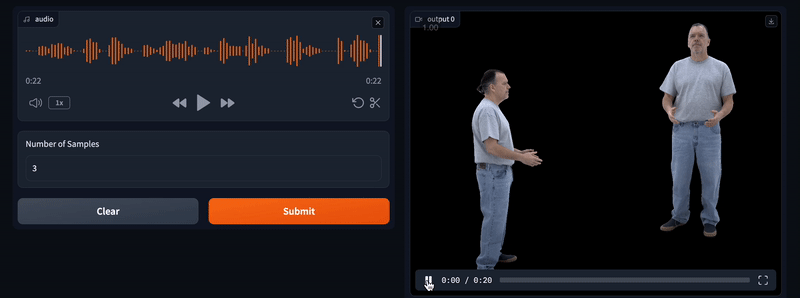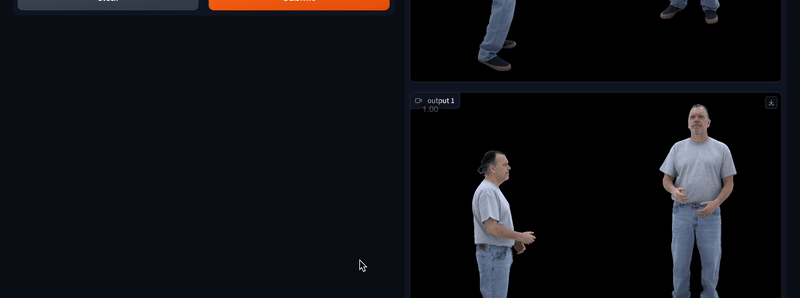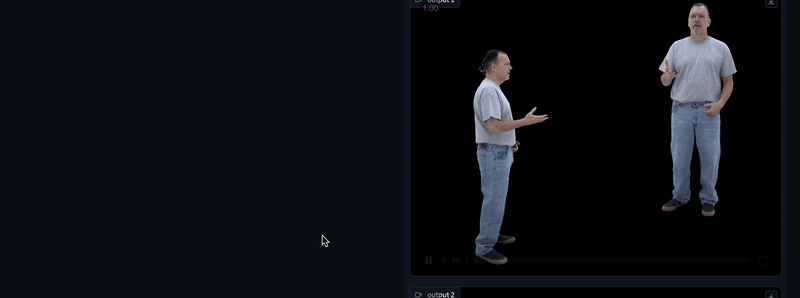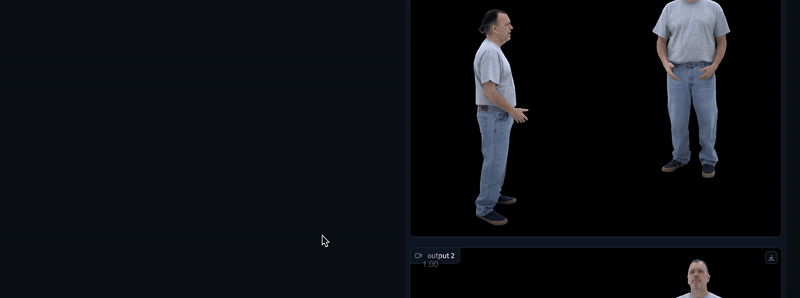
Adresse du projet Audio2Photoreal :https://github.com/facebookresearch/audio2photoreal/
Adresse de l'article Audio2Photoreal :https://arxiv.org/pdf/2401.01885.pdf














