
 Assistant scénario▸
 Apps AI
 Actualités AI
DreamTalk : framework open source pour faire parler des photos de personnes
DreamTalk : framework open source pour faire parler des photos de personnesIntroduction
DreamTalk, un cadre développé conjointement par l'Université Tsinghua, Alibaba et l'Université des sciences et technologies de Huazhong, basé sur un modèle de diffusion, permettant de faire parler des portraits de personnes. Il prend en charge divers sons, notamment des chansons, des voix dans plusieurs langues et des audio bruyants, pour faire parler les avatars.
Adresse de démonstration de DreamTalk :https://dreamtalk-project.github.io
Adresse du projet DreamTalk :https://dreamtalk-project.github.io/
Adresse de l'article DreamTalk :https://arxiv.org/abs/2312.09767
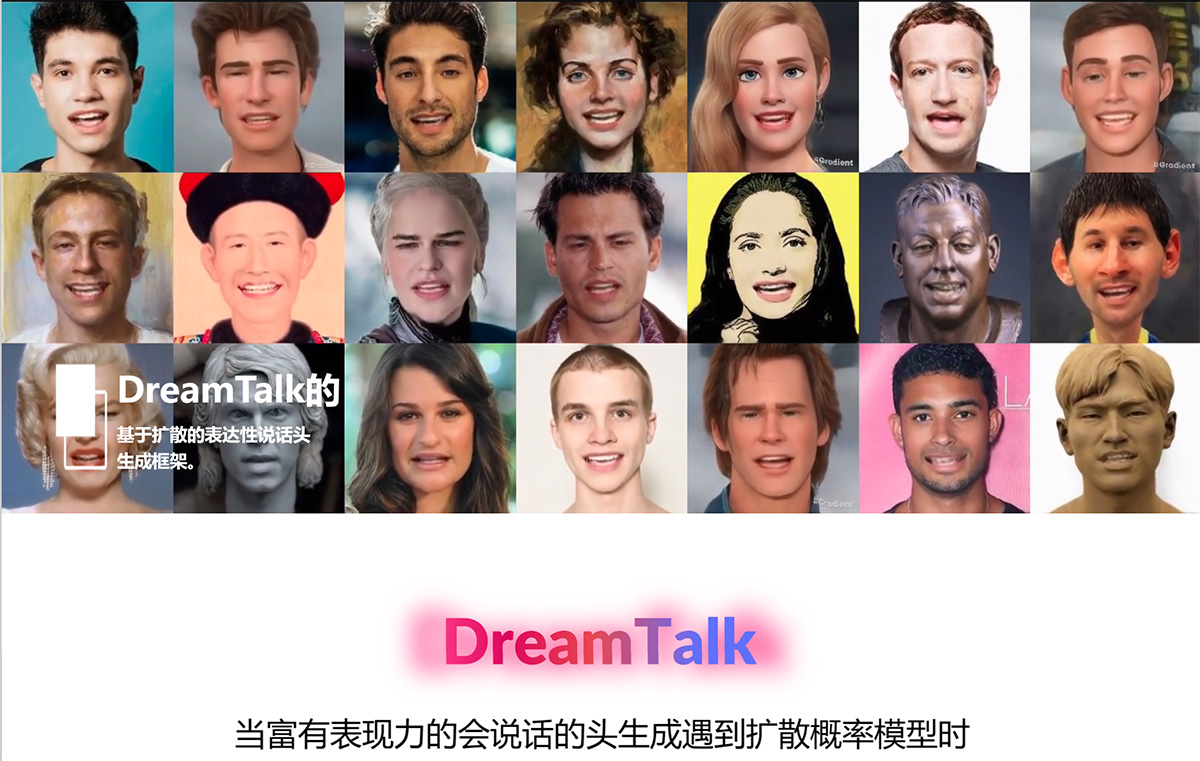
Scénarios d'utilisation de DreamTalk :
Utiliser DreamTalk pour générer des visages parlants avec des langues et des styles d'expression variés
Appliquer DreamTalk dans la production cinématographique et télévisuelle pour obtenir des expressions et mouvements réalistes de personnages virtuels
Utiliser DreamTalk dans des scénarios d'interaction homme-machine pour obtenir des expressions faciales et des mouvements des lèvres naturels
Fonctionnalités de DreamTalk :
Concrètement, DreamTalk se compose de trois composants clés : un réseau de débruitage, un expert des lèvres sensible au style et un prédicteur de style. Le réseau de débruitage basé sur la diffusion est capable de synthétiser de manière cohérente des mouvements faciaux de haute qualité pilotés par l'audio, dans différentes expressions. Pour améliorer l'expressivité et la précision des mouvements des lèvres, nous avons introduit un expert des lèvres sensible au style, capable de guider la synchronisation labiale tout en tenant compte du style de parole. Afin d'éliminer le besoin de vidéo ou de texte de référence d'expression, un prédicteur de style supplémentaire basé sur la diffusion est utilisé pour prédire directement l'expression cible à partir de l'audio.
1. Réseau de débruitage : c'est l'un des composants principaux, responsable de la génération des mouvements faciaux pilotés par l'audio. Le réseau de débruitage utilise un modèle de diffusion pour éliminer progressivement le bruit, générant ainsi des expressions faciales claires et de haute qualité. Ce processus consiste à restaurer progressivement des mouvements faciaux clairs à partir de données bruitées.
2. Expert des lèvres sensible au style : ce composant se concentre sur l'amélioration de l'expressivité et de la précision des mouvements des lèvres. Il analyse le style de parole pour guider la synchronisation labiale, garantissant que l'animation générée est à la fois naturelle et conforme au style du locuteur.
3. Prédicteur de style : afin d'éliminer la dépendance à l'égard de vidéos ou de textes de référence d'expression, DreamTalk introduit un prédicteur de style basé sur la diffusion. Ce prédicteur peut prédire directement l'expression cible à partir de l'audio, sans nécessiter de vidéo ou de texte de référence d'expression supplémentaire.
4. Traitement audio et vidéo : traitement de l'entrée audio, extraction des caractéristiques audio clés et utilisation de ces caractéristiques pour piloter l'animation faciale. Parallèlement, il peut également traiter l'entrée vidéo afin d'extraire et d'imiter des expressions et styles spécifiques.
5. Données et entraînement du modèle : pour mettre en œuvre ces fonctionnalités, DreamTalk nécessite une grande quantité de données pour entraîner son modèle, notamment des données d'animation faciale couvrant différentes expressions et styles de parole. Grâce à ces données, le modèle apprend à générer avec précision des mouvements faciaux correspondant à l'audio d'entrée.
DreamTalk peut exploiter un puissant modèle de diffusion pour générer efficacement des visages expressifs, tout en réduisant la dépendance à l'égard de coûteuses références de style. Les résultats expérimentaux montrent que DreamTalk est capable de générer des visages parlants réalistes avec différents styles de parole et d'obtenir des mouvements des lèvres précis, surpassant les produits de pointe existants de la même catégorie.
DreamTalk est non seulement capable de traiter et de générer les types de visages et expressions qu'il a vus lors de l'entraînement, mais aussi de traiter et de générer efficacement des types de visages et expressions provenant de différents ensembles de données, qu'il n'avait jamais vus auparavant.
Y compris des portraits de personnes de différentes ethnies, âges et sexes, ainsi que diverses expressions et émotions.














