
 Assistant scénario▸
 Apps AI
 Actualités AI
DreaMoving : framework de génération de vidéos humaines basé sur la diffusion
DreaMoving : framework de génération de vidéos humaines basé sur la diffusionIntroduction
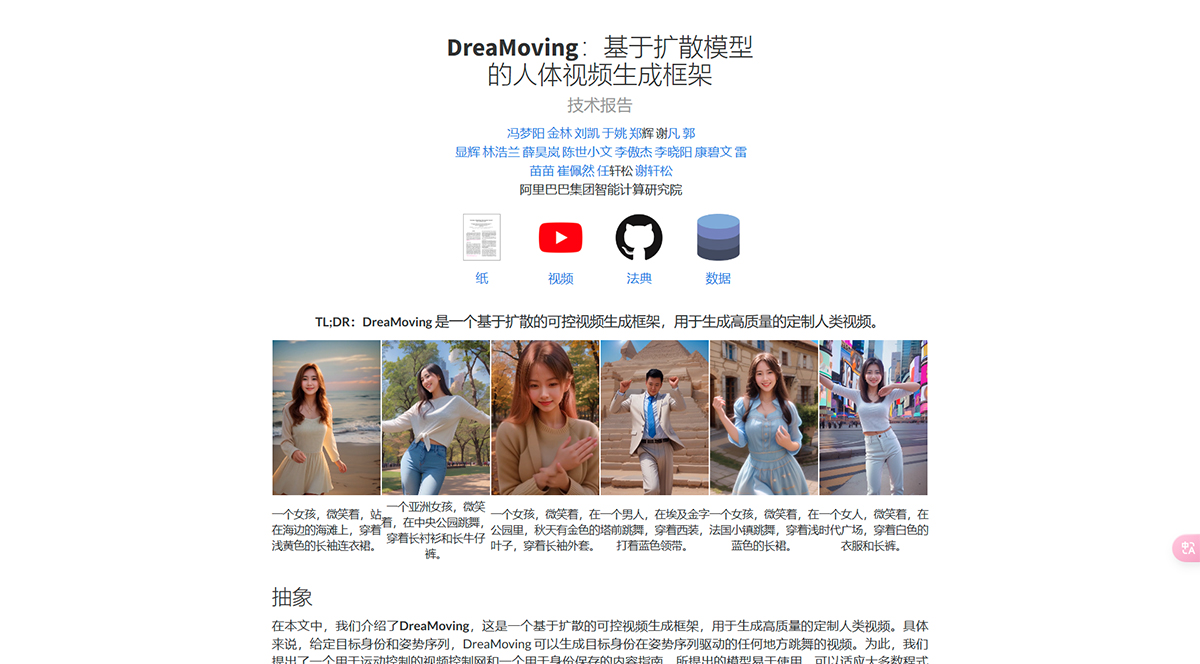
DreaMoving, un cadre de génération de vidéo contrôlable basé sur la diffusion, conçu pour générer des vidéos de danse humaine personnalisées de haute qualité. Plus précisément, étant donné une identité cible et une séquence de poses, DreaMoving peut générer une vidéo de l'identité cible en train de danser n'importe où, pilotée par la séquence de poses. Pour cela, nous proposons un réseau de contrôle vidéo pour le contrôle du mouvement et un guide de contenu pour la préservation de l'identité. Le modèle proposé est facile à utiliser et peut être adapté à la plupart des modèles de diffusion stylisés afin d'obtenir des résultats différents.
Adresse du projet DreaMoving :https://dreamoving.github.io/dreamoving
Aperçu de DreaMoving :
Le Video ControlNet est un ControlNet d'image qui injecte des blocs de mouvement après chaque bloc U-Net. Le Video ControlNet traite la séquence de contrôle (pose ou profondeur) comme des résidus temporels supplémentaires. Le Denoising U-Net est un U-Net Stable-Diffusion dérivé, avec des blocs de mouvement pour la génération vidéo. Le Content Guider transmet l'invite textuelle d'entrée et l'expression d'apparence (comme le visage — le vêtement est facultatif) dans l'embedding de contenu pour l'attention croisée.
Résultats :
DreaMoving peut générer des vidéos de haute qualité et haute fidélité, à partir d'une séquence de guidage et de descriptions de contenu simples, telles que du texte et des images de référence en entrée. Plus précisément, DreaMoving fait preuve de maîtrise dans le contrôle de l'identité grâce à une image de référence du visage, une manipulation précise du mouvement via la séquence de poses, ainsi qu'un contrôle complet de l'apparence vidéo guidé par des invites textuelles spécifiées.














