
 Assistant scénario▸
 Apps AI
 Actualités AI
DeepSeek-V4 : performances explosives, contexte d'1M de tokens et compatibilité Huawei Ascend
小编 ·

DeepSeek-V4 : performances explosives, contexte d'1M de tokens et compatibilité Huawei Ascend
DeepSeek-V4 est une série de grands modèles de langage officiellement lancée et open source le 24 avril 2026, comprenant deux versions : DeepSeek-V4-Pro et DeepSeek-V4-Flash. La série se distingue par un contexte ultra-long d'un million de tokens (1M), offrant des performances de pointe en Chine et dans le domaine open source en termes de capacités d'Agent, de connaissances mondiales et de raisonnement. Le modèle a été profondément adapté aux puces Huawei Ascend.
🚀 Points forts principaux
Le contexte d'un million de tokens devient la norme : les deux versions prennent en charge un contexte ultra-long de 1 million de tokens, proposé en configuration standard par le service officiel. Cela est rendu possible grâce à un nouveau mécanisme d'attention (attention hybride CSA+HCA), qui réduit les besoins en calcul et en mémoire vidéo.
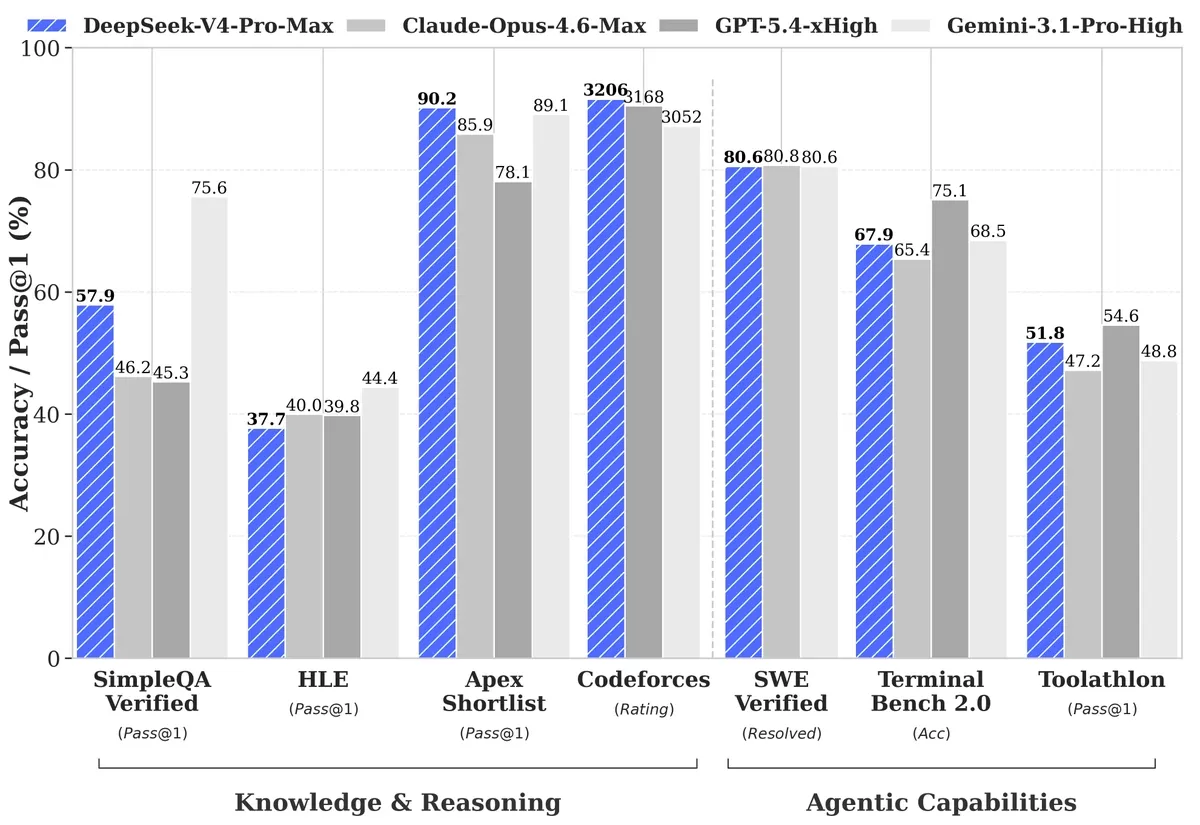
Performances remarquables en raisonnement et en connaissances : DeepSeek-V4-Pro surpasse tous les modèles open source évalués publiquement dans les benchmarks de mathématiques, STEM et code compétitif, avec des performances proches des meilleurs modèles closed source mondiaux. Sa base de connaissances mondiales est également nettement supérieure à celle des autres modèles open source.
Capacités d'Agent améliorées : les capacités d'Agent de V4-Pro atteignent le meilleur niveau parmi les modèles open source dans les évaluations Agentic Coding, offrant une expérience utilisateur supérieure à Sonnet 4.5, avec une qualité de livraison proche du mode non-réflexif d'Opus 4.6. Le modèle a également été optimisé spécifiquement pour les principaux produits Agents tels que Claude Code et OpenClaw.
Adapté à la puissance de calcul nationale : DeepSeek-V4 fonctionnera sur les dernières puces Huawei Ascend, les ingénieurs ayant réalisé la migration de bas niveau de l'architecture NVIDIA CUDA vers l'architecture Huawei CANN. Cambricon a également terminé l'adaptation de la série V4.
🤔 Comment choisir entre les deux versions ?
La série DeepSeek-V4 propose deux versions, adaptées à différents scénarios :
DeepSeek-V4-Pro - Mode expert
Positionnement : viser des performances ultimes, en comparaison avec les meilleurs modèles closed source.
Caractéristiques : base de connaissances plus riche, capacité de raisonnement plus forte, adapté aux tâches complexes de raisonnement, de génération de code et d'Agent.
Paramètres : 1,6T de paramètres totaux, 49B de paramètres activés.
DeepSeek-V4-Flash - Mode rapide
Positionnement : un choix plus rapide et plus économique
Caractéristiques : capacité de raisonnement proche de la version Pro, paramètres et volume d'activation réduits, prix d'API plus bas, réponse plus rapide. Performances équivalentes à la version Pro sur les tâches d'Agent simples.
Paramètres : 284B de paramètres totaux, 13B de paramètres activés.
💻 Comment l'obtenir et l'utiliser ?
Poids open source : publié simultanément en open source sur les plateformes Hugging Face et ModelScope.
Appel API : le service API est mis à jour simultanément, les développeurs peuvent modifier le paramètre model en deepseek-v4-pro ou deepseek-v4-flash pour effectuer l'appel.
Utilisation directe : connectez-vous au site officiel DeepSeek ou à l'application officielle pour dialoguer directement.
Tarifs API
Voici les prix d'appel par million de tokens :
| Version du modèle | Entrée (cache hit)¥/MTok | Entrée (cache miss)¥/MTok | Sortie¥/MTok |
|---|---|---|---|
| DeepSeek-V4-Flash | 0,2 ¥ | 1 ¥ | 2 ¥ |
| DeepSeek-V4-Pro | 1 ¥ | 12 ¥ | 24 ¥ |









