
 Assistant scénario▸
 Apps AI
 Actualités AI
Qwen-Image : modèle open source de génération d'images et d'affiches par Alibaba Tongyi
小编 ·

Qwen-Image : modèle open source de génération d'images et d'affiches par Alibaba Tongyi
Qwen-Image est un modèle de base de génération d'images open source publié le 5 août 2025 par l'équipe Qwen d'Alibaba Tongyi. Il dispose de 20 milliards de paramètres et adopte l'architecture MMDiT. Il se distingue par le rendu de texte complexe et l'édition d'images précise, et excelle particulièrement dans la génération de texte chinois précis en grande quantité. Il prend également en charge les prompts en chinois et obtient des résultats leaders dans de nombreux tests spécialisés en chinois tels que LongText-Bench et ChineseWord.
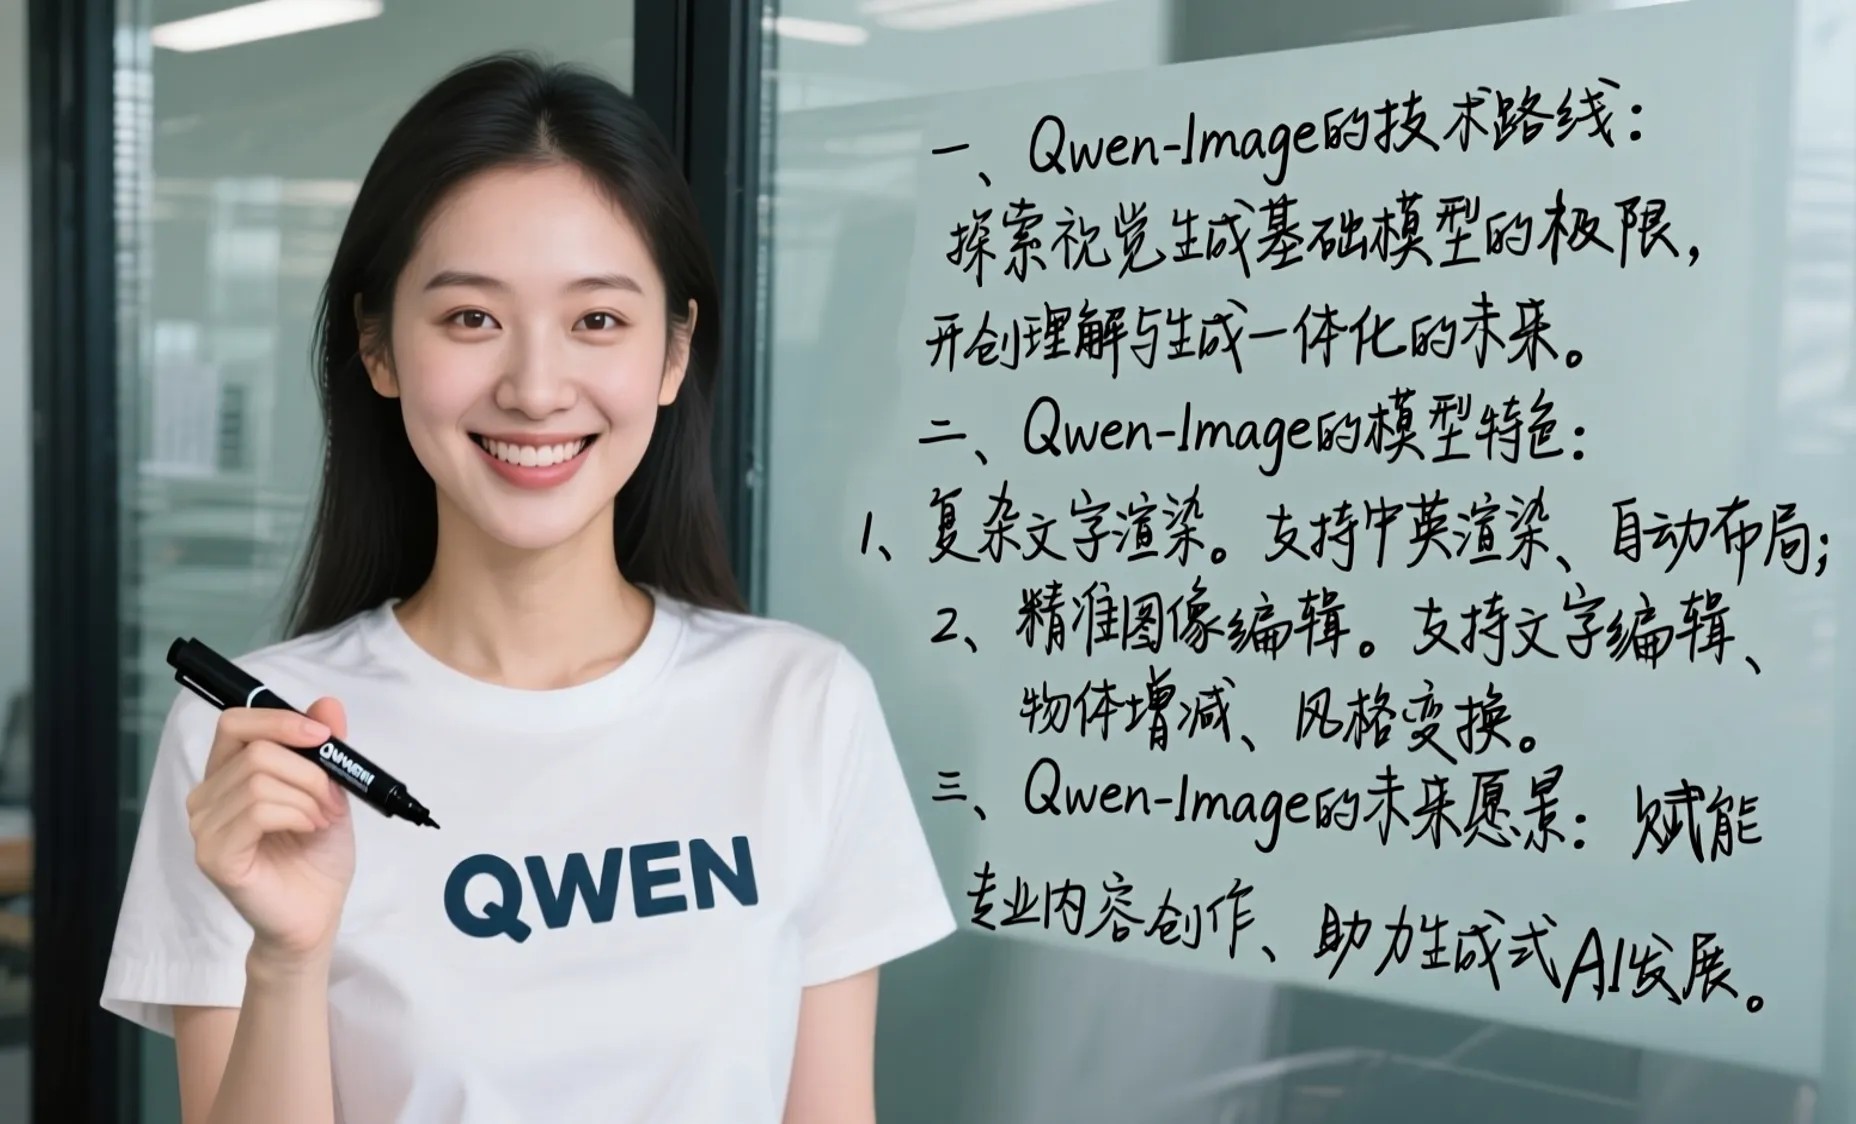
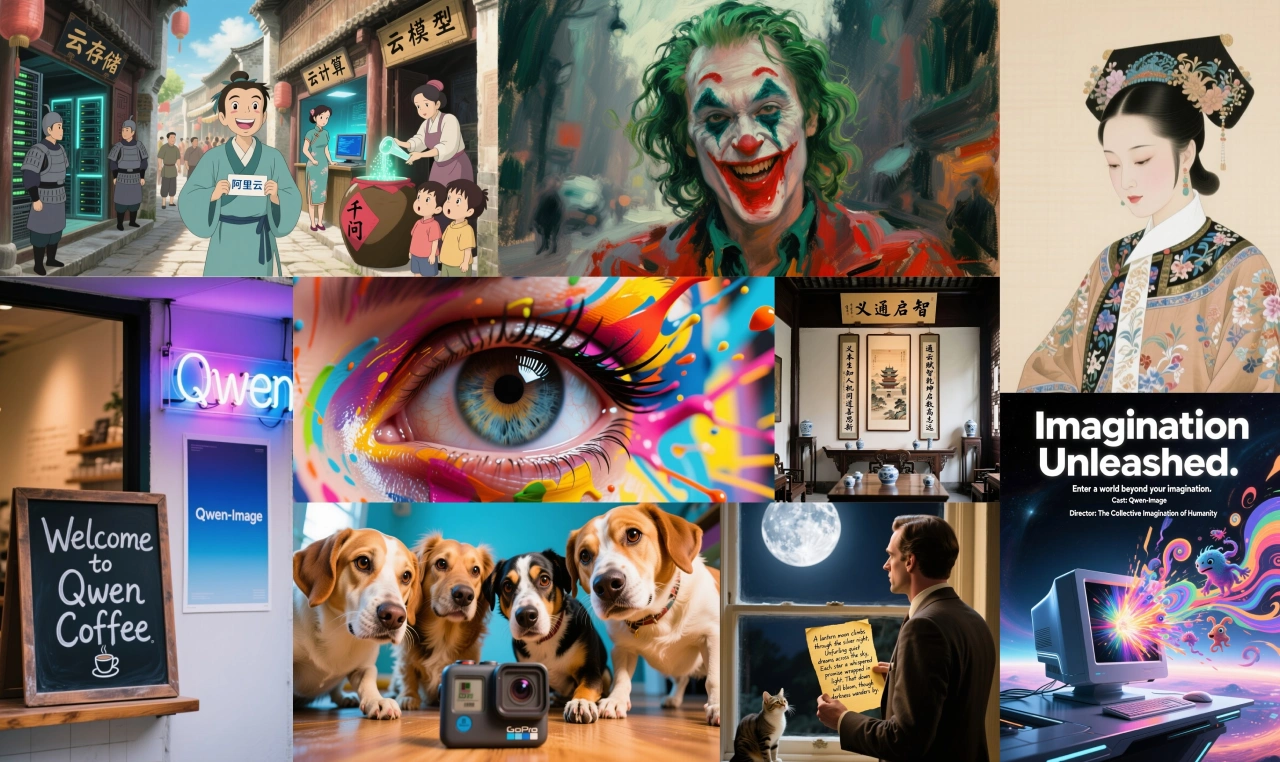
Ce modèle prend en charge le chinois et l'anglais, peut gérer différentes polices, des paragraphes très longs et des mises en page image-texte complexes, et permet de générer des images pour divers scénarios comme des affiches et des ppt. Il permet également l'édition d'images comme le transfert de style, l'ajout ou la suppression d'objets et l'ajustement des poses. Il peut être appliqué dans de nombreux secteurs tels que la conception publicitaire, la production audiovisuelle, le développement de jeux et la formation éducative. Les utilisateurs peuvent accéder à la fonctionnalité de génération d'images dans QwenChat (chat.qwen.ai) pour en faire l'expérience, que ce soit pour générer des affiches, des pages PPT, des visuels promotionnels de produits, ou encore pour effectuer diverses modifications d'images, offrant ainsi un puissant outil aux designers.
Caractéristiques principales
Forte capacité de rendu de texte : prend en charge les mises en page multilignes, la génération de texte au niveau du paragraphe et le rendu fin des détails, avec une sortie haute fidélité aussi bien en chinois qu'en anglais. Ses performances sont excellentes dans les tests tels que LongText-Bench, ChineseWord et TextCraft, et le rendu de texte chinois est nettement meilleur que celui des modèles avancés existants. Il peut générer du texte dans différentes langues et styles, écrire en calligraphie au pinceau, ou générer directement des pages PPT avec du texte et des images.
Excellente cohérence en édition d'images : grâce à un entraînement multitâche renforcé, l'édition préserve la cohérence visuelle et sémantique, et prend en charge des opérations telles que le transfert de style, l'ajout, la suppression, la modification, l'amélioration des détails, l'édition de texte et l'ajustement des poses des personnages.
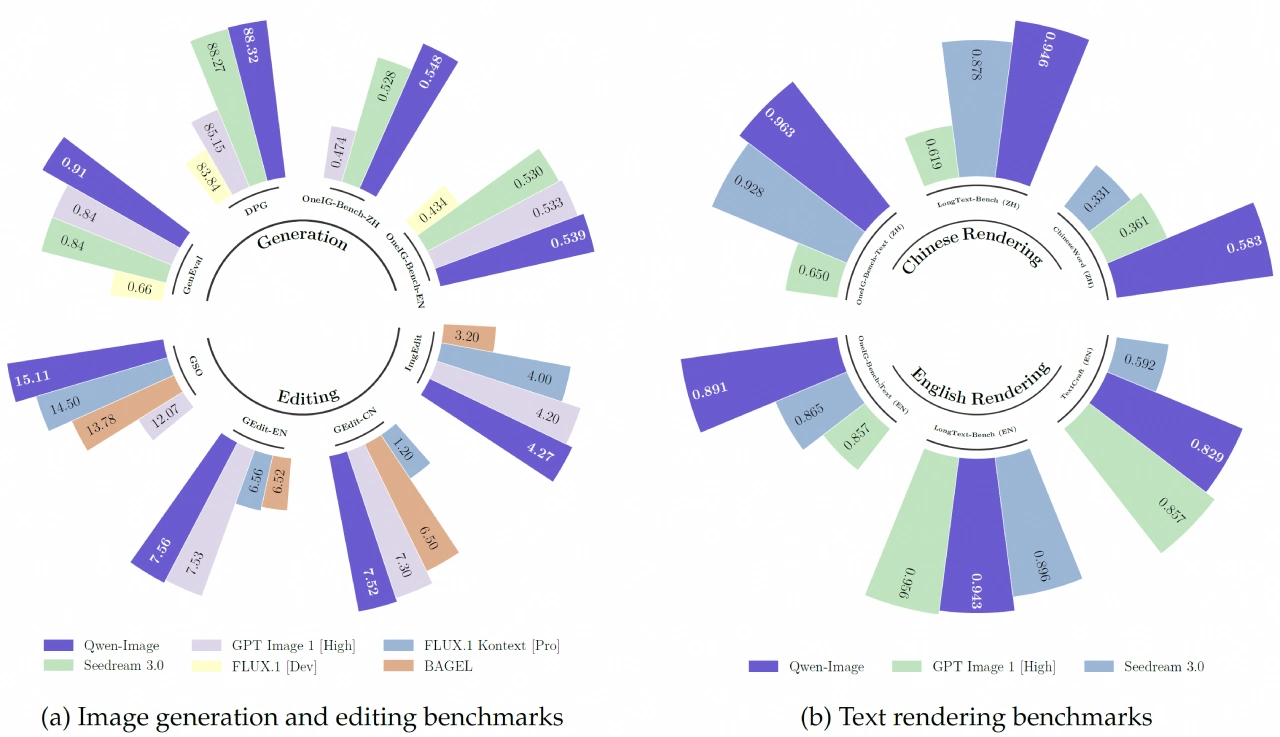
Performances de haut niveau sur plusieurs benchmarks : il atteint des performances de pointe dans plusieurs tests publics, notamment GenEval, DPG et OneIG-Bench pour la génération d'images générales, ainsi que GEdit, ImgEdit et GSO pour l'édition d'images.
Composants principaux
Grand modèle de langage multimodal Qwen2.5-VL : sert d'encodeur de conditions, extrait des caractéristiques à partir du texte et décrit en détail, selon les invites système, la couleur, la quantité, le texte des objets et de l'arrière-plan, fournissant ainsi une base pour la génération d'images et rendant le contenu généré plus fin.
Autoencodeur (VAE) du modèle de génération vidéo Wan-2.1 : agit comme un tokeniseur d'images, capable de compresser l'image d'entrée en une représentation latente compacte, puis de la décoder et restaurer lors de l'inférence. L'équipe a gelé l'encodeur et n'a affiné que le décodeur, ce qui permet de mieux faire ressortir les détails de l'image.
Transformer de diffusion multimodal (MMDiT) : sert de modèle de diffusion principal, traitant la relation entre le bruit et la représentation latente de l'image sous le guidage du texte. Il intègre la méthode RoPE évolutive multimodale, ce qui aide à distinguer les informations d'image et de texte, permettant à la fois de générer des images haute résolution et de générer du texte avec précision.
Architecture technique de Qwen-Image
Architecture MMDiT : utilise un transformer de diffusion multimodal pour réaliser une fusion profonde du texte et de l'image.
VAE à un encodeur et deux décodeurs : responsable de la compression de l'image en une représentation latente compacte, puis de son décodage en pixels après la génération. En ajustant l'équilibre entre la perte de reconstruction et la perte perceptuelle, il peut restaurer fidèlement les détails de l'image.
Encodage positionnel rotatif évolutif multimodal (MSRoPE) : code les informations textuelles sur la « diagonale » de la grille d'images, préservant à la fois l'indépendance du texte et en exploitant les avantages de la mise à l'échelle de la résolution de l'image.
Stratégie d'entraînement
Adopte un pré-entraînement progressif en plusieurs étapes : d'une faible à une haute résolution, du contenu général au contenu spécialisé, et de données massives à des données affinées.
En fin d'entraînement, utilise le fine-tuning supervisé (SFT) et l'apprentissage par renforcement (RL) : effectue un fine-tuning avec des données de haute qualité soigneusement sélectionnées par l'homme, et fait apprendre au modèle les préférences humaines via des techniques telles que DPO.
Scénarios d'application
Conception publicitaire : génère rapidement des images de haute qualité selon le style de la marque, prend en charge la conversion de style et l'optimisation des détails, aidant les designers à essayer rapidement plusieurs effets pour répondre aux besoins des clients.
Production audiovisuelle : utilisé pour les concepts visuels en pré-production, les presets de scènes et la conception de personnages, raccourcissant les cycles de production et réduisant les coûts.
Visuel e-commerce : les commerçants peuvent rapidement générer des visuels de présentation de produits, des visuels d'essayage virtuel et des supports marketing, améliorant ainsi l'expérience utilisateur et le taux d'achat.
Création d'affiches : génère des affiches percutantes et artistiques (comme des affiches de films ou d'événements) selon le texte et les exigences de conception, s'adaptant à différents styles et thèmes.
Création de PPT : génère des pages PPT de niveau entreprise, avec une dominante bleu étoilé, associées à des lignes technologiques fluides et des effets spéciaux de particules subtils, pour un rendu professionnel et moderne, prenant en charge divers styles et mises en page.
Performances
Génération d'images générales : excellentes performances dans les tests tels que GenEval, DPG et OneIG-Bench.
Édition d'images : performances de premier plan dans les tests professionnels tels que GEdit, ImgEdit et GSO.
Rendu de texte : capacités exceptionnelles dans les tests tels que LongText-Bench, ChineseWord et TextCraft, le rendu de texte chinois surpassant notamment de loin les modèles de pointe existants.
Avantages de Qwen-Image
Meilleur support du chinois : optimisé spécifiquement pour le chinois, avec un effet de rendu nettement supérieur à celui de DALL-E.
Entièrement gratuit : aucun abonnement payant requis, et déploiement local possible.
Open source et transparent : code public, personnalisable et modifiable.
Fonctions d'édition plus puissantes : prend en charge des opérations d'édition d'images plus variées.
Sans restriction d'utilisation : non limité par le nombre d'appels API.
Comment utiliser Qwen-Image
Préparation de l'environnement : installer la dernière version de diffusers.
Code de base :
from diffusers import DiffusionPipeline
import torch
model_name = "Qwen/Qwen-Image"
if torch.cuda.is_available():
    torch_dtype = torch.bfloat16
    device = "cuda"
else:
    torch_dtype = torch.float32
    device = "cpu"
pipe = DiffusionPipeline.from_pretrained(model_name, torch_dtype=torch_dtype)
pipe = pipe.to(device)
prompt = '''一个穿着"QWEN"标志T恤的中国美女正拿着黑色马克笔面向镜头微笑。她身后的玻璃板上手写体写着"欢迎使用Qwen-Image,一款强大的图像基础模型"'''
aspect_ratios = {
    "1:1": (1328, 1328),
    "16:9": (1664, 928),
    "9:16": (928, 1664),
    "4:3": (1472, 1140),
    "3:4": (1140, 1472)
}
width, height = aspect_ratios["16:9"]
image = pipe(
    prompt=prompt + "超清,4K,电影级构图",
    width=width,
    height=height,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device=device).manual_seed(42)
).images[0]
image.save("qwen_image_example.png")
GB de mémoire vidéo), le mode CPU est plus lent à générer, mais reste utilisable.
✅Présentation officielle de Qwen-Image : https://qwenlm.github.io/zh/blog/qwen-image/
✅Modèle Qwen-Image : https://huggingface.co/Qwen/Qwen-Image
✅Utilisation en ligne : https://chat.qwen.ai/ (sélectionnez la génération d'images sous la zone de saisie)









