
 Assistant scénario▸
 Apps AI
 Actualités AI
MOSS-TTSD : modèle de synthèse vocale pour dialogue bilingue open source
小编 ·

MOSS-TTSD : modèle de synthèse vocale pour dialogue bilingue open source
MOSS-TTSD est un modèle open source de synthèse vocale conversationnelle bilingue développé conjointement par le laboratoire de parole et langage de l'Université Tsinghua, Tencent ai Lab et d'autres institutions. Il prend en charge le chinois et l'anglais et peut convertir un script de dialogue entre deux locuteurs en une voix conversationnelle naturelle et expressive. Ce modèle est entraîné à partir du modèle Qwen3-1.7B-base, en utilisant une modélisation de séquences vocales discrétisées via le XY-Tokenizer, qui compresse la voix à 1 kbps tout en préservant les informations sémantiques et acoustiques.
Le modèle MOSS-TTSD prend en charge le chinois et l'anglais, permet le clonage zéro-shot de plusieurs voix et peut générer jusqu'à 960 secondes de parole, ce qui le rend adapté aux scénarios tels que les podcasts IA, le doublage cinématographique et les entretiens longs. Les poids du modèle, le code d'inférence et l'interface API sont open source, et une utilisation commerciale gratuite est également prise en charge.
Principales caractéristiques
✅ Voix conversationnelle hautement expressive : construit sur un codec audio neuronal unifié sémantique-acoustique, un grand modèle de langage pré-entraîné, des millions d'heures de données TTS et 400 000 heures de voix conversationnelles synthétiques et réelles, il permet de générer une voix conversationnelle humaine avec une prosodie naturelle et une grande expressivité.
✅ Clonage vocal à deux locuteurs : prend en charge le clonage vocal zéro-shot à deux locuteurs, capable de basculer avec précision entre les locuteurs en fonction du script de dialogue pour générer de la voix conversationnelle.
✅ Prise en charge bilingue chinois-anglais : permet de générer une voix hautement expressive en chinois et en anglais.
✅ Génération de voix longue durée : spécifiquement entraîné pour la génération de voix longue, grâce à un codec à faible débit binaire et à l'optimisation du framework d'entraînement.
✅ Entièrement open source et utilisable commercialement : MOSS-TTSD et ses futures mises à jour seront entièrement open source et pourront être utilisés gratuitement à des fins commerciales.
Principe technique de MOSS-TTSD
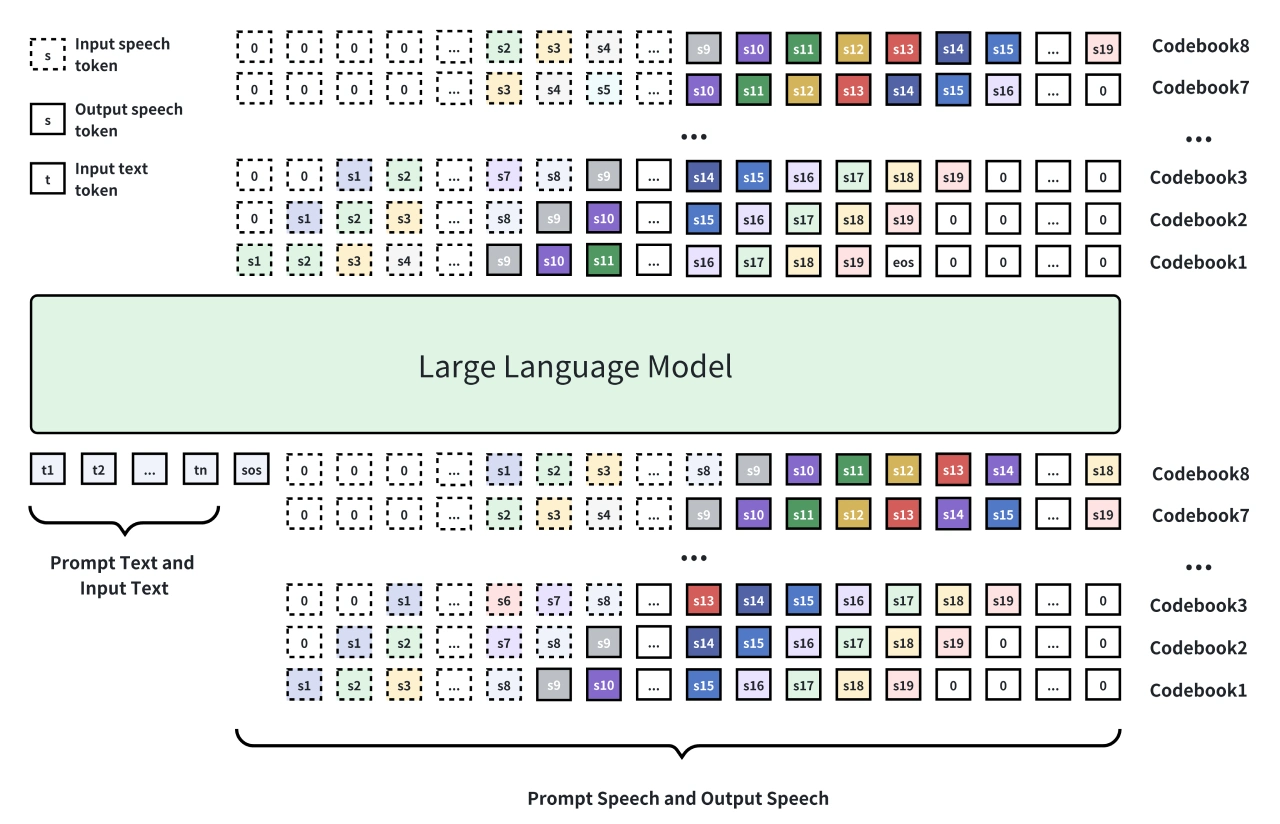
✅ Architecture du modèle : ajusté sur la base du modèle Qwen3-1.7B-base, en adoptant une modélisation vocale discrétisée. Le signal vocal est converti en une séquence de tokens discrets via 8 couches de RVQ (quantification vectorielle résiduelle), généré de manière autorégressive avec un Delay Pattern, puis restauré en voix par un décodeur.
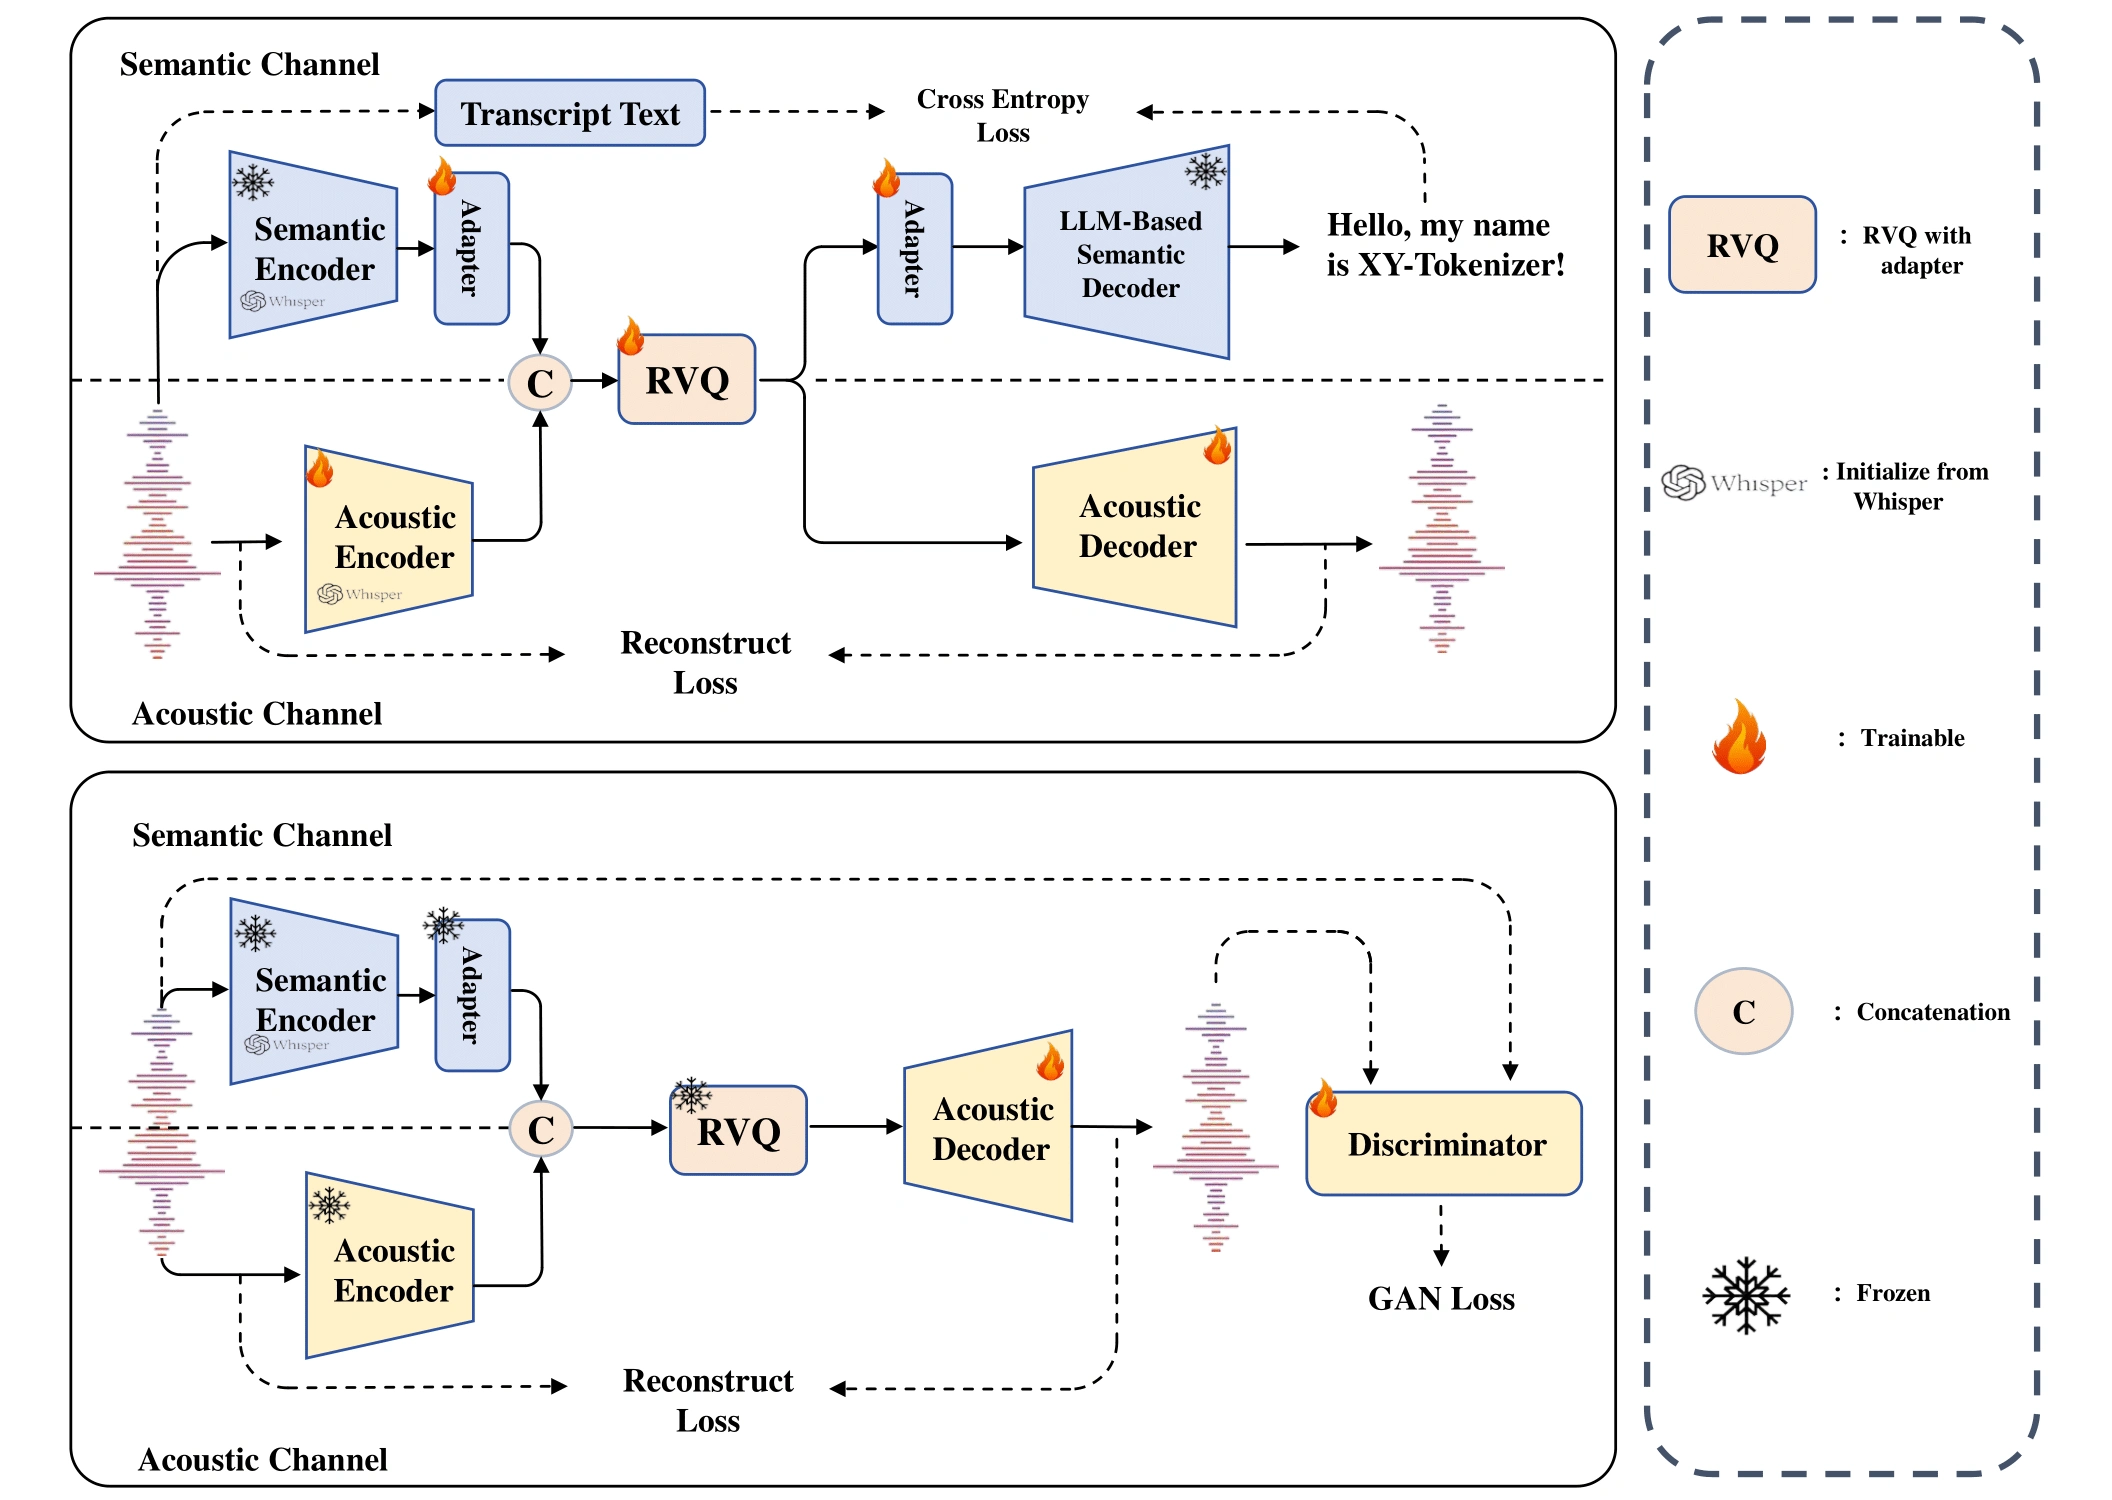
✅ Innovation clé : le XY-Tokenizer intègre un flux d'apprentissage multitâche en deux étapes. La première étape entraîne simultanément des tâches de reconnaissance automatique de la parole (ASR) et de reconstruction vocale, fusionnant les informations sémantiques et acoustiques grossières ; la deuxième étape fixe l'encodeur et le quantificateur, n'entraîne que le décodeur, et ajoute des pertes de reconstruction et GAN pour améliorer le rendu des détails.
✅ Échelle des données et pré-entraînement : entraîné avec environ 1 million d'heures de données vocales mono-locuteur et 400 000 heures de données vocales conversationnelles. Les données ont été rigoureusement filtrées et annotées, et un pré-entraînement TTS chinois-anglais a également été effectué.
Scénarios d'application
✅ Production de podcasts IA : MOSS-TTSD peut convertir automatiquement du texte en audio de podcast multi-locuteurs, prend en charge le clonage vocal zéro-shot et la génération de voix longue durée, ce qui réduit les coûts de production.
✅ Doublage cinématographique et animation : génère une voix conversationnelle naturelle pour les œuvres cinématographiques et les animations, prend en charge le changement de langue et améliore l'efficacité du doublage.
✅ Entretiens longs et comptes rendus de réunions : convertit le texte d'entretiens ou de réunions en voix, en préservant la prosodie et les émotions de la conversation, facilitant ainsi l'archivage et le partage.
Avantages et caractéristiques
✅ Open source et adapté à un usage commercial : les poids du modèle MOSS-TTSD, le code d'inférence et l'interface API sont open source, et les utilisateurs peuvent les utiliser gratuitement à des fins commerciales.
✅ Naturel et expressif : le naturel et l'expressivité de la voix atteignent un niveau de pointe dans l'industrie.
✅ Prise en charge du contrôle des événements sonores : comme les rires et autres sons non verbaux, rendant la voix encore plus expressive.
Adresse open source :https://github.com/OpenMOSS/MOSS-TTSD
Site officiel de MOSS-TTSD :https://www.open-moss.com/cn/









