
 Assistant scénario▸
 Apps AI
 Actualités AI
FantasyPortrait : animation faciale émotionnelle multi-personnages à partir d'une image unique
小编 ·

FantasyPortrait : animation faciale émotionnelle multi-personnages à partir d'une image unique
FantasyPortrait est un framework co-développé par l'équipe Alibaba Amap (Gaode Maps) et l'Université des postes et télécommunications de Pékin (BUPT). Il permet de générer, à partir d'une seule image statique, des animations faciales émotionnelles impliquant plusieurs personnages. Il extrait des expressions complexes via des caractéristiques implicites, remplaçant les a priori géométriques traditionnels, ce qui améliore la capacité de transfert inter-identités. Il exploite par ailleurs un mécanisme d'attention croisée masquée pour éviter les interférences de caractéristiques entre les différents personnages. De plus, il prend en charge l'adaptation multi-styles de personnages, la génération d'animations d'animaux en zero-shot, ainsi que l'animation audio à faibles ressources. Il est applicable à des domaines tels que les humains numériques, les idoles virtuelles et les PNJ de jeux vidéo, et son code est open source sur GitHub.
Fonctionnalités principales
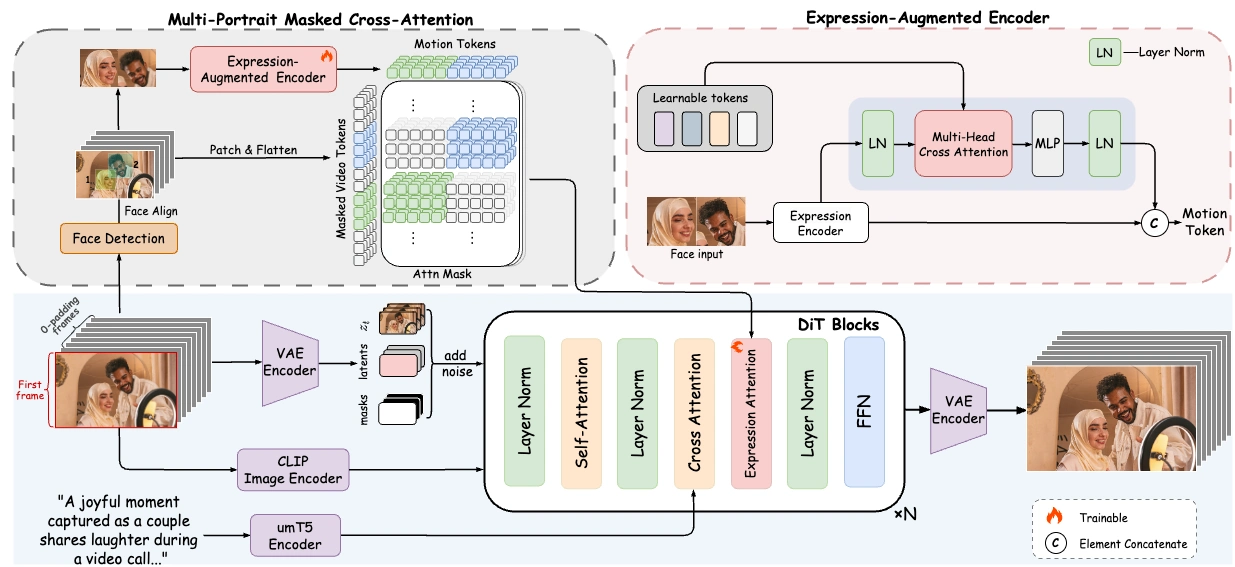
✅ Apprentissage implicite amélioré des expressions : extraction d'expressions complexes (mouvements des lèvres, expressions émotionnelles) via des caractéristiques implicites, en remplacement des a priori géométriques explicites traditionnels, améliorant ainsi la capacité de transfert entre identités.
✅ Mécanisme d'attention croisée masquée : crée des zones de contrôle d'expression indépendantes pour chaque personnage lors de la génération multi-personnages, évitant les interférences et permettant une animation coordonnée de type « un personnage, un canal ».
✅ Extensibilité multimodale : prise en charge de pilotages par texte et par audio. Par exemple, l'audio est encodé avec Whisper pour générer des animations labiales, et un ajustement minimal sur quelques données suffit pour l'adapter au multilingue.
✅ Jeux de données et benchmarks d'évaluation : construction du jeu de données Multi-Expr (plus de 30 000 vidéos multi-personnages de haute qualité) et du benchmark ExprBench, afin de favoriser la standardisation du secteur.
Concernant la conception méthodologique :
✅ Stratégie d'entraînement en deux étapes : les caractéristiques d'expression sont d'abord encodées via un UNet, puis la séquence d'animation est décodée via un transformateur de diffusion.
✅ Module de contrôle multi-personnages : isolation des signaux de pilotage des différents personnages par masquage des caractéristiques, maintenant la cohérence sur la dimension temporelle.
Jeux de données et benchmarks d'évaluation :
✅ Jeu de données Multi-Expr : contient plus de 500 000 images de données d'expression multi-vues, constituant le premier jeu de données dédié à l'animation multi-personnages.
✅ Benchmark d'évaluation ExprBench : utilisé pour entraîner et évaluer l'animation de portraits multi-personnages.
Résultats expérimentaux :
✅ Tâche de réanimation inter-pilotage : par rapport à des méthodes telles que StyleHEAT et PIRender, l'indicateur FID est amélioré de 41,7 %.
✅ Scénarios de génération d'animation multi-personnages : taux de préférence utilisateur atteignant 83,5 %, capable de restituer avec précision des micro-expressions telles que de légers tremblements oculaires et des mouvements asymétriques des commissures des lèvres.
Les scénarios d'application incluent :
✅ Animation multi-personnages : prise en charge du pilotage de plusieurs personnages via plusieurs vidéos monopersonnelles ou une seule vidéo multipersonnelle, générant des expressions détaillées et des animations de portraits réalistes.
✅ Styles de personnages diversifiés : capable de générer des animations dynamiques, expressives, naturelles et réalistes dans une grande variété de styles.
✅ Animation d'animaux : bien qu'il n'ait pas été explicitement entraîné sur des jeux de données d'animaux, il généralise très bien aux tâches d'animation d'animaux.
✅ Animation de portraits pilotée par l'audio : via l'encodage audio et un réseau basé sur Transformer, les caractéristiques audio sont mappées vers une représentation de pilotage latente, permettant une animation de portraits pilotée par l'audio avec un bon alignement audio-vidéo même avec peu d'échantillons d'entraînement.
Réponses aux questions clés :
Quelles sont les avancées techniques ?
Réponse : Premièrement, un contrôle implicite renforcé — l'apprentissage de caractéristiques d'expression fines (mouvements buccaux, expressions émotionnelles) via une représentation faciale implicite. Deuxièmement, l'attention croisée masquée multi-personnages — un mécanisme original d'attention croisée masquée permettant un contrôle indépendant et une génération coordonnée de plusieurs personnages, résolvant le problème d'interférence entre personnages.
Quelles sont les caractéristiques fonctionnelles ?
Réponse : Pilotage synchronisé multi-personnages, prenant en charge le pilotage simultané de plusieurs personnages à partir d'une ou plusieurs vidéos monopersonnelles ou d'une vidéo multipersonnelle ; adaptation de personnages multi-styles, capable de générer des vidéos fluides, vivantes, naturelles et au style cohérent pour des personnages de différents styles artistiques ; animation d'animaux en zero-shot, avec d'excellentes capacités de génération sans entraînement spécifique ; pilotage audio à faibles ressources, pouvant être étendu en framework piloté par l'audio, utilisant Whisper pour encoder l'audio et un réseau Transformer léger pour mapper les caractéristiques audio dans l'espace de pilotage latent.
Quelle est sa valeur applicative ?
Réponse : Dans la production cinématographique et télévisuelle, il permet à un animateur indépendant de générer facilement des performances de scènes de groupe ; dans le domaine du jeu vidéo, il permet aux PNJ d'afficher des micro-expressions uniques ; dans le livestreaming virtuel, il rend les interactions multi-personnages plus vivantes et naturelles.
Informations open source :
Dépôt GitHub : https://github.com/Fantasy-AMAP/fantasy-portrait
Site officiel du projet : https://fantasy-amap.github.io/fantasy-portrait/









