
 Assistant scénario▸
 Apps AI
 Actualités AI
MultiTalk : outil open source de Meituan pour générer des vidéos de conversations multi-interlocuteurs pilotées par l'audio
小编 ·

MultiTalk : outil open source de Meituan pour générer des vidéos de conversations multi-interlocuteurs pilotées par l'audio
MultiTalk est un outil de génération de vidéo de conversation à plusieurs personnes piloté par l'audio, open source, développé par l'équipe d'intelligence visuelle de Meituan. À partir d'audio multi-locuteurs, d'images de référence et d'invites textuelles, il génère des vidéos de conversation avec des humains numériques aux lèvres synchronisées et aux mouvements corporels naturels, avec d'excellents résultats. Il suffit aux utilisateurs de téléverser l'audio, l'image de référence et les invites pour générer une vidéo de dialogue avec une synchronisation labiale correspondante, ainsi que des scènes de chant et des personnages de dessin animé.
Ce projet présente plusieurs fonctionnalités pratiques : une synchronisation labiale précise pilotée par l'audio, un contrôle des actions du personnage virtuel à l'aide d'invites, la génération de vidéos dans différentes résolutions, ainsi que la création de scènes de dialogue pouvant aller jusqu'à 15 secondes. De plus, il intègre une fonction de synthèse vocale, a mis en œuvre plusieurs optimisations pour améliorer l'efficacité de génération, prend en charge un mode basse mémoire vidéo et l'inférence multi-GPU, et fonctionne sur une seule carte graphique RTX 4090.
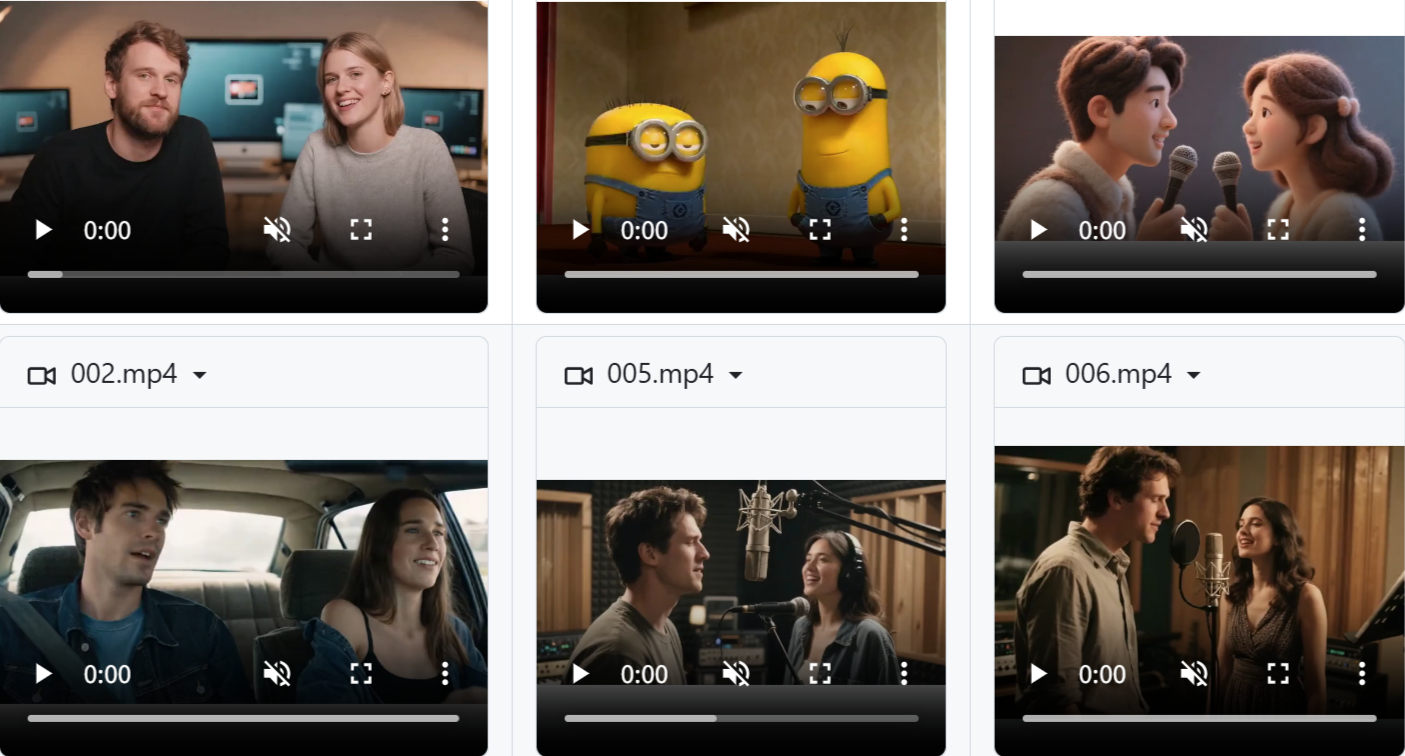
Fonctionnalités caractéristiques
✅ Pilotage audio : à partir d'un audio multi-locuteurs, génère une synchronisation labiale naturelle et des mouvements corporels.
✅ Entrée photo unique : une seule image de référence suffit pour générer une vidéo d'interaction à plusieurs personnes.
✅ Suivi d'actions complexes : prend en charge des invites textuelles complexes pour générer des actions et des scènes conformes aux descriptions.
✅ Prise en charge multilingue : capable de traiter des audios en plusieurs langues et d'assurer une synchronisation labiale précise.
✅ Génération de vidéos longues : utilise une méthode auto-régressive pour produire de longues vidéos cohérentes.
✅ Stratégie d'entraînement efficace : améliore les performances du modèle grâce à un entraînement en deux étapes, un entraînement partiel des paramètres et un entraînement multi-tâches.
✅ Technologie L-RoPE : grâce à l'encodage positionnel rotatif étiqueté, réalise une liaison précise entre les flux audio multiples et les personnages.
✅ Sortie haute qualité : les vidéos générées sont naturelles et fluides, avec pratiquement aucun artefact visuel.
Points forts techniques
✅ Technologie L-RoPE首创 : utilise l'encodage positionnel rotatif étiqueté pour résoudre le problème de décalage entre les flux audio multiples et les personnages, permettant une correspondance précise entre l'audio et les personnages.
✅ Génération de vidéos pilotée par l'audio : à partir d'audio multi-locuteurs, d'images de référence et d'invites textuelles, génère des vidéos interactives avec des lèvres synchronisées et des mouvements corporels naturels.
✅ Entraînement partiel des paramètres + stratégie d'apprentissage multi-tâches : préserve la capacité de suivi d'instructions d'actions complexes tout en permettant un positionnement adaptatif des personnages dynamiques.
✅ Prise en charge multi-scènes : peut être utilisé pour la production cinématographique et télévisuelle, le commerce en direct, et bien d'autres scénarios.
Framework technique
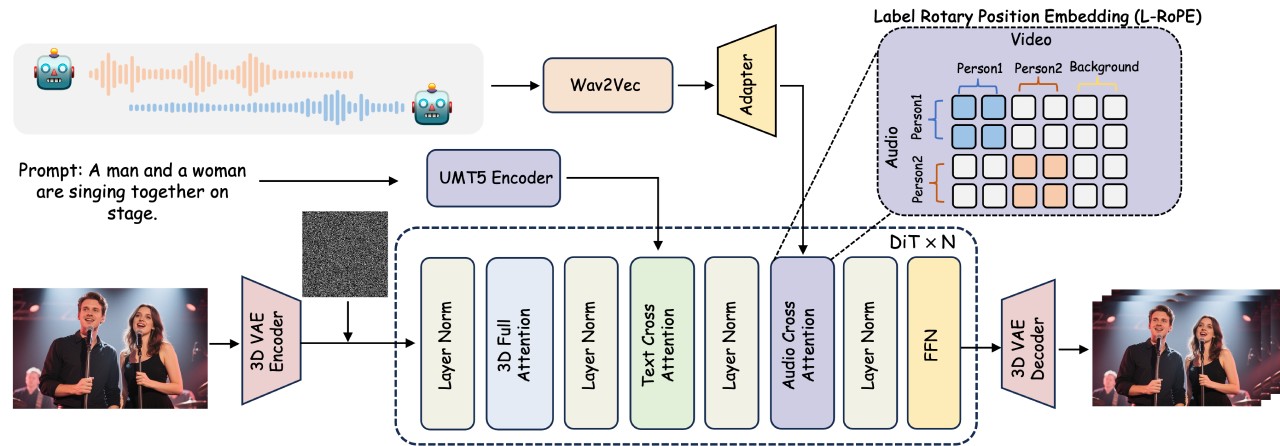
✅ Architecture du modèle de base : centrée sur le modèle de diffusion vidéo DiT, intègre un autoencodeur variationnel 3D pour traiter efficacement les données vidéo.
✅ Intégration audio mono-personnage : ajoute un mécanisme d'attention croisée audio après la couche d'attention croisée textuelle de chaque bloc DiT, utilise Wav2Vec pour extraire les caractéristiques audio et un adaptateur audio pour résoudre le problème d'inadéquation de la granularité temporelle entre la vidéo et l'audio.
✅ Traitement audio multi-personnages : s'appuie sur la technologie L-RoPE pour réaliser une liaison précise entre les flux audio multiples et les différents personnages, évitant le « parler à l'unisson ».
Stratégie d'entraînement :
✅ Entraînement en deux étapes : d'abord la capacité de génération de vidéo mono-personnage, puis l'interaction et la liaison multi-personnages.
✅ Entraînement partiel des paramètres : seules les paramètres du réseau de la couche d'attention croisée audio et de l'adaptateur audio sont mis à jour, tandis que les autres paramètres du modèle de base sont gelés.
✅ Entraînement multi-tâches : combine deux méthodes d'entraînement, audio + image vers vidéo et image vers vidéo, pour renforcer la capacité de suivi des instructions du modèle.
Performances
✅ Évaluation quantitative : dans les tâches de génération de mouvements de la tête et du corps, surpasse plusieurs méthodes avancées en termes de synchronisation labiale (Sync-C, Sync-D) et de qualité vidéo (FID, FVD).
✅ Évaluation qualitative : obtient de bons résultats dans le traitement de scènes d'interaction complexes, capable de générer des vidéos répondant précisément à des invites textuelles complexes, avec peu d'artefacts visuels et des images naturelles et réalistes.
✅ Génération de vidéos longues : grâce à une méthode auto-régressive, utilise la partie finale de la vidéo précédemment générée comme condition pour générer de nouveaux clips vidéo, garantissant cohérence et continuité temporelles.
Cas d'utilisation
Production cinématographique et télévisuelle : interactions de personnages virtuels, doublage d'animations, synthèse d'effets spéciaux, création de courts-métrages.
Commerce en direct : interaction avec présentateurs virtuels, présentation et commentaire de produits, streaming multilingue.
Domaine de l'éducation : interaction avec enseignants virtuels, apprentissage des langues, reconstitutions historiques.
Développement de jeux : dialogues de personnages virtuels, interactions avec les PNJ, jeux multijoueurs en ligne.
Publicité et marketing : porte-parole virtuels, promotion de produits, publicités sur les réseaux sociaux.
Social virtuel : interactions sur les plateformes sociales virtuelles, réunions virtuelles.
Divertissement créatif : clips musicaux, concerts virtuels, courts-métrages créatifs.
Services publics : diffusion d'informations, campagnes de sensibilisation du public.
Formation en entreprise : scénarios de formation virtuelle, simulations situationnelles.
Échanges internationaux : dialogues multilingues, échanges culturels.
Adresse du projet
Page officielle du projet :https://meigen-ai.github.io/multi-talk/
Code open source :https://github.com/MeiGen-AI/MultiTalk
Article technique :https://arxiv.org/abs/2505.22647









