
 Assistant scénario▸
 Apps AI
 Actualités AI
ColQwen-Omni : modèle RAG multimodal open source
小编 ·

ColQwen-Omni : modèle RAG multimodal open source
ColQwen-Omni, un modèle RAG multimodal open source, construit sur ColQwen2 et Qwen2-VL, est le premier modèle open source à étendre le paradigme de récupération ColBERT au modalité audio.
Il prend en charge la récupération cross-modale et peut traiter des données de plusieurs modalités telles que le texte, l'audio et les images. Le jeu de données d'entraînement comprend 127 460 paires requête-page, dont 63 % proviennent de jeux de données d'entraînement académiques publics et 37 % de jeux de données synthétiques, et il dispose de capacités de récupération audio zero-shot.
Points forts principaux
Récupération cross-modale : prend en charge la recherche de texte vers audio, d'audio vers image, etc., toutes les données modales étant récupérées dans le même espace vectoriel.
Traitement direct de l'audio et de la vidéo : pas besoin de transcription, traitement direct des données brutes audio et vidéo, tout en préservant les émotions, le ton et les détails visuels.
Récupération ultra-rapide : 30 minutes d'audio traitées en 10 secondes, chaque segment de vidéo courte en moins de 10 secondes, et une seule requête en moins de 100 millisecondes.
Synchronisation TMRoPE : intégration multimodale à alignement temporel, alignement précis des images vidéo / des trames audio.
Léger et efficace : 3 milliards de paramètres, peut fonctionner sur le GPU gratuit de Colab.
Détails techniques de ColQwen-Omni
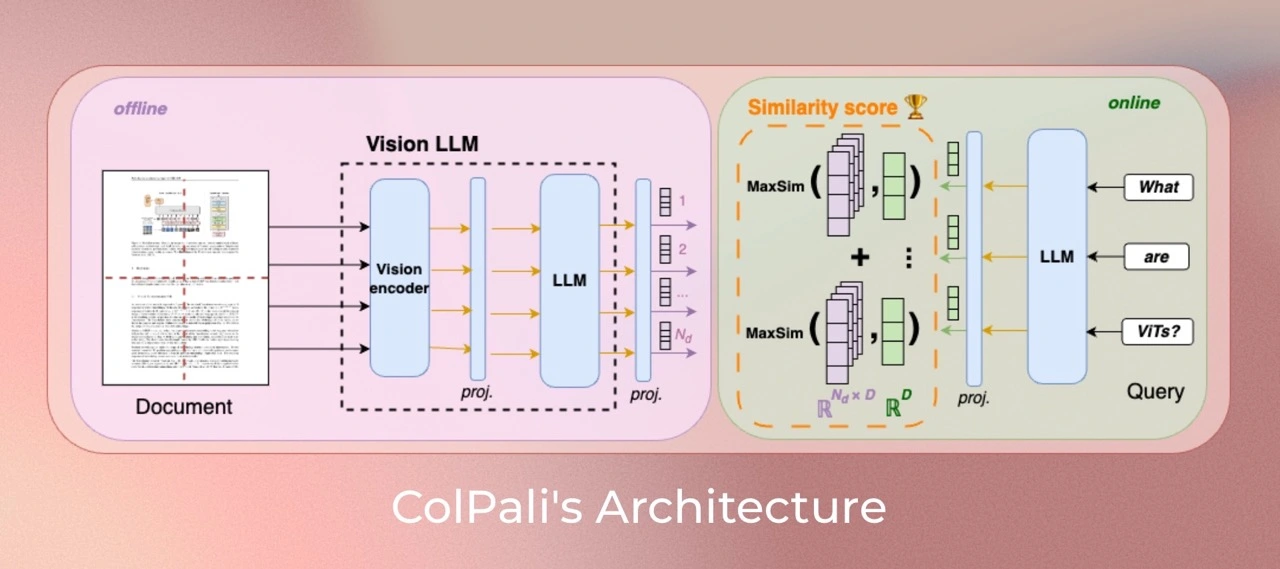
Stratégie d'entraînement : entraîné avec colpali-engine==0.3.11, construit sur Qwen2.5-Omni-3B-Instruct, en adoptant la stratégie de représentation multi-vecteurs de style ColBERT.
Données d'entraînement : comprend 127 460 paires requête-page, couvrant des jeux de données académiques publics et des jeux de données synthétiques.
Traitement à résolution dynamique : prend en charge l'entrée d'images à résolution dynamique, sans redimensionnement ni recadrage, en conservant le rapport d'aspect original.
Capacité de récupération audio zero-shot : bien que les données d'entraînement ne contiennent que des paires image-texte, le modèle peut toujours récupérer du contenu audio.
Scénarios applicables
Récupération audio et vidéo : recherche de conférences TED par texte, recherche de miniatures YouTube par audio, etc.
Questions-réponses sur documents : questions-réponses sur PDF / images, sans OCR, capable d'analyser la mise en page et les graphiques.
Recherche en éducation : récupération de vidéos de cours / supports de cours, analyse cross-modale.
Analyse du divertissement : recherche de courtes vidéos / podcasts, en préservant les émotions et les sons d'ambiance.
Scénarios sensibles à la confidentialité : peut fonctionner localement sur Colab, sans téléchargement de données.
Questions clés
Quelles sont les caractéristiques du jeu de données d'entraînement de ColQwen2.5-Omni ?
Le jeu de données d'entraînement de ce modèle comprend 127 460 paires requête-page, dont 63 % proviennent de jeux de données d'entraînement académiques publics et 37 % de jeux de données synthétiques (incluant des pages PDF extraites du web et de pseudo-questions générées par VLM). Le jeu de données est conçu entièrement en anglais afin de faciliter l'étude de la capacité de généralisation zero-shot vers des langues non anglaises. Parmi eux, 2 % des échantillons servent d'ensemble de validation pour l'optimisation des hyperparamètres. De plus, aucun document PDF multi-pages n'est utilisé simultanément dans ViDoRe et dans le jeu d'entraînement, évitant ainsi la contamination de l'évaluation. Le corpus de pré-entraînement du modèle de langage et l'entraînement multimodal peuvent contenir des données multilingues.
En quoi le traitement d'image de ColQwen2.5-Omni diffère-t-il de celui de ColPali ?
ColQwen2.5-Omni accepte des résolutions d'image dynamiques, sans redimensionnement modifiant le rapport d'aspect, et crée au maximum 1 024 patchs d'image à la résolution maximale ; ColPali modifie le rapport d'aspect de l'image.
Comment utiliser ColQwen2.5-Omni pour la récupération audio ?
Installez d'abord une version de colpali-engine supérieure à 0.3.11 (via pip install git+https://github.com/illuin-tech/colpali) ; importez ensuite les bibliothèques pertinentes, chargez le modèle et le processeur ; traitez le jeu de données audio et créez un chargeur de données pour générer les vecteurs d'intégration audio ; définissez enfin la fonction de récupération, entrez le texte de la requête, générez les vecteurs d'intégration de la requête via le modèle et notez-les par rapport aux vecteurs d'intégration audio, obtenez les résultats _topk, et vous pourrez afficher l'audio correspondant.
Lien du projet
Adresse GitHub :https://github.com/illuin-tech/colpali.
Adresse du modèle :https://huggingface.co/vidore/colqwen-omni-v0.1.









