
 Assistant scénario▸
 Apps AI
 Actualités AI
Kyutai TTS : un outil open source de synthèse vocale conçu pour le temps réel
小编 ·

Kyutai TTS : un outil open source de synthèse vocale conçu pour le temps réel
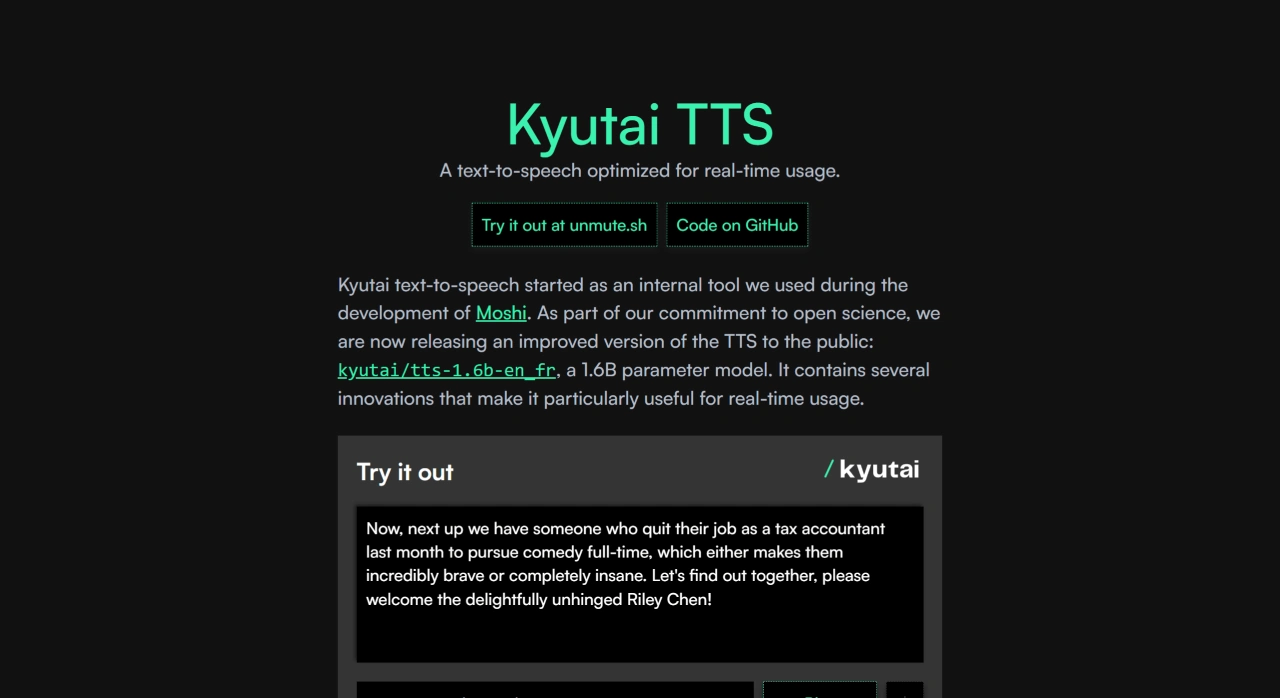
Kyutai TTS est un modèle open source de synthèse vocale (text-to-speech) développé par Kyutai Labs en France, conçu spécialement pour les applications en temps réel. Il possède 1,6 milliard de paramètres, avec des taux d'erreur sur les mots de 2,82 % en anglais et 3,29 % en français, et une latence de génération vocale de seulement 220 millisecondes, ce qui le rend adapté aux scénarios de diffusion en direct et d'assistants vocaux. Ses techniques de traitement en flux et de modélisation de flux à faible latence rendent la génération de texte et de voix plus efficace.
Caractéristiques techniques :
Traitement en flux et faible latence : Kyutai TTS peut générer de l'audio immédiatement après avoir reçu le premier jeton de texte, avec une latence de seulement 220 millisecondes. Sur un GPU NVIDIA L40S, lors du traitement de 32 requêtes simultanées, la latence est d'environ 350 millisecondes.
Sortie vocale haute précision : les taux d'erreur sur les mots sont respectivement de 2,82 % et 3,29 % en anglais et en français, avec une similarité de locuteur atteignant 77,1 % et 78,7 %, offrant une voix naturelle et proche des échantillons originaux.
Génération de contenus longs : capable de traiter des articles longs, dépassant la limite de 30 secondes des modèles TTS traditionnels.
Clonage vocal : l'utilisateur fournit un échantillon audio de 10 secondes, et le modèle peut reproduire le timbre et l'intonation du locuteur. Pour garantir la légalité, Kyutai TTS propose une bibliothèque de voix basée sur des jeux de données publics, sans publier directement le modèle d'intégration vocale.
Horodatage des mots : chaque mot dans l'audio généré possède un horodatage précis, facilitant la génération de sous-titres en temps réel ou les applications interactives.
Architecture et entraînement :
Modélisation de flux à latence (DSM) : le modèle génère la voix en temps réel tout en recevant le texte, prend en charge l'entrée de texte en flux et peut traiter plusieurs requêtes simultanément.
Données d'entraînement et matériel : entraîné sur 2,5 millions d'heures de données audio publiques, avec des transcriptions générées par Whisper, en utilisant 32 GPU H100 pour le processus d'entraînement.
Cas d'utilisation :
Interaction en temps réel : adapté aux assistants virtuels, plateformes d'éducation en ligne et génération de sous-titres en temps réel.
Création de contenu : peut être utilisé pour générer des podcasts, des livres audio et autres contenus longs.
Outils d'assistance : fournit un service de lecture de texte de haute qualité pour les personnes malvoyantes.
Comparaison avec d'autres TTS :
Par rapport aux autres modèles TTS disponibles sur le marché, Kyutai TTS se distingue par ses taux d'erreur sur les mots et sa similarité de locuteur, avec des performances particulièrement excellentes dans les scénarios d'interaction en temps réel.
Kyutai TTS est open source sous licence CC-BY-4.0, et le code source ainsi que les poids sont disponibles sur GitHub et Hugging Face. Les développeurs peuvent contribuer en faisant don de données vocales pour aider le modèle à élargir ses styles de voix et son support linguistique.
Adresse du projet : https://kyutai.org/next/tts









