
 Assistant scénario▸
 Apps AI
 Actualités AI
XVerse : un outil open source de ByteDance pour la synthèse d'images multi-sujets
小编 ·

XVerse : un outil open source de ByteDance pour la synthèse d'images multi-sujets
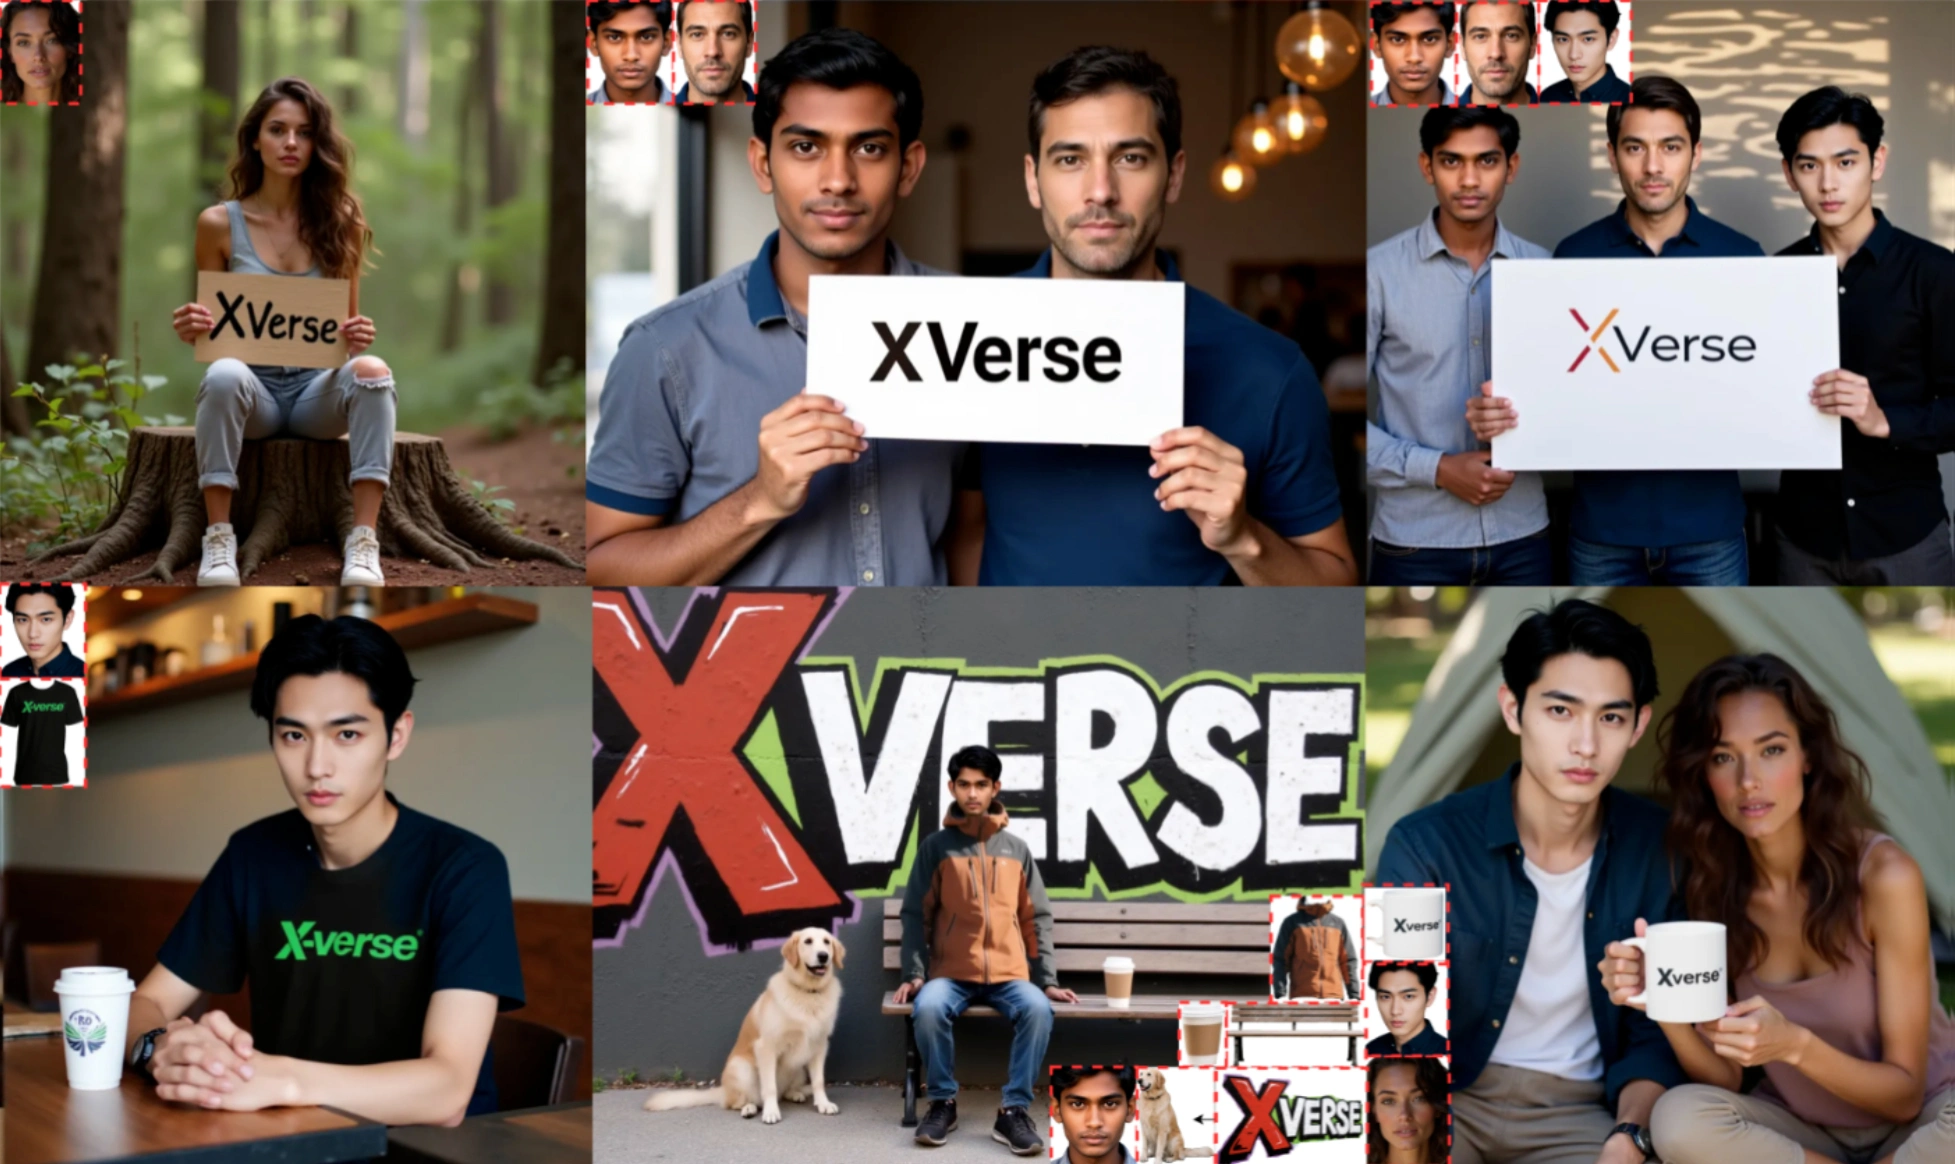
XVerse est un outil de synthèse d'images à plusieurs sujets lancé par ByteDance, permettant une génération d'images multi-sujets de haute précision. Il permet aux utilisateurs de contrôler indépendamment et précisément plusieurs sujets, améliorant ainsi considérablement la capacité de génération de scènes complexes.
Fonctionnalités principales
Contrôle multi-sujets : XVerse convertit les images de référence en décalages modulés par flux de texte, contrôlant précisément les caractéristiques d'identité de chaque sujet et ajustant indépendamment les attributs sémantiques (pose, style, éclairage, etc.). Cela résout les problèmes courants de confusion d'identité et d'enchevêtrement d'attributs des modèles traditionnels dans les scènes multi-sujets, permettant une synthèse d'images multi-sujets haute fidélité et modifiable.
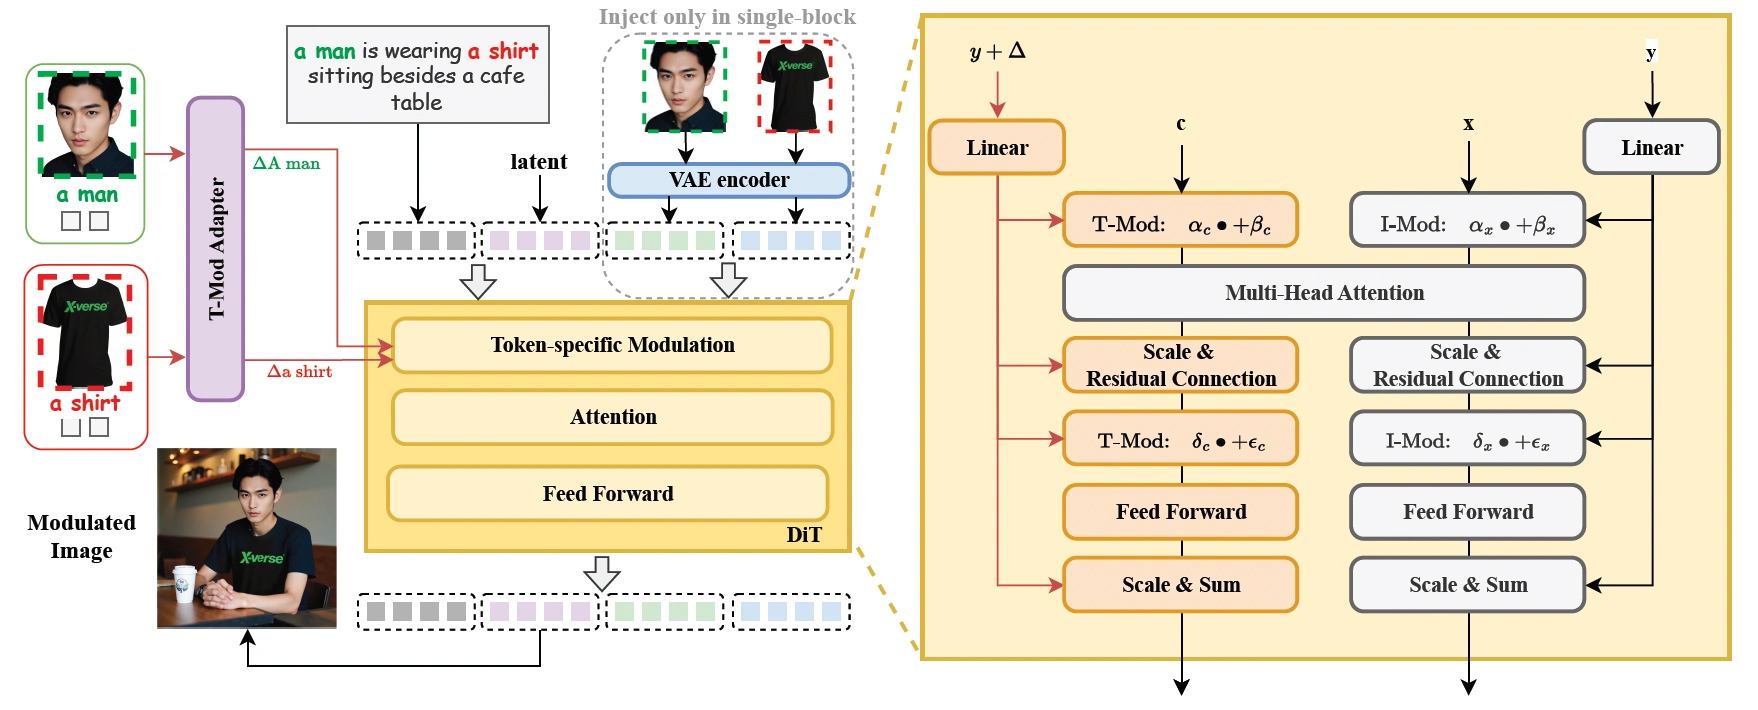
Amélioration par modulation de flux de texte : en combinant les caractéristiques des images de référence avec les caractéristiques des invites textuelles pour générer des décalages, puis en les injectant dans les embeddings de jetons textuels spécifiques, XVerse permet un contrôle précis de chaque sujet tout en maintenant la structure globale de l'image générée et en permettant des ajustements fins des détails.
Caractéristiques d'image encodées par VAE : XVerse introduit des caractéristiques d'image encodées par VAE comme entrées auxiliaires, injectées dans des blocs individuels des DiTs. Cela aide à capturer et reproduire les informations détaillées de l'image, évitant les artefacts et la dégradation de qualité pouvant résulter d'une injection directe des caractéristiques d'image.
Techniques de régularisation : utilise une perte de préservation de région, forçant le modèle à maintenir la cohérence dans les régions non modulées, distinguant et préservant les caractéristiques des différents sujets. Grâce à une perte d'attention texte-image, aligne les cartes d'attention croisée entre le modèle modulé et la branche T2I de référence, garantissant la cohérence et la possibilité d'édition des interactions sémantiques pendant le processus de modulation.
Principes techniques de XVerse
Mécanisme de modulation de flux de texte : XVerse convertit les images de référence en décalages de modulation de flux de texte spécifiques à des jetons, ajoutés aux embeddings textuels du modèle, permettant ainsi un contrôle précis de sujets spécifiques sans interférer avec les variables latentes ou les caractéristiques de l'image.
Module de caractéristiques d'image encodées par VAE : pour renforcer la capacité de préservation des détails des images générées, XVerse introduit un module de caractéristiques d'image encodées par VAE. Ce module sert de module auxiliaire, aidant le modèle à conserver davantage d'informations détaillées pendant le processus de génération, réduisant ainsi les artefacts et les distorsions.
Techniques de régularisation : basées sur l'injection de modulation préservée aléatoirement d'un côté, force le modèle à maintenir la cohérence dans les régions non modulées. Caractéristiques spécifiques au sujet régularisées, servant de stratégie d'augmentation de données pour les ensembles de données multi-sujets, améliorant la capacité du modèle à distinguer et préserver les caractéristiques des sujets dans les scènes multi-sujets. En calculant la perte L2 des cartes d'attention croisée texte-image entre le modèle modulé et la branche T2I de référence, garantit que le modèle modulé conserve des schémas d'attention cohérents avec la branche T2I, maintenant la cohérence et la possibilité d'édition des interactions sémantiques.
Scénarios d'application
Création de contenu numérique : XVerse aide les créateurs à contrôler facilement plusieurs sujets avec précision. Il peut être utilisé pour dessiner des bandes dessinées, créer des illustrations d'histoires, construire des scènes virtuelles complexes, etc., rendant les œuvres plus vivantes, riches et imaginatives.
Secteur publicitaire : XVerse permet de contrôler précisément les attributs de chaque sujet, garantissant une haute fidélité et une cohérence de l'image publicitaire, rendant les publicités plus attrayantes et améliorant l'efficacité de la diffusion.
Domaine artistique : offre aux artistes un nouvel outil de création, dépassant les limites de la création traditionnelle, permettant de créer des œuvres d'art uniques et expressives.
Comment utiliser XVerse
Les utilisateurs doivent créer un environnement conda avec Python 3.10.16, installer les dépendances, et télécharger les checkpoints pertinents ainsi que le modèle de reconnaissance faciale. L'interface utilisateur est conviviale et offre de nombreuses options de paramètres d'entrée, notamment une fonction de « détection et segmentation » qui peut analyser les images téléchargées, recadrer automatiquement les visages et générer des descriptions. De plus, une démo interactive Gradio est fournie, permettant aux utilisateurs de télécharger des images, de saisir des descriptions et de générer des images en temps réel, en optimisant les résultats en ajustant les paramètres.
Adresse du projet
Site officiel du projet :https://bytedance.github.io/XVerse/
Dépôt GitHub :https://github.com/bytedance/XVerse
Bibliothèque de modèles HuggingFace :https://huggingface.co/ByteDance/XVerse
Article technique arXiv :https://arxiv.org/pdf/2506.21416









