
 Assistant scénario▸
 Apps AI
 Actualités AI
Alibaba Ovis-U1 : un modèle unifié pour la compréhension multimodale, la génération et l'édition d'images
小编 ·

Alibaba Ovis-U1 : un modèle unifié pour la compréhension multimodale, la génération et l'édition d'images
Le 29 juin 2025, l'équipe internationale d'ai d'Alibaba a lancé le grand modèle multimodal Ovis-U1, la dernière version de la série Ovis, développé sur la base de l'architecture existante, avec une taille de paramètres de 300 millions.
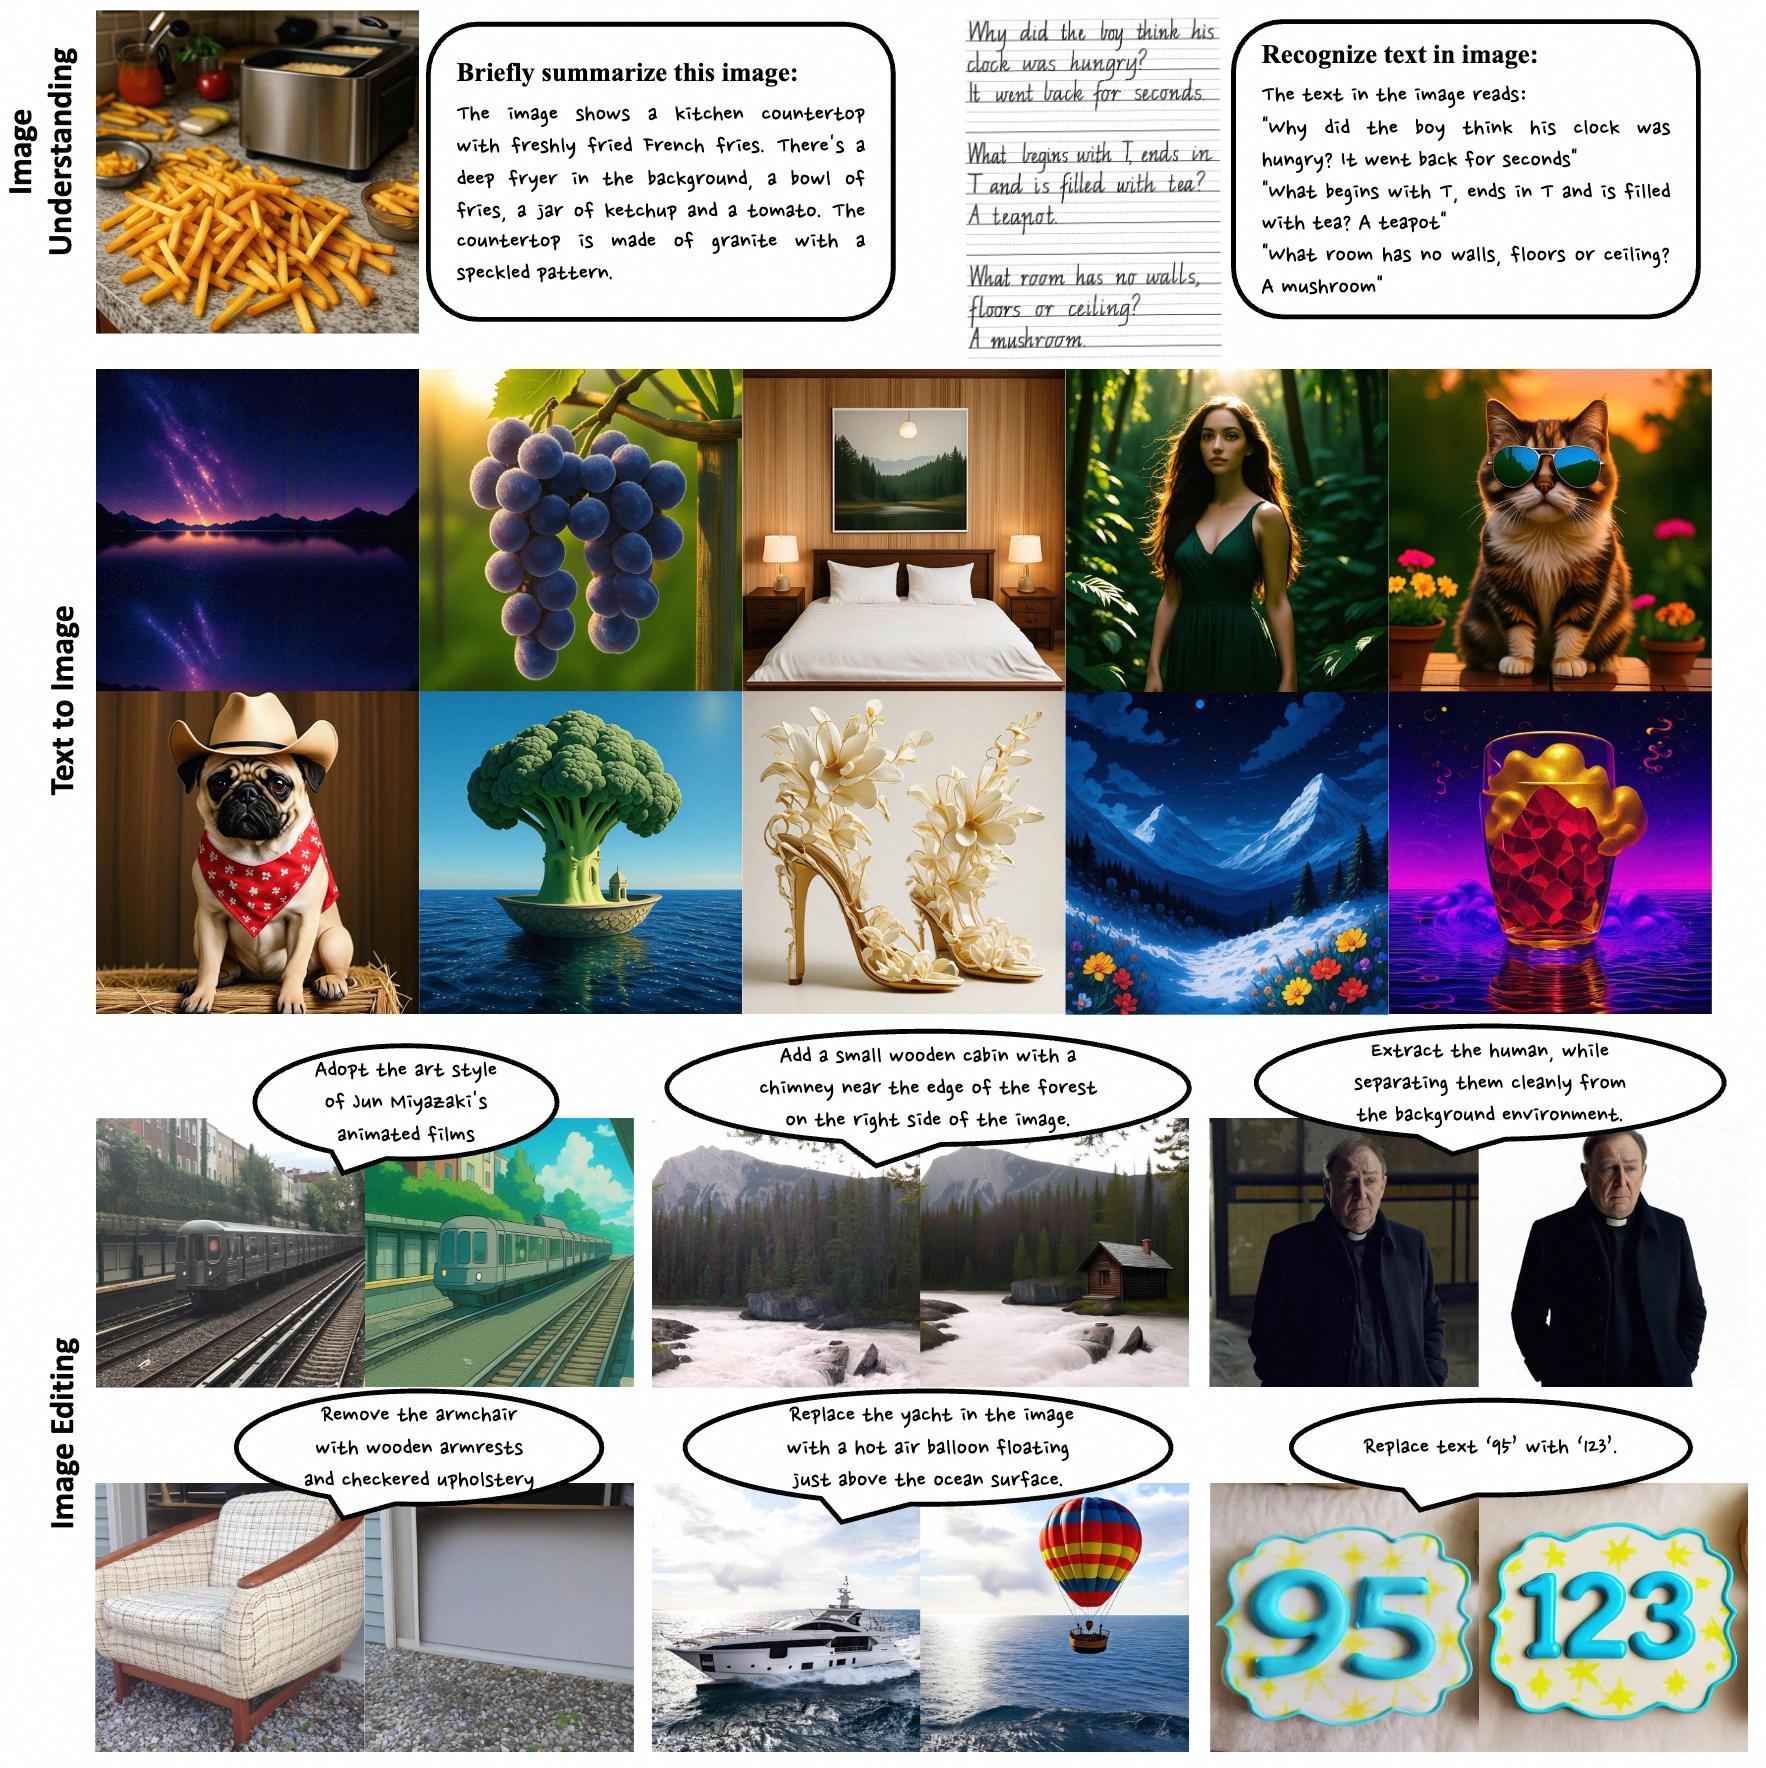
Ce modèle intègre des fonctionnalités de compréhension multimodale, de génération et d'édition d'images, dont les composants principaux incluent un tokeniseur visuel, une table d'embedding visuel et un grand modèle de langage. En optimisant la correspondance entre les embeddings visuels et textuels, il résout certaines limites des modèles multimodaux traditionnels et offre de meilleures performances dans des scénarios complexes. Il prend en charge les entrées textuelles et d'images, et excelle dans des tâches telles que le raisonnement mathématique et la reconnaissance d'objets. Il peut non seulement identifier avec précision les objets ou le texte manuscrit dans les images, mais aussi générer ou modifier des images selon les instructions.
Capacités principales
Compréhension multimodale : capable d'analyser des scènes visuelles complexes et du contenu textuel, de répondre à des questions relatives aux images, et d'accomplir des tâches telles que le questionnement visuel (VQA) et la génération de descriptions d'images.
Génération texte vers image : génère des images de haute qualité à partir de descriptions textuelles, adaptées à divers styles et besoins de scénarios complexes.
Édition d'images : permet d'ajouter, ajuster, remplacer ou supprimer des éléments d'images via des instructions textuelles, avec prise en charge de la conversion de style.
Architecture technique
Décodeur visuel : adopte une architecture Transformer basée sur la diffusion (MMDiT), transformant les embeddings textuels en images de haute qualité.
Raffineur de tokens bidirectionnel : renforce l'interaction entre les embeddings textuels et visuels, améliorant la synthèse et l'édition d'images.
Encodeur visuel : affiné à partir d'un modèle pré-entraîné (tel que Aimv2-large-patch14-448), adapté aux tâches multimodales.
Adaptateur : connecte l'encodeur visuel au grand modèle de langage multimodal (MLLM), alignant les deux types de données d'embedding.
Grand modèle de langage multimodal : en tant que module central, il traite les informations textuelles et visuelles et prend en charge le traitement multitâche.
Méthode d'entraînement
Ovis-U1 est entraîné de manière synchrone sur les tâches de compréhension multimodale, de génération et d'édition d'images, partageant les connaissances pour améliorer la capacité de généralisation. L'entraînement est divisé en six étapes pour optimiser progressivement les performances de chaque tâche.
Composition des données
Données de compréhension multimodale : provenant de jeux de données publics tels que COYO, Wukong, Laion, ainsi que de données développées en interne.
Données de génération d'images : basées sur les jeux de données Laion5B, JourneyDB et des descriptions détaillées générées par des modèles pré-entraînés.
Données d'édition d'images : couvrant des tâches telles que la génération pilotée par image de référence et le contrôle au niveau des pixels.
Optimisation des performances
Dans l'édition d'images, un ajustement précis du coefficient de guidage texte-image (CFG) permet de contrôler avec exactitude l'exécution des instructions. Des benchmarks tels qu'OpenCompass et GenEval sont utilisés pour évaluer de manière exhaustive les capacités du modèle.
Scénarios d'application
Création de contenu : assiste les artistes et les éditeurs de vidéo dans la conception créative.
Publicité et marketing : génère des images et affiches publicitaires en fonction des descriptions de produits et de public cible.
Développement de jeux : génère des images de scènes, personnages et objets de jeu.
Conception architecturale : produit des concepts architecturaux et des plans d'aménagement intérieur.
Recherche scientifique : visualise des phénomènes scientifiques complexes et des scénarios expérimentaux.
Dans la continuité de la tradition open source de la série Ovis, le code du modèle, les poids et les données d'entraînement ont été rendus publics sous licence Apache 2.0 sur Hugging Face et GitHub, permettant aux développeurs de reproduire et déployer rapidement le modèle.
Adresses du projet
Dépôt GitHub :https://github.com/AIDC-AI/Ovis-U1
Bibliothèque de modèles HuggingFace :https://huggingface.co/AIDC-AI/Ovis-U1-3B
Article technique :https://github.com/AIDC-AI/Ovis-U1/blob/main/docs/Ovis_U1_Report.pdf
Expérience en ligne :https://huggingface.co/spaces/AIDC-AI/Ovis-U1-3B









