
 Assistant scénario▸
 Apps AI
 Actualités AI
OmniGen2 : la version open source de Flux.1 Kontext
小编 ·

OmniGen2 : la version open source de Flux.1 Kontext
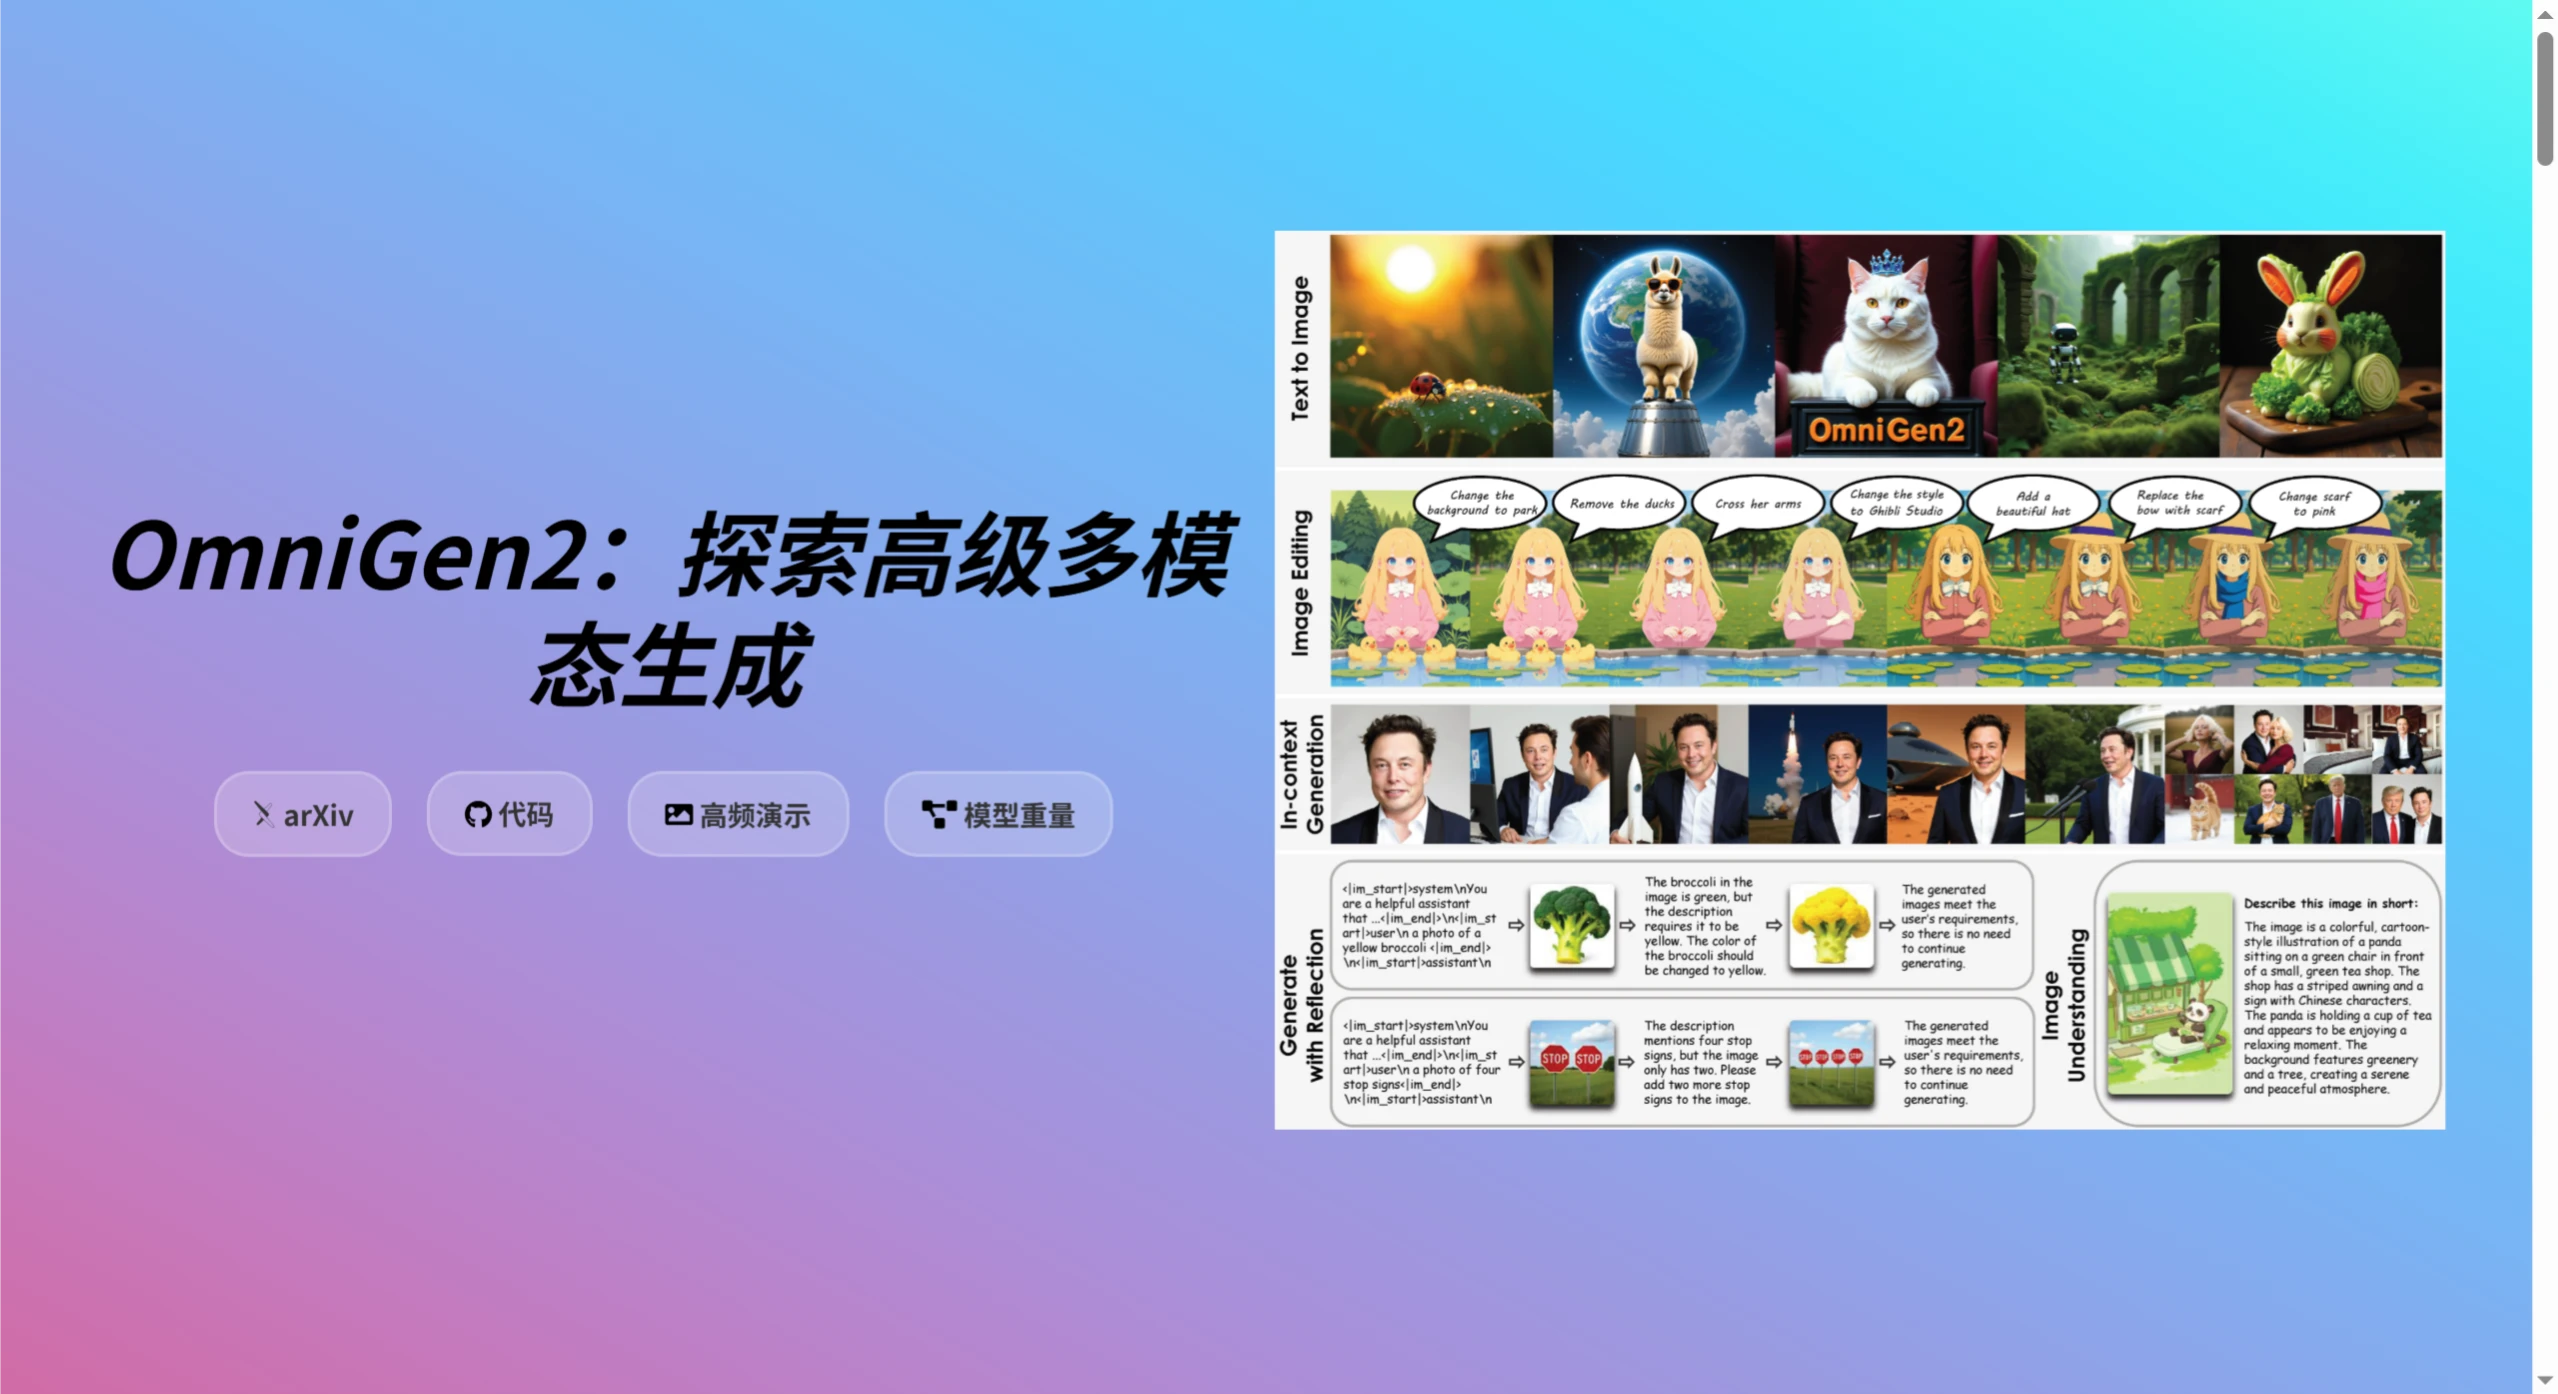
OmniGen2 est un modèle de génération multimodale lancé par l'Institut de recherche BAAI. Semblable à Flux.1 Kontext, il peut modifier des images via du texte. Il intègre dans un même cadre la compréhension visuelle, la synthèse texte-vers-image, l'édition d'images basée sur des instructions, ainsi que la génération contextuelle pilotée par un sujet. Ce modèle adopte une architecture découplée qui, tout en préservant les capacités de modélisation du langage, est capable de produire des effets visuels aux détails fins et au style cohérent. De plus, il introduit un mécanisme de réflexion multimodale permettant d'analyser, d'examiner et d'optimiser de manière itérative les résultats générés, intégrant ainsi le raisonnement et l'auto-correction dans le processus de génération d'images. Cela lui permet d'obtenir d'excellentes performances aussi bien sur les tâches de génération que de compréhension, devenant ainsi une nouvelle référence parmi les modèles open source légers.
Fonctionnalités principales
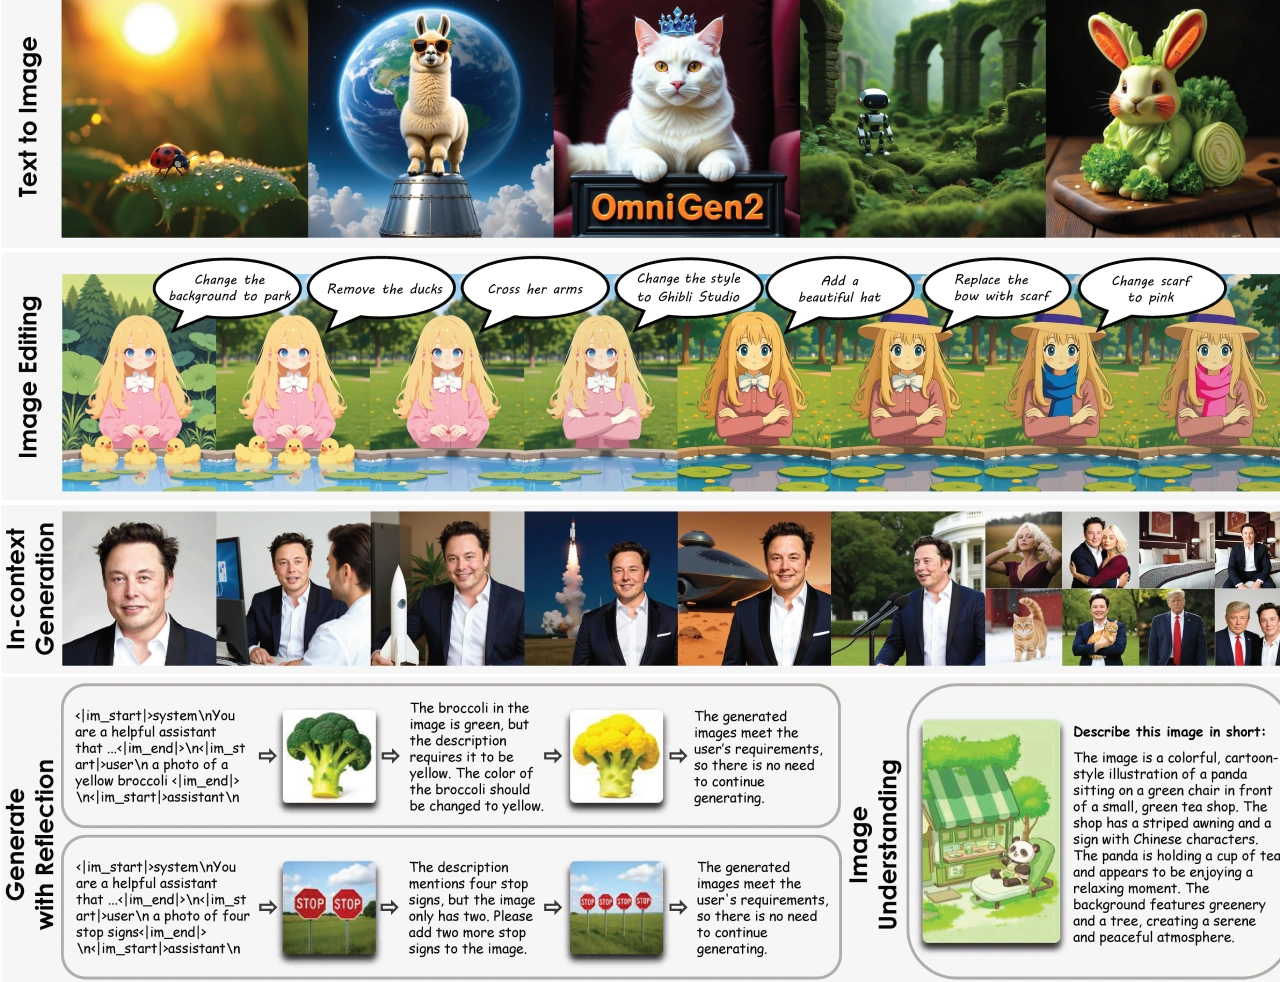
Génération texte-vers-image : les utilisateurs peuvent générer des images de diverses scènes et personnages à partir de descriptions textuelles, par exemple « un chat portant une couronne allongé sur un trône en velours » ou « un sorcier maléfique lançant un sortilège dans une grotte ancienne ».
Fonction d'édition d'image : prend en charge diverses modifications des images générées, comme changer la couleur des vêtements, remplacer l'arrière-plan, ou encore ajouter ou supprimer des éléments de l'image.
Transfert de style : permet de convertir une image dans différents styles artistiques, par exemple le style anime ou le style peinture à l'huile.
Composition de personnages et de scènes : peut combiner des personnages ou des éléments provenant de différentes images dans une nouvelle scène, par exemple « faire en sorte que la fille de la première image et le garçon de la deuxième image se marient dans une église ».
Caractéristiques
Sortie de haute qualité : les images générées sont riches en détails et offrent des effets visuels remarquables.
Capacités d'édition flexibles : offre de nombreuses options d'édition, permettant aux utilisateurs de personnaliser les images selon leurs besoins.
Nature open source : en tant que projet open source, il offre aux développeurs et aux chercheurs davantage de possibilités d'exploration et de développement.
Cas d'utilisation
Conception créative : les designers peuvent utiliser OmniGen2 pour générer rapidement des concepts et des esquisses de design.
Création de contenu : les créateurs de contenu peuvent générer des images de diverses scènes et personnages, pour la création d'histoires, la production de vidéos et autres scénarios.
Éducation et recherche : les enseignants et les chercheurs peuvent l'utiliser comme outil pédagogique et de recherche pour explorer les applications des technologies de génération multimodale.
Exemples d'application
Génération d'images : générer des images de diverses scènes et personnages à partir de descriptions textuelles, par exemple « un chat portant une couronne allongé sur un trône en velours ».
Édition d'images : modifier les images générées, par exemple changer la couleur des vêtements, remplacer l'arrière-plan, etc.
Composition d'images : combiner les éléments de différentes images dans une nouvelle scène, par exemple « faire en sorte que la fille de la première image et le garçon de la deuxième image se marient dans une église ».
Questions clés
1. Quelle est l'innovation principale d'OmniGen2 ?
L'innovation principale d'OmniGen2 réside dans l'adoption d'une architecture à double chemin découplée intégrant des capacités de génération multimodale, l'introduction d'un mécanisme de réflexion multimodale permettant l'auto-optimisation des sorties, ainsi que la conception d'un codage positionnel Omni-RoPE pour améliorer la cohérence de l'édition d'images et de la génération contextuelle. Ces innovations lui permettent d'établir une nouvelle référence parmi les modèles open source légers.
2. Quelles opérations spécifiques OmniGen2 peut-il réaliser en matière d'édition d'images ?
OmniGen2 peut effectuer diverses opérations précises en édition d'images, notamment la gestion d'objets (par exemple ajouter ou supprimer des objets, comme ajouter un chapeau de pêcheur à un personnage ou retirer le chat de l'image), le transfert de style (par exemple transformer l'arrière-plan en scène de classe, ou convertir le style en style studio Ghibli), l'ajustement des couleurs (par exemple changer la couleur de la robe en bleu), la modification des expressions (par exemple faire sourire un personnage), l'édition d'actions (par exemple faire lever la main à un personnage), tout en maintenant le réalisme visuel et la cohérence des zones non éditées.
3. Comment le mécanisme de réflexion multimodale améliore-t-il la qualité de génération d'OmniGen2 ?
Le mécanisme de réflexion multimodale permet à OmniGen2 d'évaluer ses propres résultats générés, d'identifier les incohérences entre la description et le contenu de l'image (par exemple, lorsqu'on a demandé « trois pizzas » mais que l'image n'en contient qu'une, il suggère d'en ajouter), les erreurs de couleur ou de position (par exemple, un broccoli jaune généré en vert, ce qui déclenche une suggestion de changement de couleur, ou un chien apparaissant sur une chaise au lieu de la table jaune, ce qui déclenche une suggestion de repositionnement), et d'optimiser de manière itérative les résultats pour mieux répondre aux exigences, améliorant ainsi la contrôlabilité, la fiabilité et la qualité des sorties.
Page du projet :https://vectorspacelab.github.io/OmniGen2/
Article technique :https://github.com/VectorSpaceLab/OmniGen2
Essai en ligne :https://huggingface.co/OmniGen2/OmniGen2
Remarque :Flux.1 Kontext est un outil de génération et d'édition d'images développé par le laboratoire allemand Black Forest Labs. Il peut générer et éditer des images à partir d'invites textuelles et visuelles, notamment modifier des objets, transformer des styles, remplacer des arrière-plans, maintenir la cohérence des personnages et éditer du texte. Contrairement aux modèles traditionnels de texte à image, il prend en charge la génération d'images contextuelles, capable de combiner simultanément des invites textuelles et visuelles pour extraire et modifier directement des concepts visuels, et générer de nouvelles images cohérentes.









