
 Assistant scénario▸
 Apps AI
 Actualités AI
DreamActor-H1 : générez des vidéos de personnes présentant des produits, idéal pour les clips promotionnels
小编 ·

DreamActor-H1 : générez des vidéos de personnes présentant des produits, idéal pour les clips promotionnels
DreamActor-H1 est un cadre de génération de vidéo lancé par ByteDance en juin 2025. Il repose sur la technologie des transformateurs de diffusion (DiT) et s'adresse principalement aux domaines du e-commerce et du marketing numérique. Il peut être utilisé pour générer des vidéos promotionnelles de produits.
Ce cadre permet de générer des vidéos de démonstration de haute qualité mettant en scène une personne et un produit, à partir de paires d'images du corps humain et du produit. Grâce à un entraînement renforcé multi-catégories sur un vaste ensemble de données mixtes, il surpasse les méthodes existantes en matière de préservation de l'identité de la personne et du produit, ainsi que dans la génération de mouvements de démonstration conformes aux lois de la physique. Il convient donc aux publicités personnalisées de commerce électronique et aux médias interactifs. Il s'appuie sur un modèle de maillage corporel 3D et les boîtes englobantes des produits pour fournir un guidage précis des mouvements, combinant des conseils d'apparence encodés par VAE, une sémantique au niveau des catégories encodée par du texte structuré, ainsi que des mécanismes d'attention de référence et d'attention aux objets. Cela permet de résoudre les problèmes des cadres existants en matière de préservation de l'identité et de compréhension des relations spatiales.
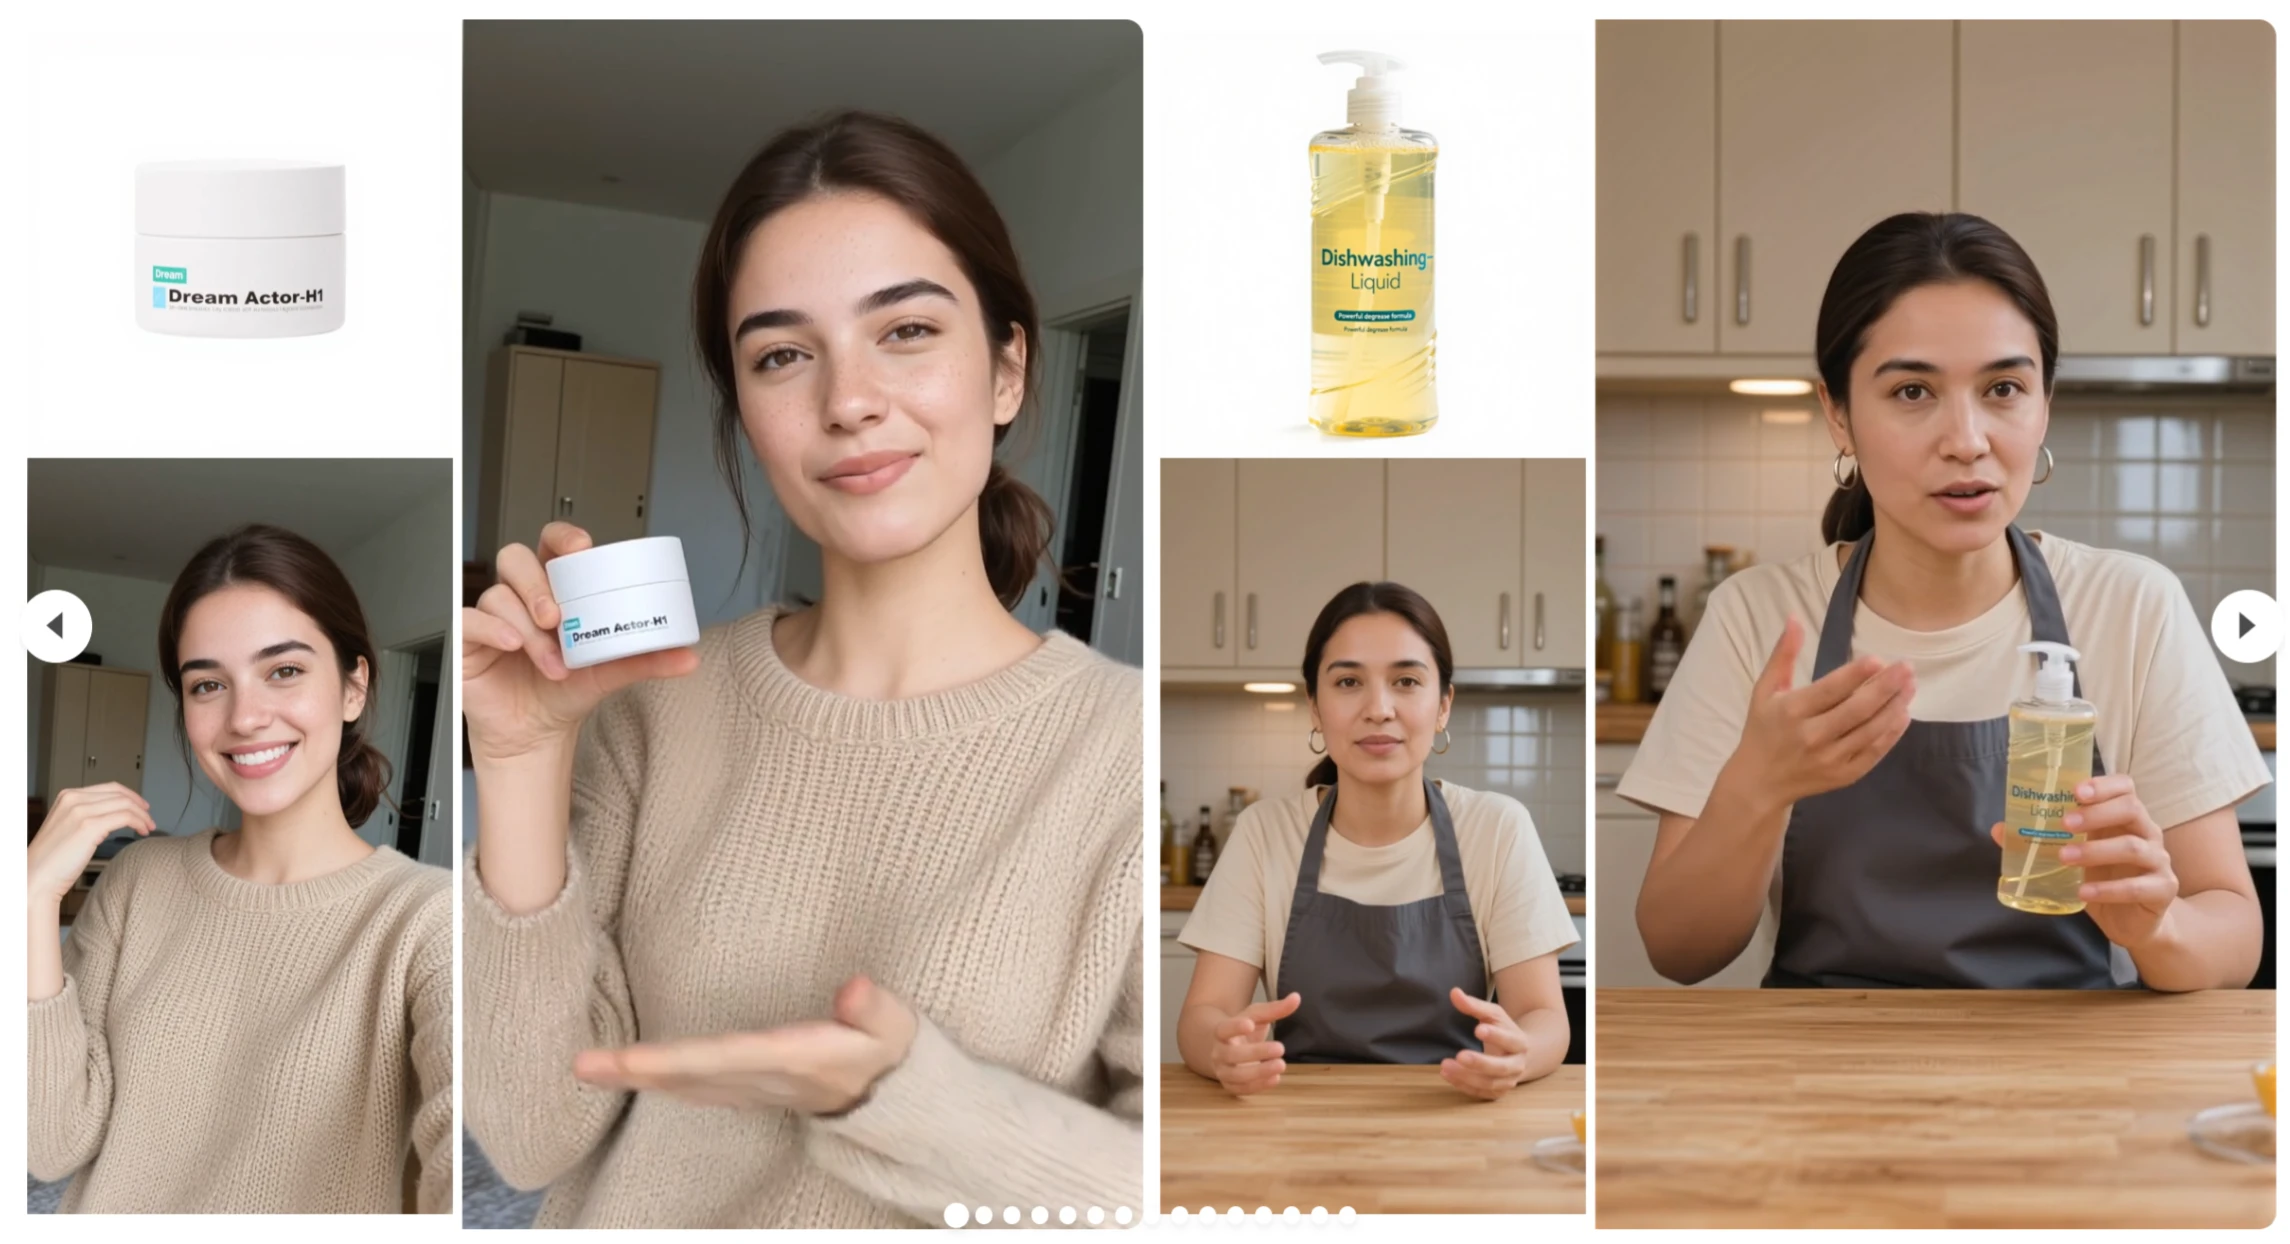
Les principaux avantages de DreamActor-H1 :
Alignement dynamique personne-objet : il associe automatiquement les gestes à la position du produit. Par exemple, lors de la démonstration du geste « prendre un produit cosmétique », les points de contact entre les doigts et le flacon s'ajustent naturellement, sans intersection ni décalage. De plus, il prend en charge un guidage conjoint à l'aide du modèle de maillage corporel humain 3D et des boîtes englobantes des produits, garantissant que les mouvements respectent les lois physiques telles que la gravité et l'angle de préhension.
Fidélité des détails multi-dimensionnelle : pour préserver la cohérence de l'identité de la personne, il conserve des caractéristiques telles que la coiffure et le teint de la peau ; pour les produits, il offre une reproduction très fidèle, restituant précisément les textures des matériaux, les logos et d'autres détails.
Cohérence 3D renforcée par la sémantique : combinée à des descriptions textuelles au niveau de la catégorie, comme « faire pivoter un rouge à lèvres pour le présenter », elle permet des images plus fluides lors de petites rotations, évitant ainsi les tremblements ou les déformations du produit.
Principe technique :
Phase de traitement des données : la modélisation vision-langage (VLM) analyse les instructions textuelles, par exemple « retourner un téléphone tenu en main ». Ensuite, l'estimation de la posture génère la squelette du corps humain, combiné aux boîtes englobantes des produits pour construire les relations spatiales, afin d'extraire les caractéristiques de mouvement.
Conception de l'architecture du modèle : l'attention globale gère la cohérence temporelle de l'ensemble de l'image ; l'attention de référence injecte les caractéristiques des images de référence de la personne ou du produit ; l'attention aux objets traite spécifiquement les caractéristiques latentes du produit afin de garantir qu'aucun détail ne soit perdu. Le transformateur de diffusion (DiT) à triple mécanisme d'attention repose sur le modèle de base de 7 milliards de paramètres Seaweed - 7B, et fusionne les informations de la personne et de l'objet grâce à une attention croisée masquée.
Optimisation de l'inférence : il récupère dynamiquement une bibliothèque prédéfinie de modèles de mouvement et ajuste l'échelle des boîtes englobantes des objets, par exemple en agrandissant la boîte des produits de petite taille.
Les scénarios d'application de DreamActor-H1 :
Streaming e-commerce : il permet de générer automatiquement des vidéos de démonstration de présentateurs virtuels tenant des produits, ce qui réduit les coûts du streaming et améliore son efficacité.
Marketing publicitaire : il permet de produire à moindre coût des animations multi-angles présentant l'utilisation d'un produit, comme la rotation d'une paire de chaussures, afin d'attirer l'attention des consommateurs.
Limites de DreamActor-H1 :
Limitations liées aux produits : actuellement, seuls les objets de petite et moyenne taille sont pris en charge ; les appareils électroménagers de grande taille ne peuvent pas être traités.
Dépendance aux modèles de mouvement : les actions doivent être prédéfinies, comme « ramasser un objet sur une table », et cela dépend de la correspondance avec la posture initiale de la personne.
Imperfections dynamiques : lors de mouvements rapides, la texture du produit peut présenter des scintillements.
Processus d'utilisation de DreamActor-H1 pour générer une vidéo promotionnelle :
Préparation des ressources : préparez une image d'une personne et une image d'un produit. Pour l'image de la personne, il est recommandé de choisir une photo de face, en plan rapproché, avec une résolution supérieure à 800 * 800, afin de garantir la clarté des caractéristiques de la personne dans la vidéo générée. L'image du produit doit montrer clairement tous les détails du produit, tels que le logo, la texture, etc.
Saisie des instructions textuelles : selon les besoins de la promotion, saisissez des descriptions textuelles au niveau de la catégorie, par exemple « retourner un téléphone tenu en main » ou « présenter les détails d'un rouge à lèvres », afin de fournir à la génération vidéo des indications précises sur les actions et la présentation.
Génération de la vidéo : saisissez les ressources préparées et les instructions textuelles dans le système DreamActor-H1. Le système les traitera sur la base d'une architecture collaborative en plusieurs étapes et d'un mécanisme d'attention mixte. Lors de la phase de traitement des données, la modélisation vision-langage (VLM) analyse les instructions textuelles, et le module d'extraction des caractéristiques de mouvement génère la squelette du corps humain via l'estimation de la posture tout en construisant les relations spatiales à l'aide des boîtes englobantes des produits ; dans l'architecture du modèle, l'attention globale, l'attention de référence et l'attention aux objets travaillent en synergie pour finalement générer une vidéo de démonstration d'interaction homme-machine de haute fidélité.
Les adresses du projet sont les suivantes :
Page du projet :https://submit2025-dream.github.io/DreamActor-H1/
Article scientifique :https://arxiv.org/abs/2506.10568









