
 Assistant scénario▸
 Apps AI
 Actualités AI
GUIRoboTron-Speech : le premier agent GUI à interaction vocale signé Meituan et l'Université du Zhejiang
小编 ·

GUIRoboTron-Speech : le premier agent GUI à interaction vocale signé Meituan et l'Université du Zhejiang
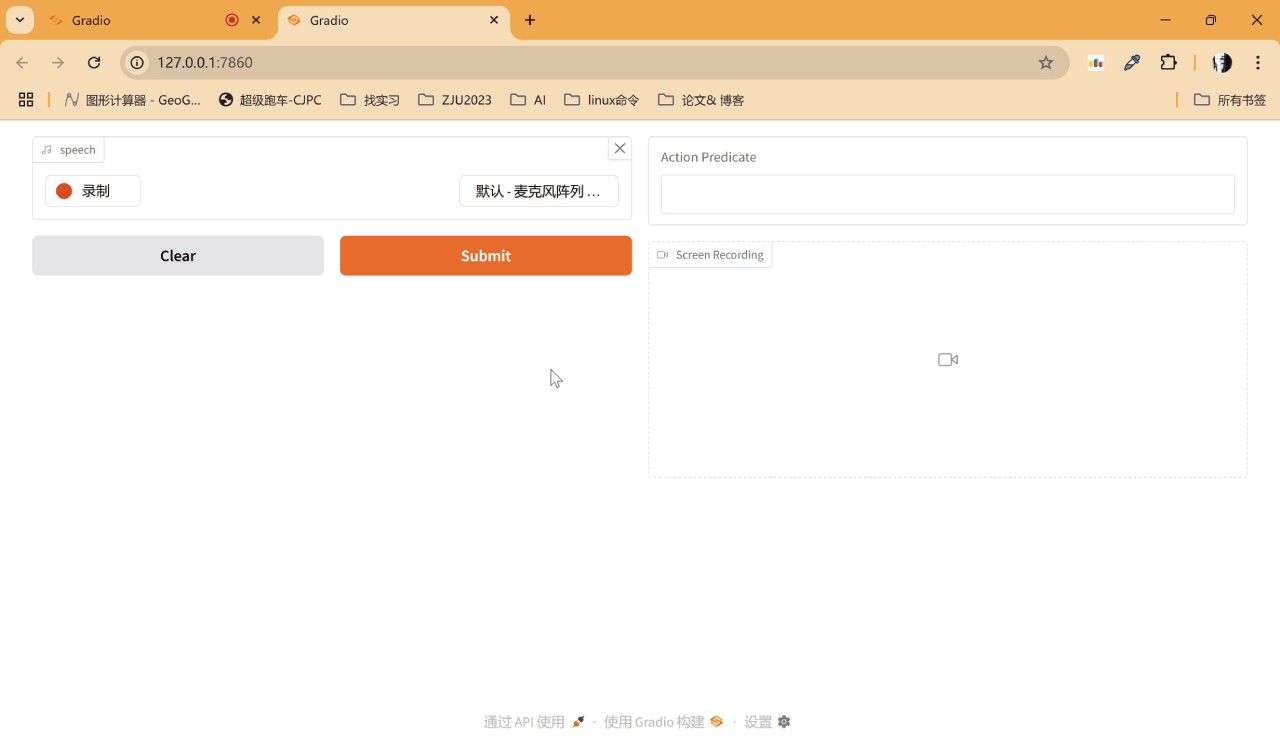
Meituan et l'Université du Zhejiang ont développé conjointement GUIRoboTron-Speech, un agent IA d'interface graphique capable de prendre des décisions directement à l'aide d'instructions vocales et de captures d'écran d'appareils. Il permet aux utilisateurs de contrôler leur ordinateur par la voix et via des captures d'écran, évitant ainsi les inconvénients de la saisie de texte traditionnelle.
GUIRoboTron-Speech surmonte les limites liées à la dépendance traditionnelle au texte. L'équipe a réussi à entraîner cet agent en créant un ensemble de données vocales de haute qualité, en procédant à un entraînement par étapes et en utilisant une stratégie d'entraînement par instructions mixtes, ce qui lui permet d'exceller dans de multiples tâches. Les recherches ont montré que, lorsque l'intention de l'utilisateur est claire, les instructions vocales permettent de mener les tâches à bien avec un taux de réussite plus élevé que les instructions textuelles. À l'avenir, ses capacités de traitement d'instructions complexes continueront d'être améliorées.
Fonctionnalités principales
Pilotage par instructions vocales : GUIRoboTron-Speech peut recevoir directement des instructions vocales ainsi que des captures d'écran de l'appareil pour prédire et exécuter des actions. Les utilisateurs n'ont plus besoin de saisir du texte manuellement et peuvent contrôler l'agent GUI uniquement par la voix.
Interaction multimodale : Il combine les modalités vocale et visuelle, ce qui lui permet de comprendre avec précision la correspondance entre les instructions vocales et les éléments visuels de l'interface graphique.
Méthodologie de recherche et développement
Génération de jeux de données : En raison du manque de jeux de données d'instructions vocales, l'équipe a utilisé un modèle avancé de text-to-speech (TTS) avec des voix aléatoires pour convertir un grand jeu de données d'instructions textuelles en un jeu de données d'instructions vocales avec divers styles de parole et timbres.
Cadre d'entraînement progressif : L'entraînement se fait en deux étapes :
Étape de Grounding : Le modèle apprend la correspondance précise entre les instructions vocales et les éléments visuels de l'interface graphique, par exemple comprendre « cliquer sur le bouton 'OK' » et localiser ce bouton dans la capture d'écran.
Étape de Planning : Le modèle apprend à exécuter des tâches complexes en plusieurs étapes, comme « se connecter d'abord au compte, puis trouver le dernier e-mail et ouvrir la pièce jointe », faisant preuve de raisonnement logique et de capacité de planification de tâches.
Stratégie d'entraînement par instructions mixtes : Pour résoudre le problème de déséquilibre modal du modèle pré-entraîné, l'équipe a mélangé des instructions vocales et textuelles pendant l'entraînement, permettant ainsi au modèle de traiter les deux types d'entrées de manière équitable.
Performances
Comparaison des modalités d'instruction : Dans la tâche ScreenSpot, le modèle entraîné uniquement avec des instructions vocales présente une précision de grounding moyenne inférieure de 1,6 % à celui entraîné uniquement avec des instructions textuelles. Cependant, après l'adoption de la stratégie d'instructions mixtes, la précision a été améliorée de 1,9 %.
Grounding visuel de l'interface graphique : Dans les domaines Mobile et Web, les performances de GUIRoboTron-Speech utilisant des instructions vocales sont comparables à celles des méthodes de pointe basées sur des instructions textuelles.
Exécution de tâches en plusieurs étapes : Sur des jeux de données de tâches en plusieurs étapes tels qu'AndroidControl et GUIOdyssey, ses performances sont comparables à celles de certains modèles de pointe basés sur des instructions textuelles.
Avantages et signification
Amélioration de la commodité de l'interaction : Les utilisateurs n'ont plus besoin de saisir du texte manuellement lorsqu'ils utilisent leurs appareils et peuvent effectuer diverses opérations par commande vocale, ce qui améliore considérablement la commodité de l'interaction.
Élargissement des scénarios d'application : Cette technologie convient non seulement aux opérations quotidiennes pratiques des utilisateurs lambda, mais aussi aux scénarios spécifiques nécessitant l'usage des deux mains, tels que la conduite ou le domaine médical, offrant ainsi un mode d'interaction plus sûr et plus efficace.
Promotion du développement technologique : GUIRoboTron-Speech apporte de nouvelles idées et méthodes pour l'application de la technologie d'interaction vocale dans le domaine des interfaces graphiques, favorisant ainsi le développement des technologies connexes.
Liens du projet
Article scientifique :https://arxiv.org/abs/2506.11127
Dépôt Github :https://github.com/GUIRoboTron/GUIRoboTron-Speech









