
 Assistant scénario▸
 Apps AI
 Actualités AI
Nanonets-OCR-s : un modèle qui convertit les tableaux d'images en Markdown
小编 ·

Nanonets-OCR-s : un modèle qui convertit les tableaux d'images en Markdown
Qu'est-ce que Nanonets-OCR-s ?
Nanonets-OCR-s permet de convertir les tableaux présents dans les images au format Markdown, et reconnaît également la syntaxe LaTeX. Il peut aussi repérer la position des images et les convertir en balises <img>. Les signatures sont converties en balises <signature>, et les symboles tels que les cases à cocher sont représentés à l'aide d'émoticônes. Il peut également gérer les tableaux avec cellules fusionnées et les exporter au format HTML. La taille de ce modèle est de 3,75B, et il est basé sur un fine-tuning de Qwen2.5-VL-3B-Instruct, ce qui lui confère un excellent support du chinois.
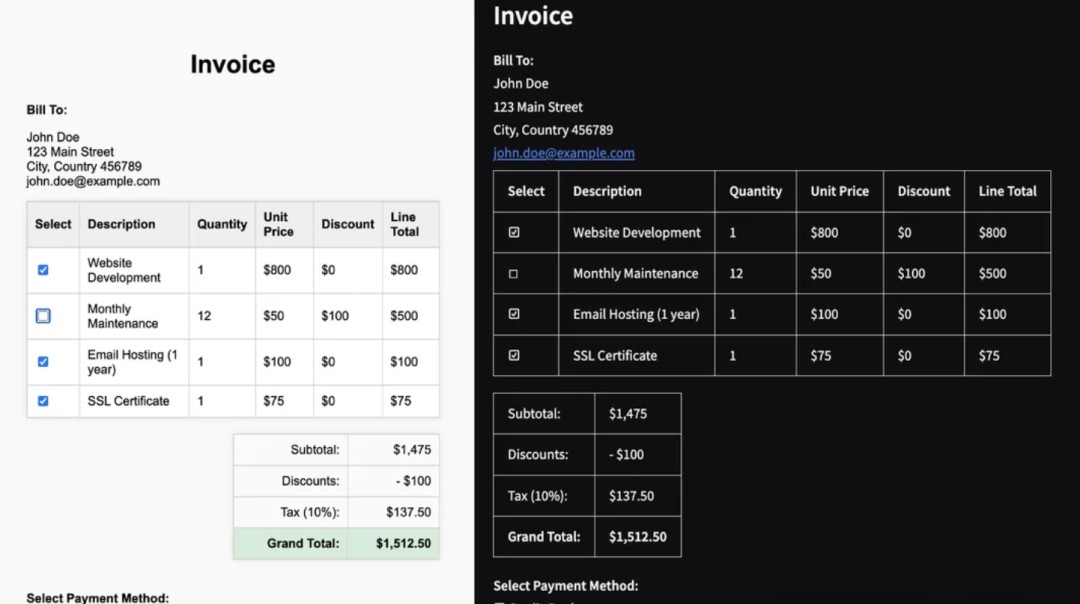
Fonctionnalités phares
Conversion de tableaux : extraction précise de tableaux complexes et conversion en formats Markdown et HTML clairs.
Reconnaissance de formules : conversion précise des formules mathématiques présentes dans les documents en syntaxe LaTeX, qu'il s'agisse de formules inline ou de formules isolées.
Traitement d'images : identification automatique des images dans les documents et description à l'aide de balises <img>, facilitant le traitement ultérieur.
Extraction de signatures et de filigranes : détection des signatures et filigranes dans les documents, marqués respectivement par les balises <signature> et <watermark>.
Gestion des cases à cocher : conversion des cases à cocher et boutons radio présents dans les documents en symboles Unicode standards, facilitant la lecture et l'édition.
Mode d'emploi
Via la bibliothèque Python :
Installer les bibliothèques nécessaires (comme transformers, etc.).
Charger le modèle pré-entraîné, puis traiter l'image et en extraire le contenu.
Via une interface serveur :
Démarrer le serveur, envoyer des requêtes via Python et un client associé, puis obtenir les résultats de conversion.
Via des outils simplifiés :
Utiliser des outils comme docext pour lancer l'application en un clic, simplifiant ainsi le flux de travail.
Cas d'usage
Recherche académique : conversion rapide des formules, figures et tableaux présents dans les articles scientifiques au format Markdown éditable, facilitant l'organisation et la poursuite des recherches.
Travail bureautique en entreprise : traitement de contrats, de rapports et autres documents, extraction des informations importantes tout en conservant une mise en forme cohérente, pour améliorer l'efficacité au travail.
Domaine juridique : identification et isolement des éléments importants tels que les signatures et les filigranes, afin de garantir l'intégrité et l'exactitude des documents.
Avantages
Très performant : capable de reconnaître de nombreux éléments de documents, répondant aux besoins de divers scénarios.
Intelligent et efficace : grâce à la reconnaissance intelligente et au balisage sémantique, le contenu généré est plus facile à traiter.
Léger et pratique : taille de modèle modérée, optimisé à partir de technologies existantes, avec prise en charge du chinois.
Adresse du projet
https://huggingface.co/nanonets/Nanonets-OCR-s









