
 Assistant scénario▸
 Apps AI
 Actualités AI
VRAG-RL : un framework RAG basé sur la perception visuelle de l'équipe Tongyi d'Alibaba
小编 ·

VRAG-RL : un framework RAG basé sur la perception visuelle de l'équipe Tongyi d'Alibaba
Qu'est-ce que VRAG-RL ?
VRAG-RL est un modèle basé sur un cadre RAG à perception visuelle récemment lancé par l'équipe Tongyi d'Alibaba. Ce modèle permet une amélioration des performances de 30 % sur Qwen2.5-VL-3B et de 20 % sur Qwen2.5-VL-7B.
Grâce à un entraînement par apprentissage par renforcement, VRAG-RL permet au modèle de disposer de capacités de réflexion et de raisonnement multi-tours, renforçant progressivement la compréhension du modèle vision-langage (VLM) ainsi que la précision des réponses. Il définit un espace d'actions de perception visuelle, permettant au modèle de se concentrer, du grossier au fin, sur les zones denses en informations et d'extraire précisément les informations visuelles clés, améliorant ainsi les capacités du VLM en matière de recherche, de raisonnement et de compréhension des informations visuelles.
De plus, VRAG-RL possède des capacités de recherche multimodale et de raisonnement itératif : à travers des interactions multi-tours, il affine progressivement sa compréhension des informations visuelles pour finalement générer des réponses précises et complètes. Il convient à de nombreuses tâches visuelles, telles que la compréhension d'images, l'analyse de graphiques, et l'analyse de mises en page complexes.
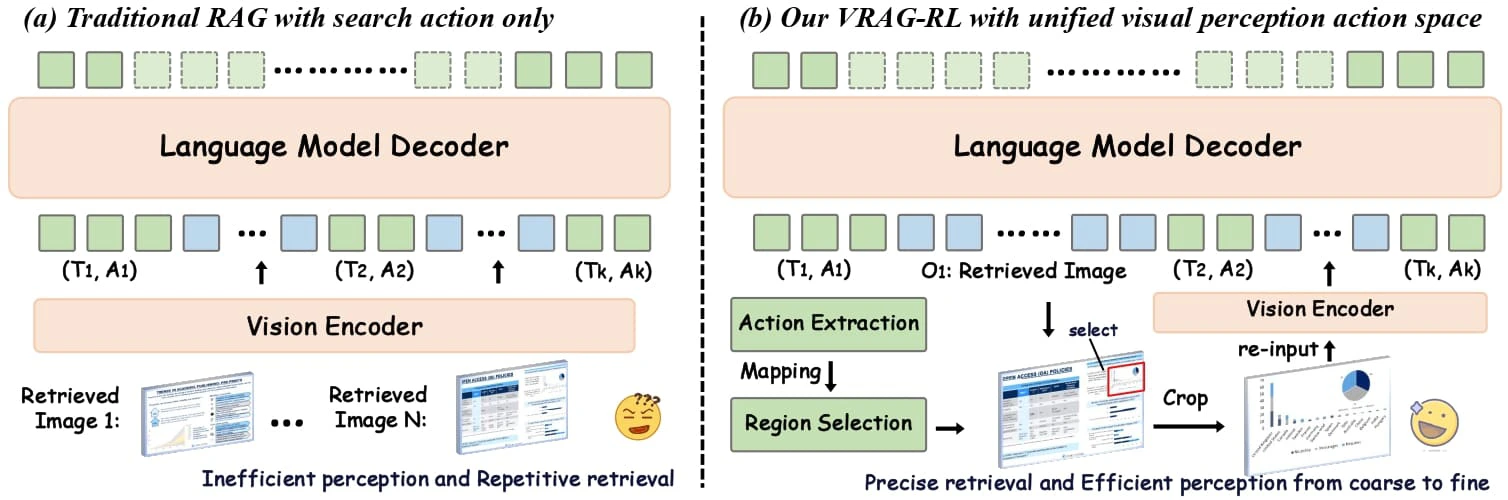
Les limites des méthodes RAG traditionnelles
Capacités insuffisantes de traitement de l'information visuelle : incapacité à analyser efficacement les informations contenues dans les images, manquant de compréhension et de raisonnement sur les données visuelles.
Processus fixes limitant le raisonnement dynamique : elles utilisent principalement des pipelines fixes de recherche-génération, ce qui rend difficile l'ajustement dynamique du chemin de raisonnement dans des tâches complexes, limitant ainsi la capacité du modèle à exploiter les informations visuelles.
Efficacité de recherche et profondeur de raisonnement insuffisantes : lors du traitement de tâches visuelles complexes, elles localisent souvent mal les informations clés, ce qui conduit à des résultats générés peu précis.
Les innovations clés de VRAG-RL
Espace d'actions de perception visuelle : introduction de diverses actions de perception visuelle, telles que la sélection de régions, le recadrage et le zoom, permettant au modèle de se concentrer progressivement, du grossier au fin, sur les zones denses en informations et d'extraire précisément les informations visuelles clés. Cette perception du grossier au fin améliore non seulement la compréhension des informations visuelles par le modèle, mais augmente aussi considérablement l'efficacité de la recherche.
Cadre d'apprentissage par renforcement : optimisation des capacités de raisonnement et de recherche du modèle via l'apprentissage par renforcement (RL). Le modèle interagit sur plusieurs tours avec un moteur de recherche, échantillonne de manière autonome des trajectoires de raisonnement à un ou plusieurs tours, et s'optimise en continu sur la base de ces échantillons.
Mécanisme de récompense global : conception d'une fonction de récompense globale incluant une récompense d'efficacité de recherche, une récompense de cohérence de schéma et une récompense basée sur les résultats du modèle. Ce mécanisme de récompense se concentre sur le résultat final et optimise le processus de recherche, permettant au modèle d'obtenir plus efficacement les informations pertinentes.
Stratégie d'échantillonnage multi-experts : combinaison des capacités de raisonnement des grands modèles et de la précision d'annotation des modèles experts, permettant au modèle d'apprendre des stratégies de perception visuelle plus efficaces.
Entraînement par interactions multi-tours : grâce à une stratégie d'entraînement par interactions multi-tours, le modèle optimise progressivement son processus de raisonnement au fil de ses interactions continues avec l'environnement externe, améliorant la stabilité et la cohérence du raisonnement.
Les avantages techniques de VRAG-RL
Performances améliorées : les résultats expérimentaux montrent que VRAG-RL obtient des performances nettement supérieures aux méthodes existantes sur plusieurs ensembles de données de référence en vision-langage. Les types de tâches couvrent un large éventail de scénarios riches en visuel, allant du raisonnement à un saut au raisonnement multi-sauts, de la compréhension purement textuelle à la reconnaissance de graphiques et à l'analyse de mises en page complexes.
Prise en charge des interactions multi-tours : capable, lors de la phase de raisonnement, de se concentrer progressivement sur les zones denses en informations, permettant une acquisition d'informations du grossier au fin.
Entraînement efficace : introduction de l'algorithme GRPO de pointe du secteur, simulant des scénarios d'application réels grâce à un déploiement local d'un moteur de recherche, permettant un coût nul pour les appels au moteur de recherche et un entraînement du modèle plus efficace.
Les cas d'application de VRAG-RL
Analyse de graphiques complexes : extraction de données clés à partir de rapports financiers et de graphiques scientifiques.
Analyse de maquettes de design : compréhension et raisonnement sur la disposition et les éléments des maquettes de design.
Recherche documentaire : recherche efficace d'informations dans des bases de connaissances documentaires contenant des images et des tableaux.
Questions-réponses multimodales : combinaison de texte et d'images pour un raisonnement multi-sauts, permettant de répondre à des questions complexes.
Liens du projet
Dépôt GitHub :https://github.com/Alibaba-NLP/VRAG
Bibliothèque de modèles HuggingFace :https://huggingface.co/collections/autumncc/vrag-rl
Article technique arXiv :https://arxiv.org/pdf/2505.22019









