
 Assistant scénario▸
 Apps AI
 Actualités AI
HunyuanVideo-Avatar : modèle d'humain numérique piloté par l'audio de Tencent Hunyuan
小编 ·

HunyuanVideo-Avatar : modèle d'humain numérique piloté par l'audio de Tencent Hunyuan
Qu'est-ce que HunyuanVideo-Avatar ?
HunyuanVideo - Avatar est un modèle de humain numérique piloté par la voix, publié en open source par Tencent Hunyuan, basé sur son grand modèle de vidéo (HunyuanVideo). Grâce au pilotage audio, la technologie HunyuanVideo-Avatar est capable de générer des vidéos dynamiques de personnages, montrant la parole, les mouvements du corps et de la tête ainsi que les expressions du personnage, et prend en charge les scènes interactives avec plusieurs personnages. L'objectif est de résoudre trois défis majeurs dans le domaine de l'animation de personnages pilotée par l'audio : générer des vidéos à forte dynamique tout en maintenant la cohérence des personnages, parvenir à un alignement émotionnel précis entre les personnages et l'audio, et prendre en charge l'animation pilotée par l'audio pour plusieurs personnages.
Fonctionnalités de HunyuanVideo - Avatar
Prise en charge de plusieurs plans : prise en charge des plans en gros plan (tête et épaules), en plan américain et en plan plein, permettant aux utilisateurs de choisir l'angle de prise de vue approprié selon leurs besoins.
Styles multiples et scènes multi-espèces : prise en charge de plusieurs styles (tels que cyberpunk, animation 2D, peinture chinoise à l'encre, etc.), de plusieurs espèces (y compris les robots, les animaux, etc.) ainsi que des scènes à deux personnages.
Génération de vidéo à haute cohérence et haute dynamique : capable de comprendre automatiquement le contenu de l'image et de l'audio à partir de l'image du personnage et de l'audio fournis en entrée, tels que l'environnement du personnage, les émotions véhiculées par l'audio, etc., permettant au personnage sur l'image de parler ou de chanter naturellement, et générant une vidéo comprenant des expressions naturelles, une synchronisation labiale et des mouvements du corps entier, tout en garantissant la cohérence du sujet dans la vidéo ainsi que la dynamique globale de la vidéo.
Scénarios d'application variés : convient à divers scénarios d'application tels que la création de vidéos courtes, le e-commerce et la publicité. Il peut générer des extraits de parole, de dialogue et de performance de personnages dans différentes scènes, permettant de produire rapidement des vidéos de présentation de produits ou des publicités interactives à plusieurs personnages, réduisant ainsi efficacement les coûts de production.
Pilotage précis multi-personnages : dans les scènes d'interaction à plusieurs personnages, il permet de piloter avec précision plusieurs personnages, garantissant que la synchronisation labiale, les expressions et les mouvements sont synchronisés avec l'audio, pour une interaction naturelle.
Innovations technologiques de HunyuanVideo - Avatar
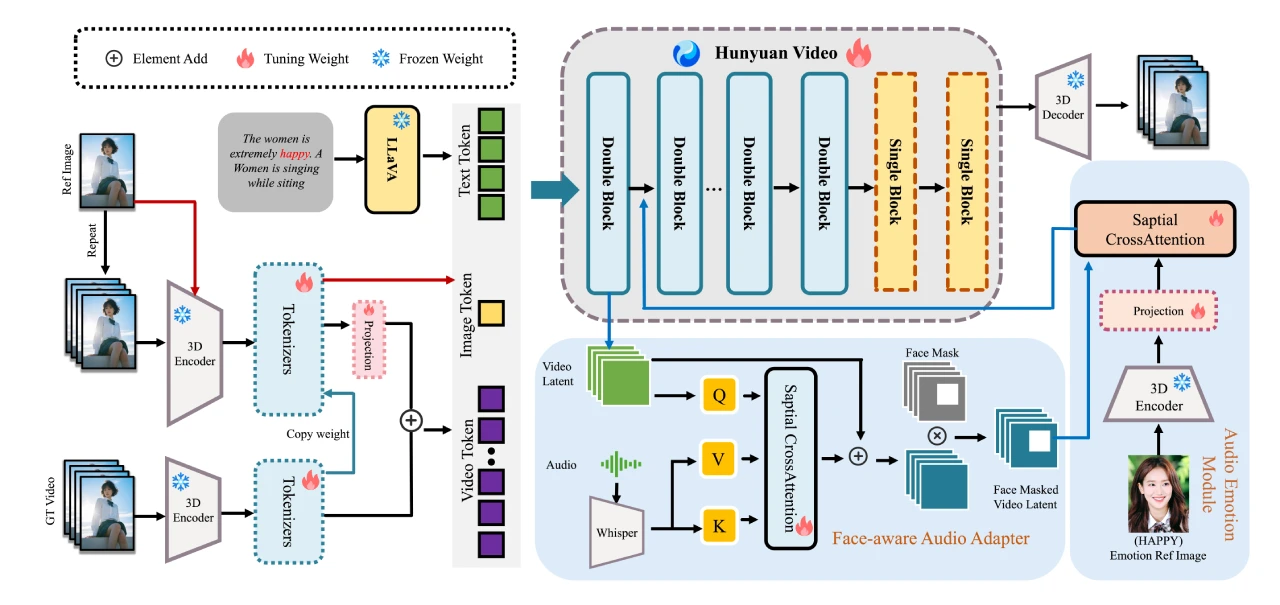
Module d'injection d'image de personnage : basé sur l'architecture Transformer de diffusion multimodale (MM - DiT), il garantit la cohérence du personnage et la dynamique de la vidéo, résolvant le problème de maintenir une grande cohérence de l'apparence du personnage tout en assurant des mouvements fluides et naturels lors de la génération de la vidéo.
Module d'émotion audio (AEM) : il extrait les informations émotionnelles à partir de l'audio et de l'image de référence, génère des expressions et des mouvements subtils, permettant à l'humain numérique d'afficher des expressions faciales correspondantes en fonction de l'émotion de l'audio.
Adaptateur audio à perception faciale (FAA) : grâce à la technologie de masque facial, il isole l'audio de chaque personnage, permettant un pilotage précis dans les scènes multi-personnages. Il peut piloter indépendamment la synchronisation labiale et les expressions de différents personnages, évitant les interférences entre les mouvements des différents personnages.
Comment utiliser HunyuanVideo - Avatar
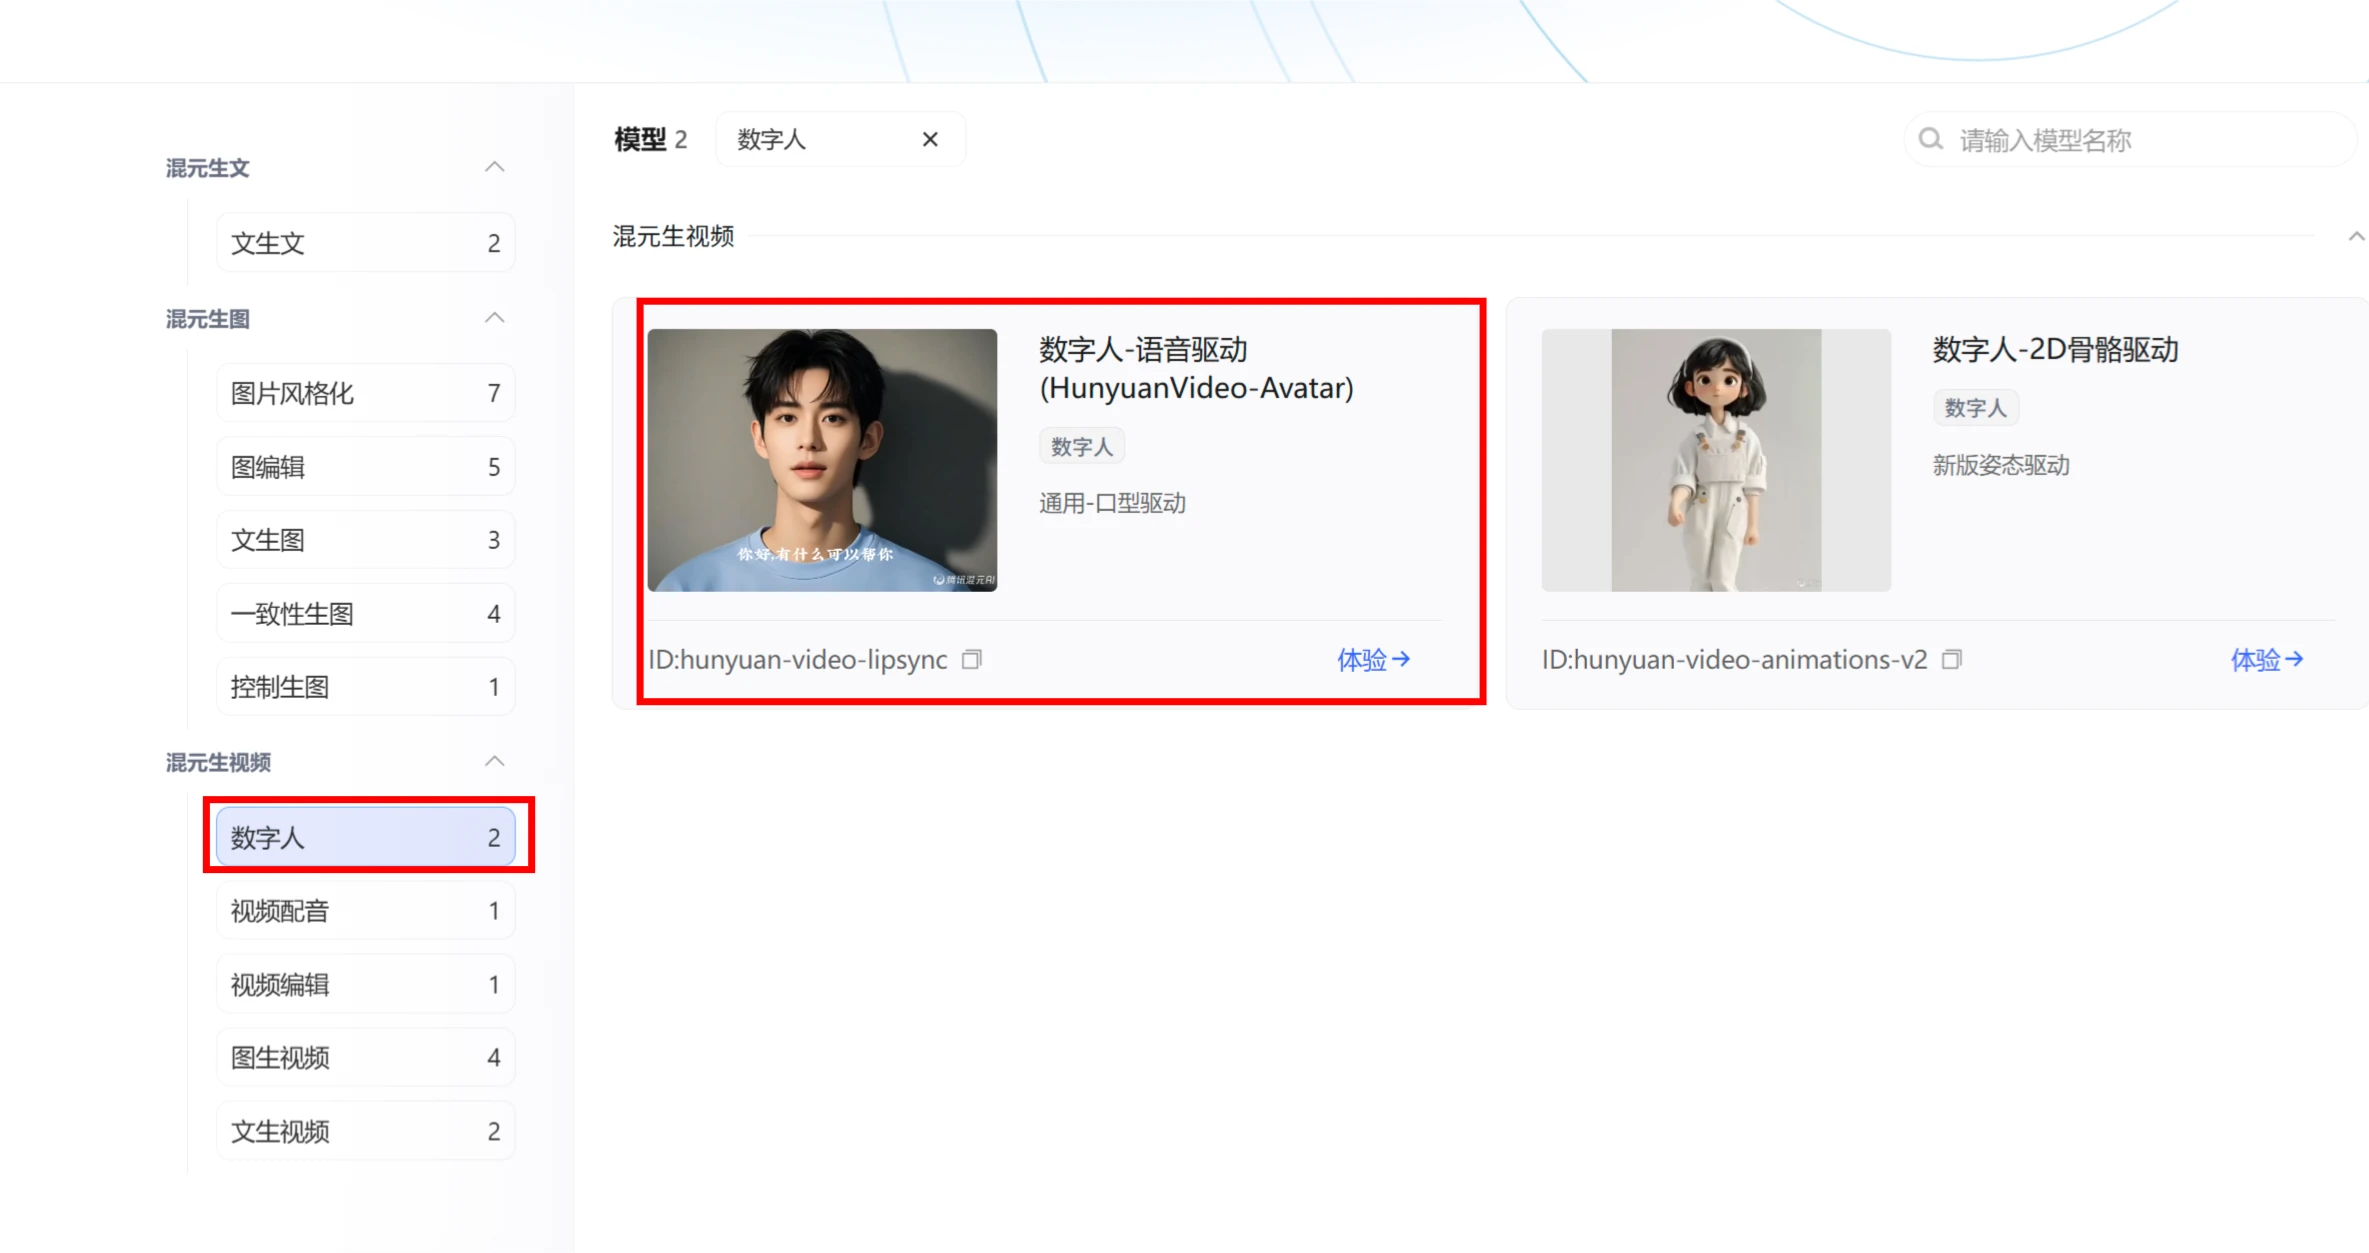
Vous pouvez l'essayer sur le site officiel de Tencent Hunyuan (https://hunyuan.tencent.com/) dans la section « Place de marché des modèles - Hunyuan Génération de vidéo - Humain numérique - Pilotage vocal - HunyuanVideo - Avatar ». Actuellement, il prend en charge le téléchargement d'un fichier audio d'une durée maximale de 14 secondes pour la génération de vidéo.
Scénarios d'application de HunyuanVideo - Avatar
Création de vidéos courtes : permet de générer rapidement des extraits vidéo de dialogues, de performances, etc., dans divers scénarios.
Publicité e-commerce : utilisé pour produire des vidéos de présentation de produits, des publicités interactives à plusieurs personnages, etc.
Assistants virtuels ou jeux : création d'avatars animés pour améliorer l'expérience interactive.
Liens du projet
Page du projet :https://hunyuanvideo-avatar.github.io
Adresse GitHub :https://github.com/Tencent-Hunyuan/HunyuanVideo-Avatar









