
 Assistant scénario▸
 Apps AI
 Actualités AI
Alibaba lance QwenLong-L1-32B : un LLM pour le raisonnement sur contexte long
小编 ·

Alibaba lance QwenLong-L1-32B : un LLM pour le raisonnement sur contexte long
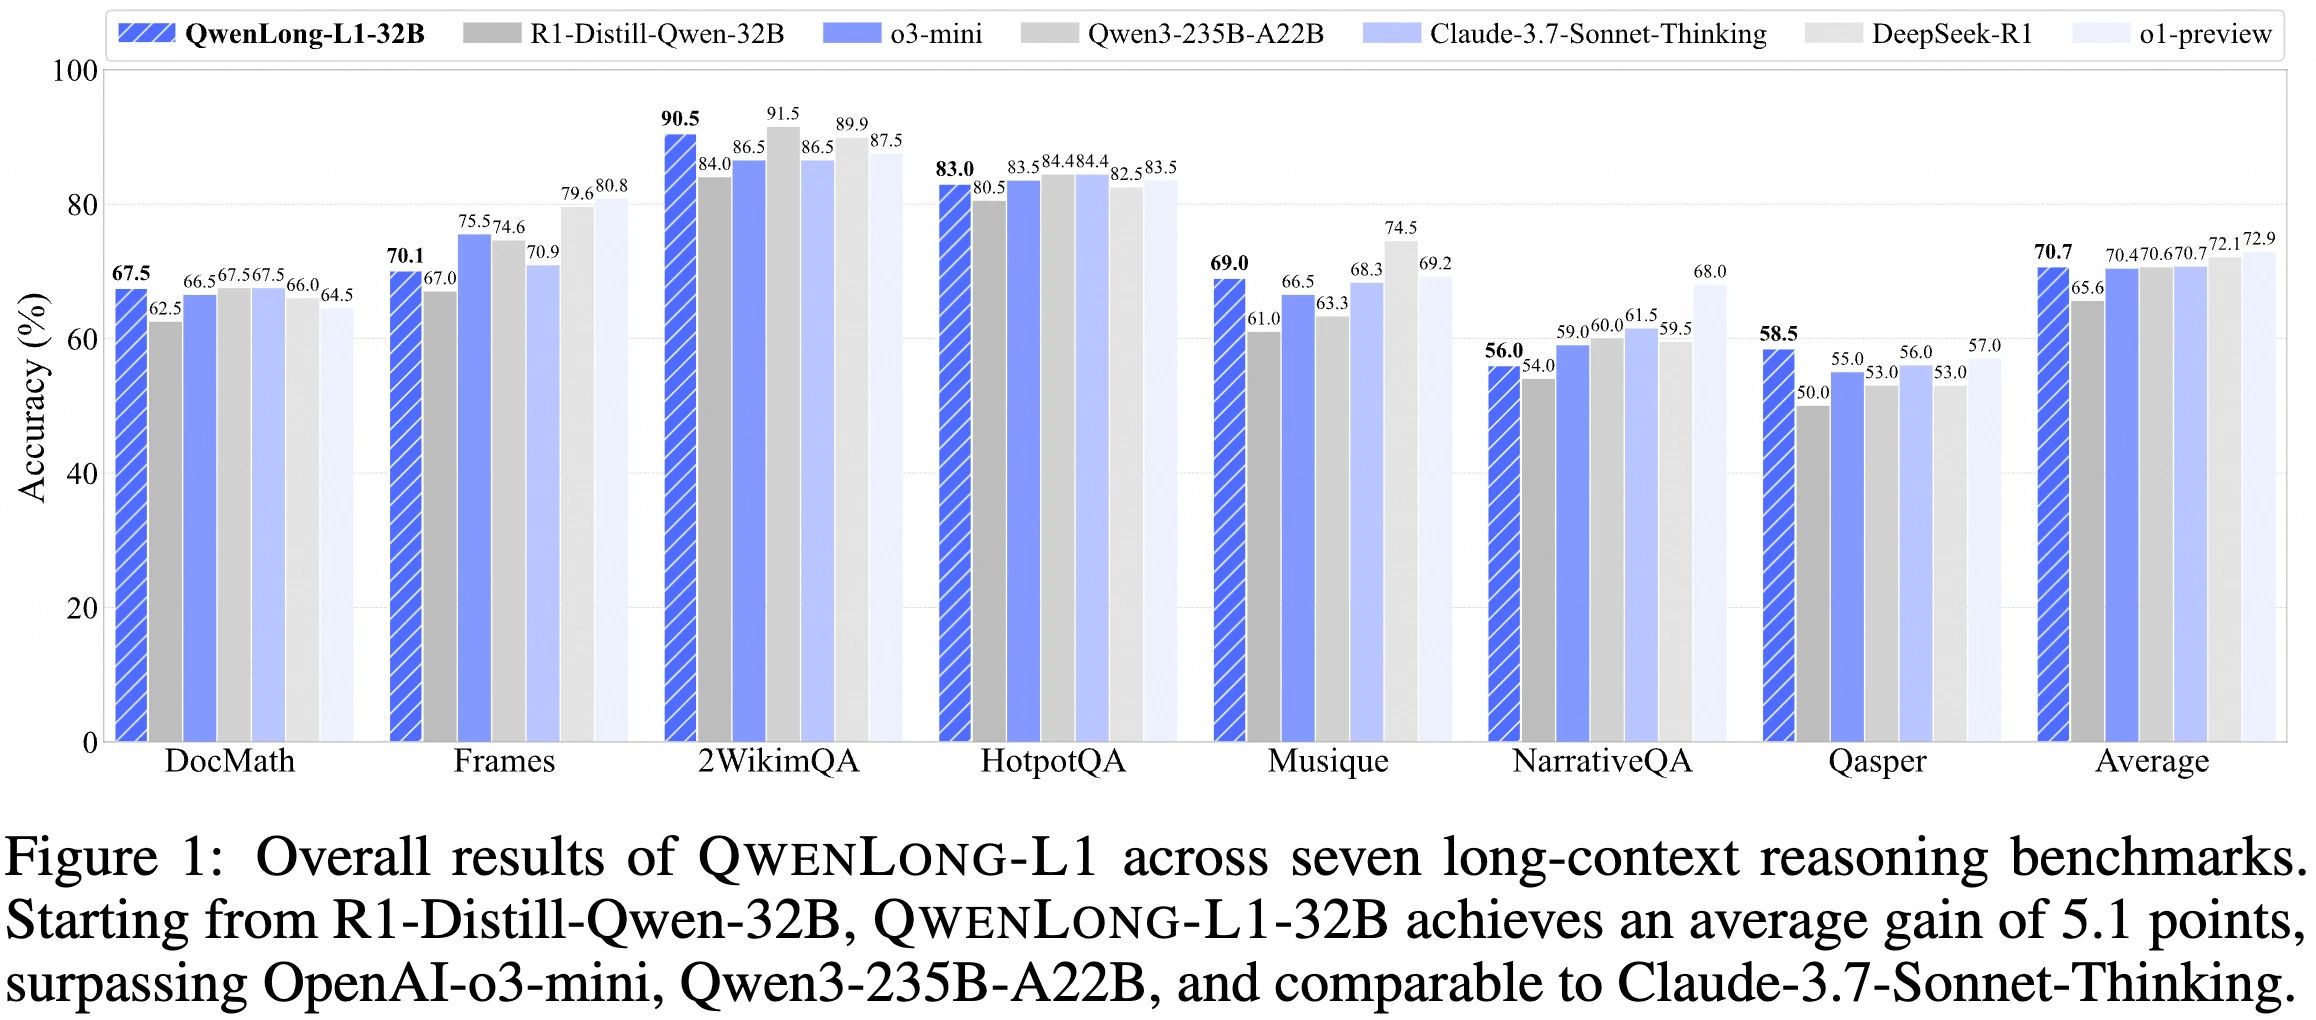
Le 26 mai 2025, l'équipe d'Alibaba a publié QwenLong-L1-32B, le premier grand modèle de raisonnement à contexte long entraîné par apprentissage par renforcement, ainsi que le jeu de données DocQA-RL-1.6K (contenant 1 600 questions de questions-réponses sur documents dans les domaines des mathématiques, de la logique et du raisonnement multi-sauts). Son cadre s'appuie sur un préchauffage par fine-tuning supervisé, un apprentissage par renforcement guidé par curriculum, et un mécanisme d'échantillonnage rétrospectif sensible à la difficulté pour résoudre les défis de la faible efficacité d'entraînement et de l'instabilité du processus d'optimisation dans l'apprentissage par renforcement pour le raisonnement à contexte long. Sur 7 benchmarks DocQA à contexte long, ses performances dépassent celles d'Openai-o3-mini et de Qwen3-235B-A22B, et sont équivalentes à celles de Claude-3.7-Sonnet-Thinking.
Architecture du modèle
Concept clé : adapter via l'apprentissage par renforcement (RL) les grands modèles de raisonnement à contexte court (LRMs) aux scénarios à contexte long.
Composants principaux :
Phase de fine-tuning supervisé (SFT) de préchauffage : établir une politique initiale robuste.
Technique d'apprentissage par renforcement par phases basée sur un curriculum : stabiliser l'évolution de la politique.
Stratégie d'échantillonnage rétrospectif sensible à la difficulté : encourager l'exploration de la politique.
Données d'entraînement
Un jeu de données dédié à l'entraînement par apprentissage par renforcement, appelé DocQA-RL-1.6K, a été utilisé. Il contient 1 600 questions de questions-réponses sur documents couvrant les domaines des mathématiques, de la logique et du raisonnement multi-sauts.
Performances
Sur sept benchmarks de questions-réponses sur documents à contexte long, QwenLong-L1-32B surpasse des LRMs phares comme OpenAI-o3-mini et Qwen3-235B-A22B, atteignant un niveau comparable à Claude-3.7-Sonnet-Thinking, et affichant des performances de pointe parmi les LRMs les plus avancés à ce jour.
Conception expérimentale
Un jeu de données RL dédié, DocQA-RL-1.6K, a été construit, contenant 1 600 questions de questions-réponses sur documents, couvrant les domaines des mathématiques, de la logique et du raisonnement multi-sauts.
La partie raisonnement mathématique utilise 600 questions du jeu de données DocMath, dont 75 % pour l'entraînement et 25 % pour l'évaluation.
La partie raisonnement logique synthétise 600 questions à choix multiples via DeepSeek-R1, couvrant des documents réels dans les domaines juridique, financier, de l'assurance et de la production.
La partie raisonnement multi-sauts échantillonne 200 exemples chacun depuis MultiHopRAG et Musique, en mettant l'accent sur le raisonnement inter-documents.
L'évaluation a été menée sur sept benchmarks DocQA à contexte long, notamment 2WikiMultihopQA, HotpotQA, Musique, NarrativeQA, Qasper, Frames et DocMath.
Résultats et analyse
QwenLong-L1-32B obtient d'excellents résultats sur les sept benchmarks DocQA à contexte long, surpassant des LRMs phares comme OpenAI-o3-mini et Qwen3-235B-A22B, avec des performances équivalentes à celles de Claude-3.7-Sonnet-Thinking.
Sur le benchmark de raisonnement mathématique DocMath, QwenLong-L1-32B atteint 85,3 % de correspondance exacte et de précision jugée par LLM.
Sur le benchmark de raisonnement multi-sauts HotpotQA, le modèle atteint 87,6 %, surpassant nettement les modèles existants.
Liens du projet
Github :https://github.com/Tongyi-Zhiwen/QwenLong-L1
Huggingface :https://huggingface.co/Tongyi-Zhiwen/QwenLong-L1-32B
Modelscope :https://www.modelscope.cn/models/iic/QwenLong-L1-32B









