
 Assistant scénario▸
 Apps AI
 Actualités AI
ParseStudio : une bibliothèque Python pour simplifier l'analyse de PDF
小编 ·

ParseStudio : une bibliothèque Python pour simplifier l'analyse de PDF
Qu'est-ce que ParseStudio ?
Lors du traitement de documents PDF, l'extraction de texte, de tableaux et d'images est souvent fastidieuse, et les différentes bibliothèques s'utilisent de manières variées, ce qui rend le code répétitif et difficile à gérer. ParseStudio, une bibliothèque Python, propose une approche simplifiée en intégrant plusieurs parseurs au sein d'une interface unifiée, permettant aux utilisateurs d'analyser des documents PDF en seulement quelques lignes de code. Cette bibliothèque combine trois moteurs — Docling, PyMuPDF et Llama Parse — et offre la flexibilité nécessaire pour gérer l'extraction de texte, de tableaux et d'images. Les principales caractéristiques de ParseStudio sont : une conception modulaire, la capacité d'extraire simultanément plusieurs types de contenu, une conception d'API épurée, la conversion automatique des tableaux au format Markdown, l'inclusion de métadonnées lors de l'extraction des images, ainsi que la prise en charge du traitement par lots de plusieurs fichiers PDF. Pour les développeurs ayant des bases en Python, ParseStudio est un outil pratique.
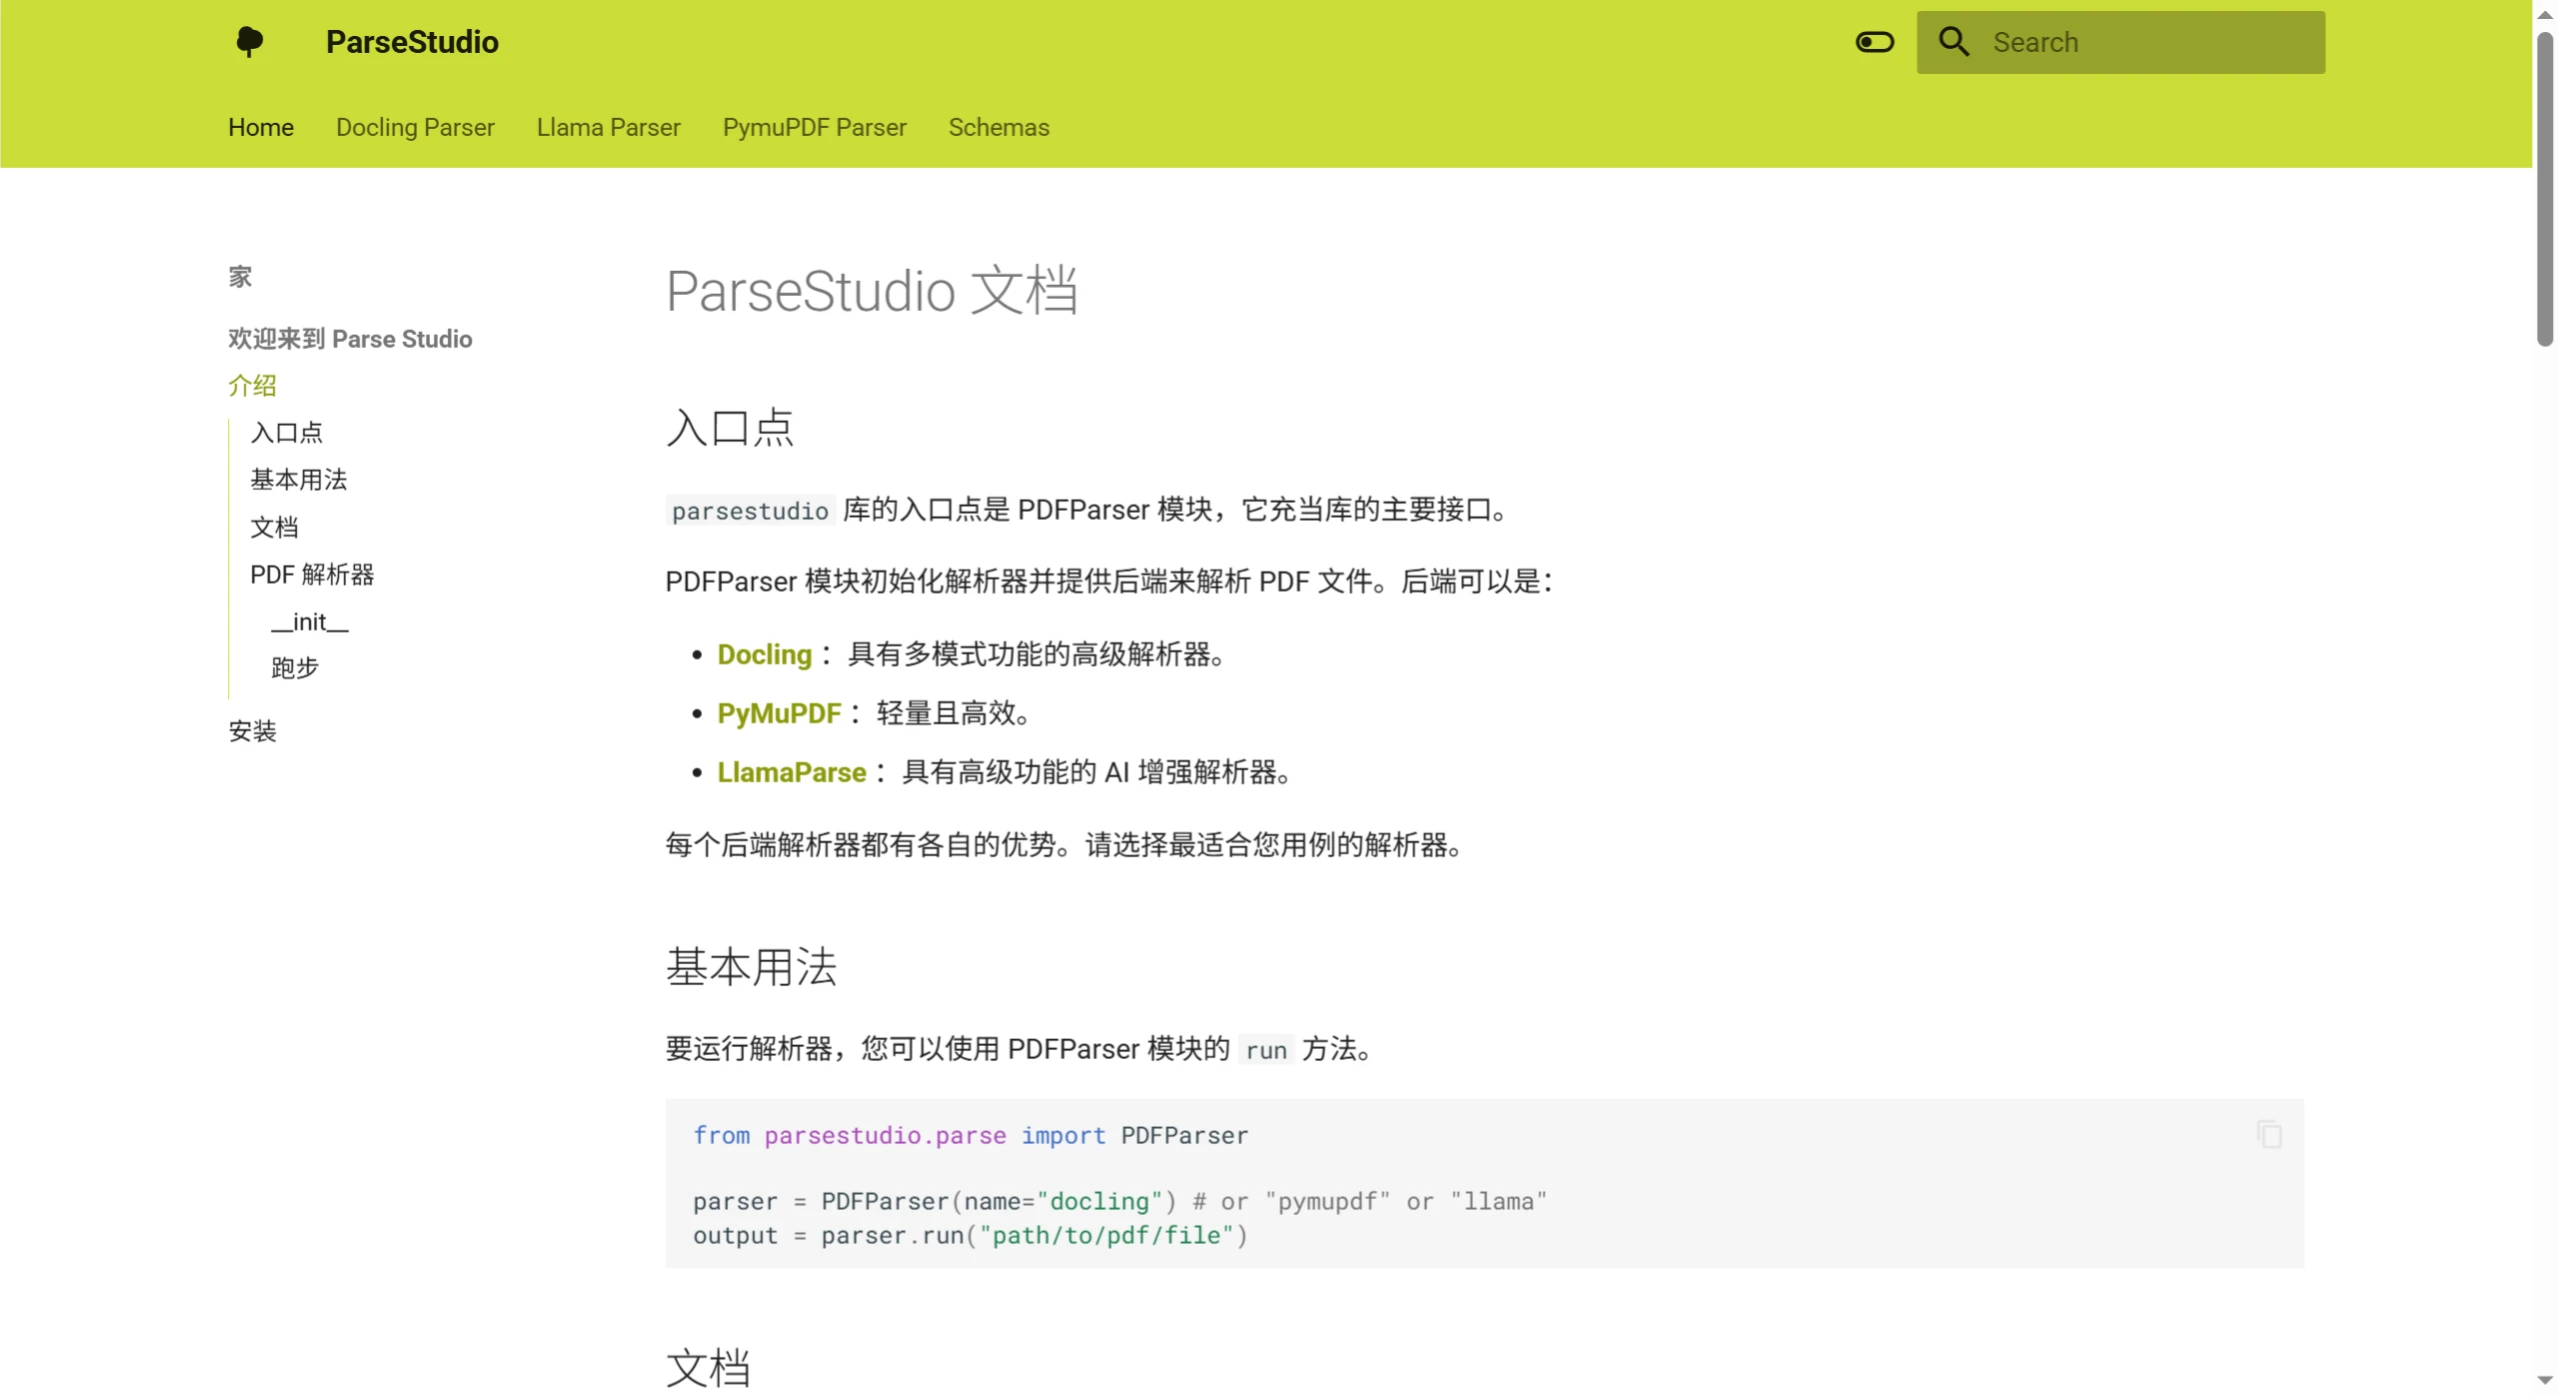
Principales caractéristiques de ParseStudio
Conception modulaire : possibilité de choisir parmi plusieurs backends d'analyse, tels que Docling, PyMuPDF et Llama Parse, afin de répondre à différents besoins.
Analyse multimodale : extraction transparente du texte, des tableaux et des images.
Syntaxe unifiée : simplification de l'interaction avec différents backends grâce à une interface unifiée.
Extensibilité : ajustement facile du comportement d'analyse via des paramètres supplémentaires.
Convivialité : abstraction de la complexité spécifique à chaque backend, permettant aux utilisateurs de se concentrer sur l'extraction du contenu.
Méthode d'installation de ParseStudio
Installation via pip :
pip install parsestudio
Installation à partir du code source :
git clone https://github.com/chatclimate-ai/ParseStudio.git
cd ParseStudio
pip install .
Démarrage rapide avec ParseStudio
Importer et initialiser le parseur :
from parsestudio.parse import PDFParser
# Initialiser avec le backend de parseur souhaité
parser = PDFParser(parser="docling")  # Options : "docling", "pymupdf", "llama"
Analyser un fichier PDF :
outputs = parser.run(["path/to/file.pdf"], modalities=["text", "tables", "images"])
# Accéder au contenu textuel
print(outputs[0].text)
# Accéder aux tableaux
for table in outputs[0].tables:
print(table.markdown)
# Accéder aux images
for image in outputs[0].images:
image.image.show()
metadata = image.metadata
print(metadata)
Parseurs pris en charge
Docling : convient à l'analyse détaillée de la mise en page de documents complexes, prend en charge l'OCR et l'extraction précise des tableaux.
PyMuPDF : léger et efficace, adapté au traitement rapide.
LlamaParse : extraction basée sur le cloud et增强 par l'IA, adaptée aux scénarios nécessitant des fonctionnalités avancées.
GitHub :https://github.com/chatclimate-ai/ParseStudio









