
 Assistant scénario▸
 Apps AI
 Actualités AI
KEEP : restaure les visages des vidéos basse résolution en haute définition
小编 ·

KEEP : restaure les visages des vidéos basse résolution en haute définition
Qu'est-ce que KEEP ?
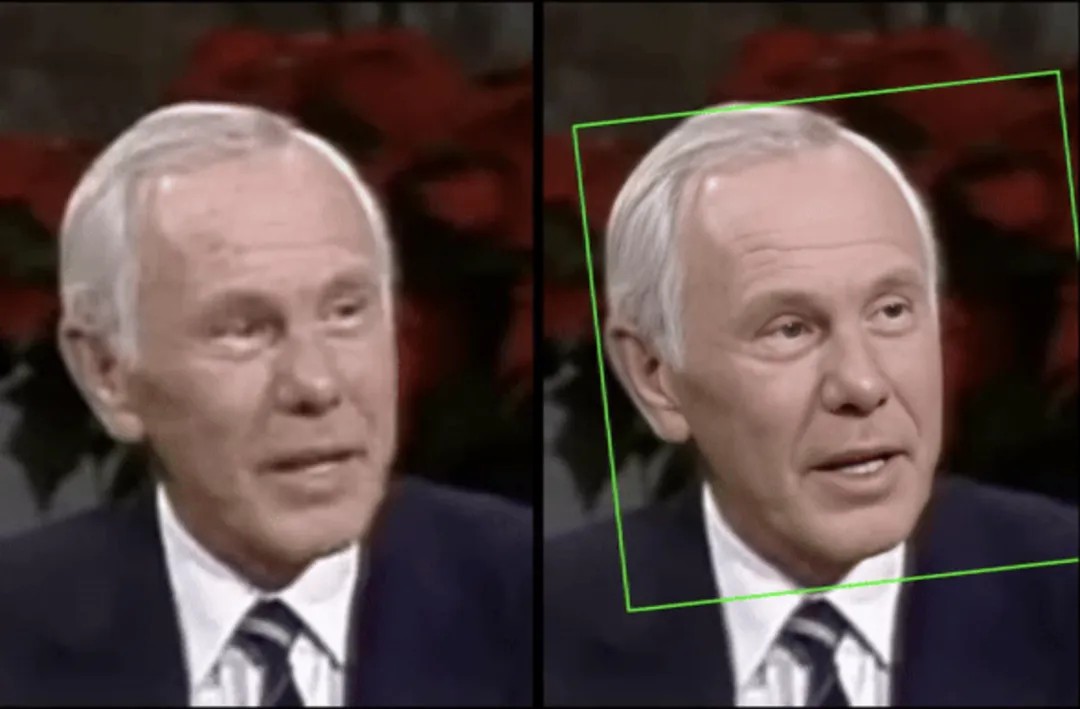
KEEP est un outil développé par une équipe de recherche de l'Université technologique de Nanyang, capable de restaurer les visages présents dans des vidéos de faible résolution en images haute définition, rendant ainsi les traits du visage plus nets. Cette technologie trouve de nombreuses applications dans des domaines tels que la vidéosurveillance et la production audiovisuelle, en améliorant efficacement la qualité des images de visages et en fournissant un matériel plus clair pour les analyses et traitements ultérieurs.
Technologies clés de KEEP
Principe du filtre de Kalman : en suivant les traits du visage dans la séquence vidéo et en utilisant le filtre de Kalman pour prédire les traits du visage dans la trame suivante, on obtient une super-résolution faciale plus élevée.
Propagation des caractéristiques et ajustement dynamique : les informations obtenues à partir des trames précédemment restaurées guident le processus de restauration de la trame actuelle, réduisant ainsi les différences entre les trames consécutives.
Traitement multi-échelle : la combinaison d'informations multi-échelle améliore le rendu des détails et la qualité globale des images de visages.
Attention inter-trames (CFA) : renforce davantage la corrélation entre les différentes trames, contribuant à maintenir une meilleure cohérence temporelle et un meilleur rendu des détails tout au long de la lecture vidéo.
Architecture du modèle KEEP
Encodeur et décodeur : un modèle basé sur un réseau antagoniste génératif variationnel quantique (VQGAN) est construit pour générer des images super-résolues de haute qualité.
Réseau de filtre de Kalman : il combine l'état d'observation de la trame courante et l'état prédit de la trame précédente pour former une estimation plus précise de l'état actuel.
Couche d'attention inter-trames (CFA) : elle améliore les détails de la trame courante en appariant et en fusionnant les caractéristiques similaires de la trame précédente.
Avantages de KEEP
Cohérence temporelle : capable de maintenir la continuité des visages dans la vidéo, évitant les incohérences temporelles causées par le traitement indépendant de chaque trame.
Reconstruction des détails : permet de restaurer efficacement les détails du visage, comme les yeux, le nez et la bouche, même dans des vidéos fortement dégradées.
Robustesse : performs remarquablement sur les visages non frontaux et les vidéos fortement dégradées, capable d'estimer de manière stable les informations a priori du visage.
Cas d'application de KEEP
Restauration de vieux films : amélioration de la netteté des visages dans les films anciens et restauration des détails.
Amélioration de la vidéosurveillance : dans le domaine de la surveillance de sécurité, amélioration de la résolution des visages dans les vidéos de surveillance.
Vidéos sur les réseaux sociaux : amélioration de la netteté des visages dans les vidéos de faible qualité téléchargées par les utilisateurs.
Systèmes de visioconférence : amélioration de la qualité des images faciales lors des communications à distance.
Expériences de réalité virtuelle (VR) : optimisation du rendu des visages des personnages.
Lien du projet
https://github.com/jnjaby/KEEP









