
 Assistant scénario▸
 Apps AI
 Actualités AI
AniSora : le modèle open source de génération de vidéos d’animation de Bilibili
小编 ·

AniSora : le modèle open source de génération de vidéos d’animation de Bilibili
Qu'est-ce qu'AniSora ?
AniSora est un système de génération de IA pour vidéos d'animation en open source publié par Bilibili le 12 mai 2025. Il permet de générer facilement des vidéos d'animation de divers styles, comme des extraits de séries animées, des animations originales chinoises, des adaptations de mangas, du contenu VTuber, des PV d'animation, ainsi que des vidéos « guichu » (parodies remixées). Ce système excelle dans le maintien de la cohérence des personnages et la fluidité des mouvements, et peut être considéré comme l'un des modèles de génération vidéo d'animation les plus avancés à l'heure actuelle.
Fonctionnalités d'AniSora
Génération image vers vidéo : génère des vidéos d'animation cohérentes à partir d'une seule image, idéal pour transformer des scènes statiques en séquences dynamiques.
Interpolation d'images : prend en charge l'interpolation d'images clés en générant des images intermédiaires pour assurer des transitions fluides, réduisant ainsi le travail de dessin manuel dans la production d'animation.
Guidage d'image local : permet aux utilisateurs de spécifier des zones particulières pour la génération d'animation.
Contrôle spatio-temporel : combine des capacités de contrôle dans le temps et l'espace, prenant en charge plusieurs méthodes telles que le guidage par première image, dernière image ou images multiples, pour une création d'animation précise.
Caractéristiques du modèle AniSora
Optimisation ciblée : comparées aux vidéos naturelles, les vidéos d'animation présentent un style plus expressif et plus abstrait. Les modèles génératifs traditionnels peinent souvent à reproduire fidèlement les expressions des personnages, le rythme des actions et le langage caméra exagéré. AniSora a été spécifiquement optimisé pour ces caractéristiques, avec pour objectif d'améliorer l'efficacité de la génération vidéo sans sacrifier l'expression créative.
Prise en charge de styles variés : capable de générer en un clic des extraits vidéo dans de nombreux styles, couvrant les séries animées, les animations originales chinoises, les adaptations de mangas, le contenu VTuber, les PV d'animation, et même les créations de type « guichu ».
Création à faible barrière : pour les particuliers ou les studios ayant des besoins réels de production, AniSora est un outil de création extrêmement attractif.
Modules principaux d'AniSora
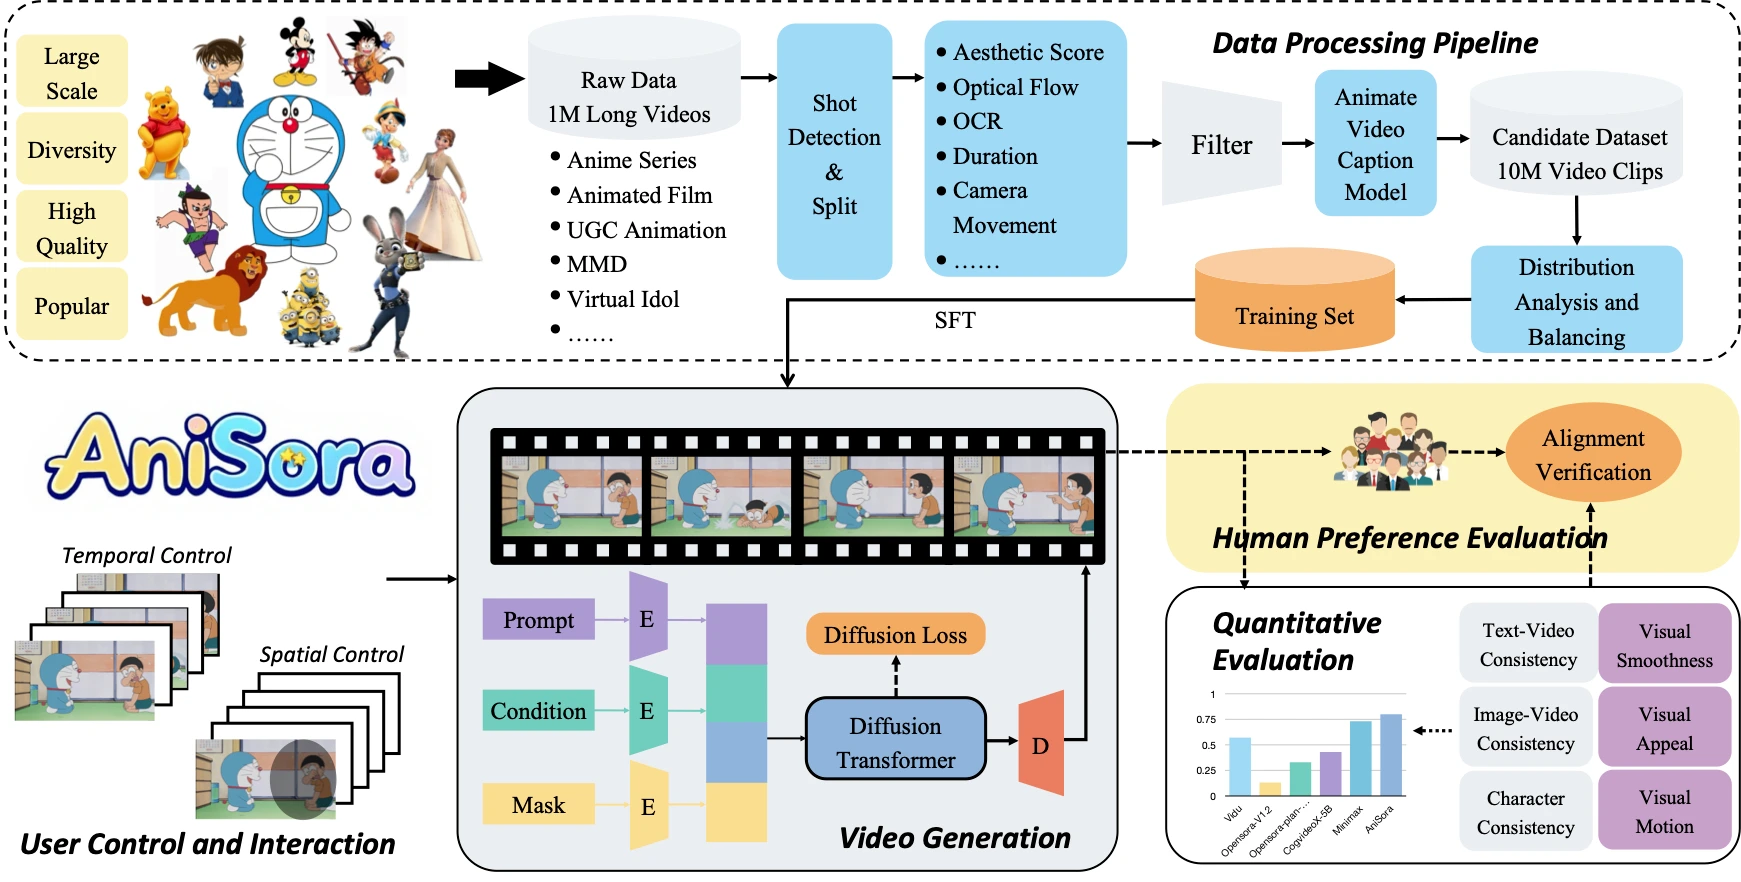
Pipeline de traitement des données : a prétraité plus de 10 millions de paires de données texte-vidéo de haute qualité, fournissant une base solide pour l'entraînement.
Modèle de génération contrôlable : introduit un module de masque spatio-temporel prenant en charge les fonctions de génération image-vers-vidéo, d'interpolation d'images clés et de guidage d'image local, capable de s'adapter à divers besoins de création.
Système d'évaluation : a construit un jeu de données d'évaluation comprenant 948 extraits d'animation variés, combiné à une évaluation en double aveugle par des humains et au système de notation VBench, pour noter la cohérence des personnages, la fluidité des transitions d'action et d'autres dimensions.
Principes techniques d'AniSora
Modèle de diffusion (Diffusion Model) : basé sur une architecture de modèle de diffusion, qui élimine progressivement le bruit pour générer du contenu vidéo de haute qualité.
Module de masque spatio-temporel (Spatiotemporal Mask Module) : permet au modèle de contrôler des zones temporelles et spatiales spécifiques pendant la génération, par exemple en spécifiant par masque quelles images ou quelles zones doivent être animées, pour des fonctions telles que le guidage local et l'interpolation d'images clés.
3D Causal Variational Autoencoder (3D Causal VAE) : utilisé pour encoder et décoder les caractéristiques spatio-temporelles de la vidéo, en comprimant la vidéo dans un espace latent de faible dimension afin de réduire la complexité computationnelle tout en préservant les informations spatio-temporelles essentielles.
Architecture Transformer : combine la puissante capacité de modélisation des Transformers et utilise des mécanismes d'attention pour capturer les dépendances spatio-temporelles complexes dans la vidéo, permettant au modèle de traiter des séquences longues et de générer un contenu vidéo plus cohérent.
Affinage supervisé (Supervised Fine-Tuning) : à partir du pré-entraînement, un affinage supervisé est effectué à l'aide de grandes quantités de données vidéo d'animation, en employant diverses stratégies (comme une stratégie d'entraînement du faible au fort, l'apprentissage multi-tâches, etc.) pour améliorer la capacité de généralisation et la qualité de génération du modèle.
Pipeline de traitement des données : s'appuie sur la détection de scènes, l'analyse de flux optique, le scoring esthétique et d'autres techniques pour filtrer des données d'entraînement de haute qualité à partir d'un grand nombre de vidéos d'animation brutes, garantissant ainsi la qualité et la diversité des données d'entraînement.
Adresses open source
https://github.com/bilibili/Index-anisora/tree/main
https://huggingface.co/IndexTeam/Index-anisora
https://www.modelscope.cn/organization/bilibili-index









