
 Assistant scénario▸
 Apps AI
 Actualités AI
Simple Subtitling : outil de génération automatique de sous-titres vidéo
小编 ·

Simple Subtitling : outil de génération automatique de sous-titres vidéo
Qu'est-ce que Simple Subtitling ?
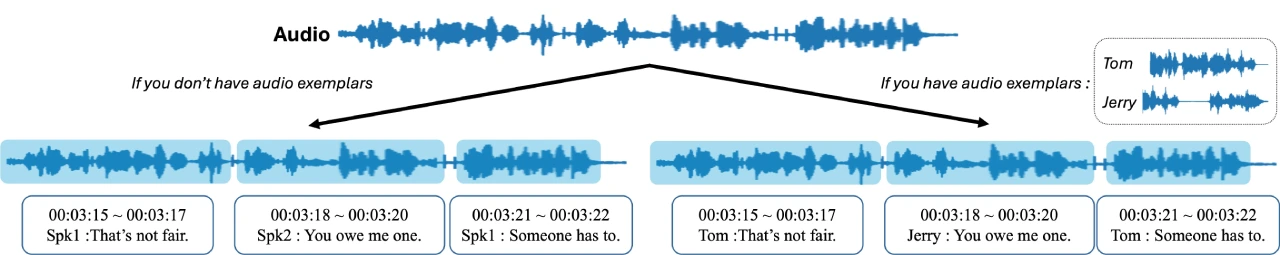
Simple Subtitling est un outil d'IA capable de générer automatiquement des sous-titres pour les œuvres audiovisuelles. Il utilise la technologie WhisperX pour convertir les fichiers audio en fichiers de sous-titres (SRT) avec des horodatages et des identifiants de locuteurs. Il attribue ensuite les identifiants de locuteurs en extrayant et en regroupant les embeddings des locuteurs, et peut attribuer des noms exacts aux locuteurs lorsque des exemples audio sont disponibles. Concrètement, il commence par convertir l'audio en texte en y ajoutant des horodatages ; puis il extrait les caractéristiques de chaque locuteur, regroupe ces caractéristiques par clustering hiérarchique agglomératif (AHC), et attribue finalement un identifiant à chaque locuteur. Si l'utilisateur fournit des échantillons vocaux des acteurs, l'outil peut également nommer les locuteurs. Cet outil a été conçu pour simplifier la génération de sous-titres et faciliter le visionnage des œuvres audiovisuelles.
Fonctionnalités et caractéristiques de Simple Subtitling
Reconnaissance vocale et génération d'horodatages : Grâce à la technologie WhisperX, le contenu audio est reconnu avec précision mot par mot et phrase par phrase, et un texte vocal horodaté est généré.
Identification des locuteurs : Les embeddings de locuteurs sont extraits au niveau de la phrase, puis regroupés à l'aide d'un clustering hiérarchique agglomératif (AHC), permettant ainsi l'attribution d'identifiants de locuteurs.
Prise en charge multilingue : L'outil prend en charge les entrées audio en plusieurs langues et peut générer les sous-titres correspondants.
Paramètres personnalisables : Les utilisateurs peuvent spécifier un répertoire d'échantillons audio afin d'attribuer des noms précis aux locuteurs.
Reconnaissance vocale et clustering de haute précision : Il offre une reconnaissance vocale et un clustering de haute précision, convertissant la parole en texte avec exactitude et classifiant les voix des différents locuteurs, ce qui améliore la précision et la lisibilité des sous-titres.
Installation et utilisation de Simple Subtitling
Étapes d'installation
Créez et activez un environnement conda nommé simplesub, en spécifiant la version 3.11 de Python.
Installez dans cet environnement les packages Python requis par le projet à l'aide de la commande pip install -r requirements.txt.
Vous devrez également installer ffmpeg ; vous pouvez consulter la documentation correspondante pour la méthode d'installation détaillée.
Méthode d'utilisation
Utilisation de base
Exécutez python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH], par exemple python main.py --input_file data/friends.wav --output_file result/friends.srt. Cela générera un fichier de sous-titres à partir du fichier audio en entrée.
Utiliser des exemples audio pour spécifier les noms des locuteurs
Tout d'abord, organisez le répertoire --exemplar_dir selon une structure spécifique : chaque sous-dossier représente un locuteur et contient les échantillons audio de ce locuteur.
Ensuite, exécutez python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH] --exemplar_dir [PATH_OF_EXEMPLARS], par exemple python main.py --input_file data/friends.wav --output_file result/friends_exemplars.srt --exemplars exemplars.
Description des paramètres
input_file : chemin d'accès au fichier audio en entrée.
output_file : chemin d'accès au fichier de sous-titres en sortie (format SRT).
whisper_model_type : type de modèle Whisper, 'medium' par défaut ; les types disponibles peuvent être consultés dans la documentation correspondante.
language : code de langue (deux lettres, par exemple 'en' pour l'anglais) ; si la valeur est None, Whisper détectera la langue lors des 30 premières secondes. La valeur par défaut est None.
embedding_model : extracteur d'embeddings de locuteurs, 'ecapatdnn' ou 'wespeaker' ; la valeur par défaut est 'wespeaker'.
n_cluster : si le nombre de locuteurs est connu, ce paramètre peut être spécifié ; la valeur par défaut est None.
distance_threshold : si n_cluster n'est pas spécifié, il s'agit du seuil de distance pour le clustering hiérarchique agglomératif (AHC) ; la valeur par défaut est 0.8.
exemplar_dir : chemin d'accès au répertoire contenant les exemples audio ; la valeur par défaut est None.
exemplar_threshold : seuil de similarité cosinus utilisé pour déterminer un locuteur « inconnu » ; la valeur par défaut est 0.2.
GitHub :https://github.com/JaesungHuh/simple-subtitling









