
 Assistant scénario▸
 Apps AI
 Actualités AI
ContextGem : outil IA pour extraire des données structurées de documents
小编 ·

ContextGem : outil IA pour extraire des données structurées de documents
Qu'est-ce que ContextGem ?
ContextGem est un outil IA qui extrait des données structurées à partir de documents. Sa capacité principale réside dans sa capacité à comprendre automatiquement l'intention en fonction des informations d'extraction spécifiées par l'utilisateur et à localiser précisément le contenu correspondant dans le document, en excellant particulièrement dans l'analyse approfondie.
Il est idéal pour les scénarios nécessitant une lecture intensive de documents, tels que l'extraction de clauses clés dans les contrats, de données importantes dans les rapports, d'idées principales dans les articles universitaires, etc., aidant les utilisateurs à effectuer efficacement une lecture approfondie.
ContextGem ne se contente pas de localiser les informations et de vous indiquer le paragraphe ou la phrase exact(e) où elles se trouvent, mais explique également les raisons de l'extraction de ces informations ainsi que le processus de raisonnement. Il accomplit des tâches d'extraction complexes en quelques lignes de code, avec un très haut niveau d'automatisation, et de nombreuses opérations complexes sont encapsulées. Il peut générer automatiquement des prompts, effectuer automatiquement la validation des données et la segmentation automatique, simplifiant considérablement le flux de travail de l'utilisateur.
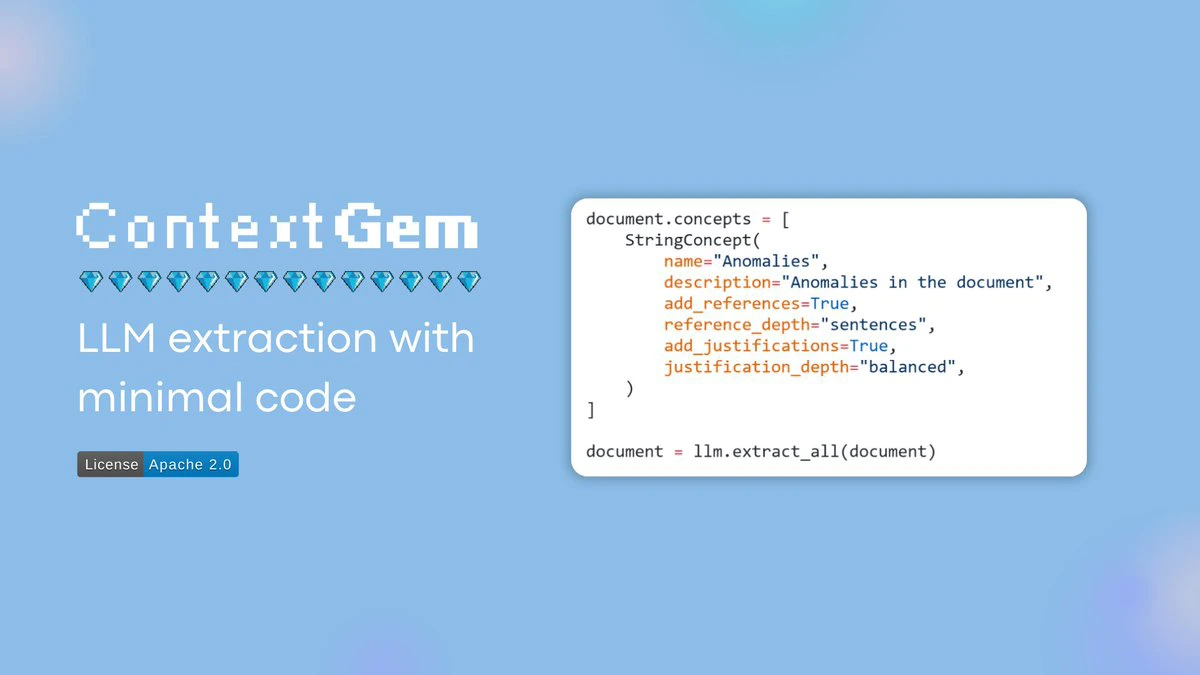
Fonctionnalités principales de ContextGem
Prompt dynamique automatisé : génère automatiquement des prompts complets et personnalisés en fonction des besoins d'extraction, sans rédaction ni maintenance manuelle.
Génération automatique de modèles de données et de validateurs : crée automatiquement des modèles de données Pydantic et une logique de validation à partir des définitions, évitant la rédaction répétitive de code standard.
Mappage précis du contenu extrait : mappe automatiquement et précisément les données extraites à leur emplacement dans le document source (au niveau du paragraphe ou de la phrase), garantissant des résultats vérifiables et traçables.
Fourniture de justifications pour les extractions : inclut automatiquement des justifications textuelles ou des preuves à l'appui de chaque donnée extraite, renforçant la transparence et la fiabilité des résultats.
Segmentation intelligente des documents : utilise les modèles de segmentation neuronale (SaT) les plus avancés pour diviser précisément les documents en paragraphes et phrases, avec prise en charge de plusieurs langues.
Processus d'extraction unifié : permet de définir l'ensemble du flux de travail d'extraction dans une configuration de pipeline unique, déclarative et réutilisable, incluant des contextes imbriqués et des LLM à rôle spécifique.
Prise en charge de l'extraction de contextes imbriqués : gère automatiquement l'extraction d'informations hiérarchiques (par exemple document > section > sous-section > entité) selon la définition du pipeline, simplifiant l'analyse de documents complexes.
Traitement concurrentiel intégré : active le traitement I/O concurrentiel grâce à un simple commutateur use_concurrency=True, accélérant les flux de travail d'extraction intensifs impliquant plusieurs appels LLM.
Suivi automatique de l'utilisation et des coûts : surveille sans configuration supplémentaire les appels LLM, la consommation de jetons et les coûts associés dans le flux de travail.
Logique intégrée de secours et de réessai : mécanismes de réessai intégrés et configuration facile de LLM de secours pour une meilleure résilience.
Prise en charge multilingue : prend en charge plusieurs langues pour les entrées et sorties sans prompts supplémentaires.
Compatibilité avec plusieurs fournisseurs de LLM : prend en charge les LLM cloud (tels qu'OpenAI, Anthropic, Google, Azure OpenAI, etc.) et les LLM locaux (tels qu'Ollama, LM Studio, etc.), avec une interface unifiée facilitant la transition.
Stratégies d'optimisation : propose des stratégies pour optimiser la précision, la vitesse et les coûts, ainsi que des conseils pour traiter des documents longs et choisir le LLM approprié.
Sérialisation des résultats : permet de sauvegarder et de charger des objets documents, des pipelines et des configurations LLM, évitant des appels redondants et coûteux aux LLM.
Convertisseur de documents
ContextGem fournit un convertisseur de documents intégré capable de convertir des fichiers DOCX en données exploitables par les LLM. Il peut extraire des informations que d'autres outils open source ne parviennent généralement pas à capturer, telles que les tableaux mal alignés, les annotations, les notes de bas de page, les zones de texte, les en-têtes/pieds de page et les images intégrées, tout en préservant la structure du document et des métadonnées riches pour une meilleure analyse par les LLM.
Cas d'utilisation de ContextGem
ContextGem se concentre sur l'analyse approfondie et précise de documents individuels, en exploitant les fenêtres de contexte étendues et les capacités des LLM modernes. Il convient aux scénarios nécessitant l'extraction de données et d'informations précises à partir de documents spécifiques, tels que l'analyse de contrats juridiques, le traitement de documents financiers, etc. Cependant, il ne prend pas actuellement en charge les requêtes inter-documents ni la recherche dans l'ensemble d'un corpus ; pour ces cas d'utilisation, les systèmes RAG modernes (tels que LlamaIndex, Haystack) peuvent être plus appropriés.
Lien du projet ContextGem
https://github.com/shcherbak-ai/contextgem









