
 Assistant scénario▸
 Apps AI
 Actualités AI
Insert Anything : framework open source d'édition d'images pour changer de visage, de tenue, etc.
小编 ·

Insert Anything : framework open source d'édition d'images pour changer de visage, de tenue, etc.
Présentation de Insert Anything
Insert Anything est un cadre unifié d'insertion d'images proposé conjointement par l'Université du Zhejiang, l'Université Harvard et l'Université technologique de Nanyang. Il permet d'intégrer de manière transparente les objets d'une image de référence dans une scène cible et prend en charge de nombreux scénarios d'application pratiques, tels que la création artistique, l'échange de visages réaliste, la composition de scènes cinématographiques, l'essayage virtuel de vêtements, la personnalisation d'accessoires et le remplacement de accessoires numériques.
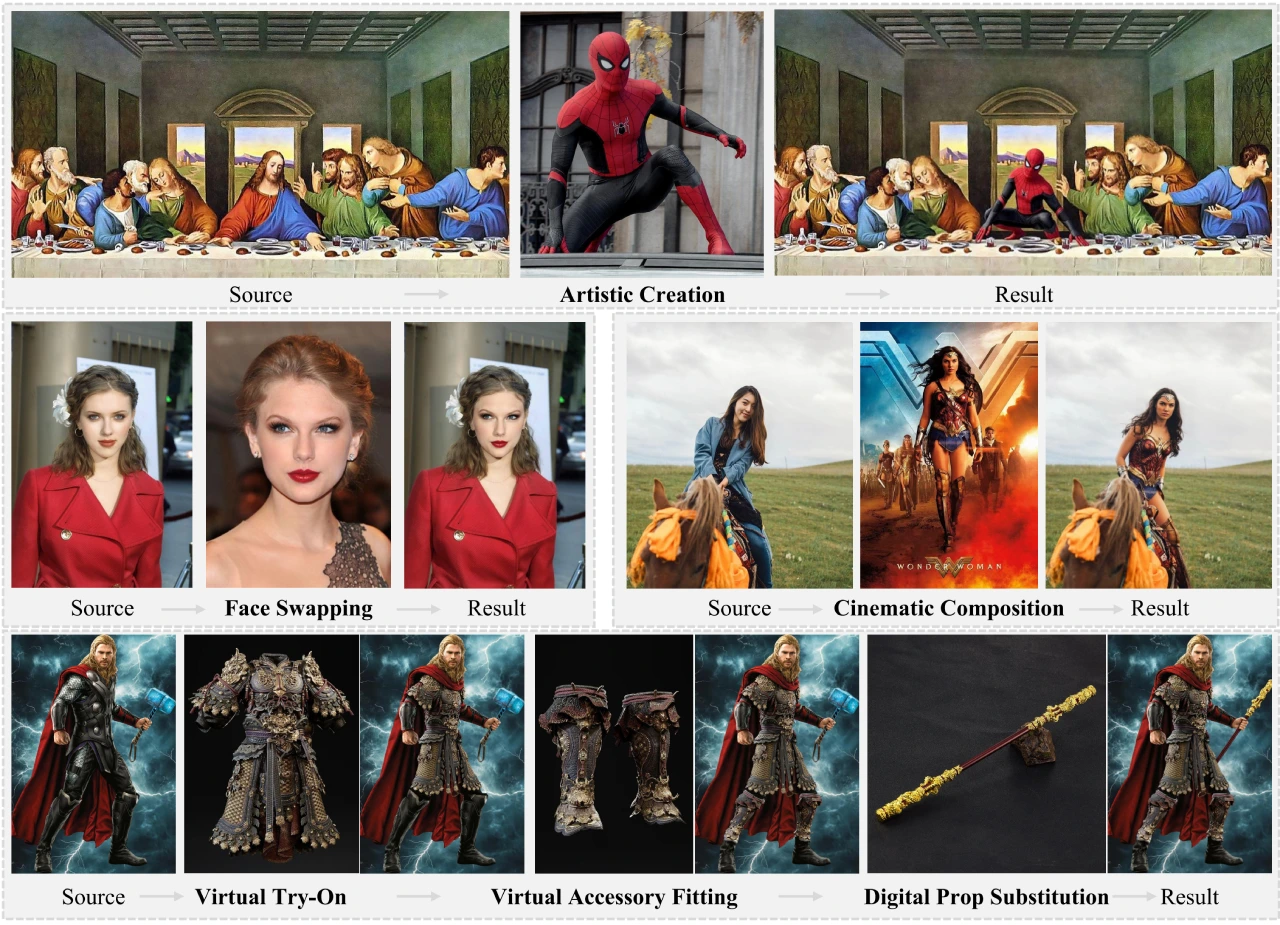
Principe technique de Insert Anything
1. Jeu de données AnyInsertion
Échelle et contenu : ce cadre repose sur un jeu de données AnyInsertion contenant 120 000 paires invite-image, couvrant diverses tâches telles que l'insertion de personnes, d'objets et de vêtements.
Modes de contrôle multiples : le jeu de données prend en charge deux modes de contrôle, à savoir les invites par masque (58K paires) et les invites textuelles (101K paires), offrant au modèle un riche échantillon d'entraînement.
2. Diffusion Transformer (DiT)
Mécanisme d'attention multimodale : Insert Anything exploite le mécanisme d'attention multimodale du DiT pour permettre des éditions guidées par masque et par texte. Ce mécanisme traite séparément les entrées visuelles et les descriptions textuelles via une branche d'image et une branche de texte, puis fusionne ces informations grâce à une attention multimodale.
Branche d'image : elle traite l'image de référence, l'image source et le masque, extrait les caractéristiques visuelles et les concatène avec le bruit.
Branche de texte : elle encode les descriptions textuelles pour fournir un guidage sémantique.
3. Mécanisme d'édition contextuelle
Stratégies de prompt en diptyque et en triptyque :
Diptyque avec invite par masque : à gauche l'image de référence, à droite l'image cible avec le masque.
Triptyque avec invite textuelle : à gauche l'image de référence, au centre l'image source, à droite le résultat généré à partir du texte.
Fonction : ce mécanisme considère l'image de référence comme une information contextuelle et, grâce à une interaction implicite, garantit la cohérence visuelle entre l'élément inséré et la scène cible, tout en préservant ses caractéristiques uniques.
Avantages
Polyvalence : un seul modèle peut gérer plusieurs tâches d'insertion, évitant ainsi d'avoir à entraîner un modèle distinct pour chaque tâche.
Flexibilité : il prend en charge deux modes de contrôle, par masque et par texte, répondant aux besoins éditoriaux de différents utilisateurs.
Cohérence visuelle : grâce au mécanisme d'édition contextuelle, les éléments insérés s'intègrent naturellement à la scène cible.
Scénarios d'application de Insert Anything
Création artistique : insertion transparente d'éléments artistiques dans différents arrière-plans.
Publicité commerciale : insertion d'images de produits dans des scénarios publicitaires.
Création liée à la culture pop : insertion d'éléments de la culture pop dans des scènes pertinentes.
Liens du projet
Page du projet :https://song-wensong.github.io/insert-anything/
Article :https://arxiv.org/abs/2504.15009
Github :https://github.com/song-wensong/insert-anything









