
 Assistant scénario▸
 Apps AI
 Actualités AI
SmartPDFs : un outil IA pour résumer et segmenter rapidement vos PDF
小编 ·

SmartPDFs : un outil IA pour résumer et segmenter rapidement vos PDF
Qu'est-ce que SmartPDF ?
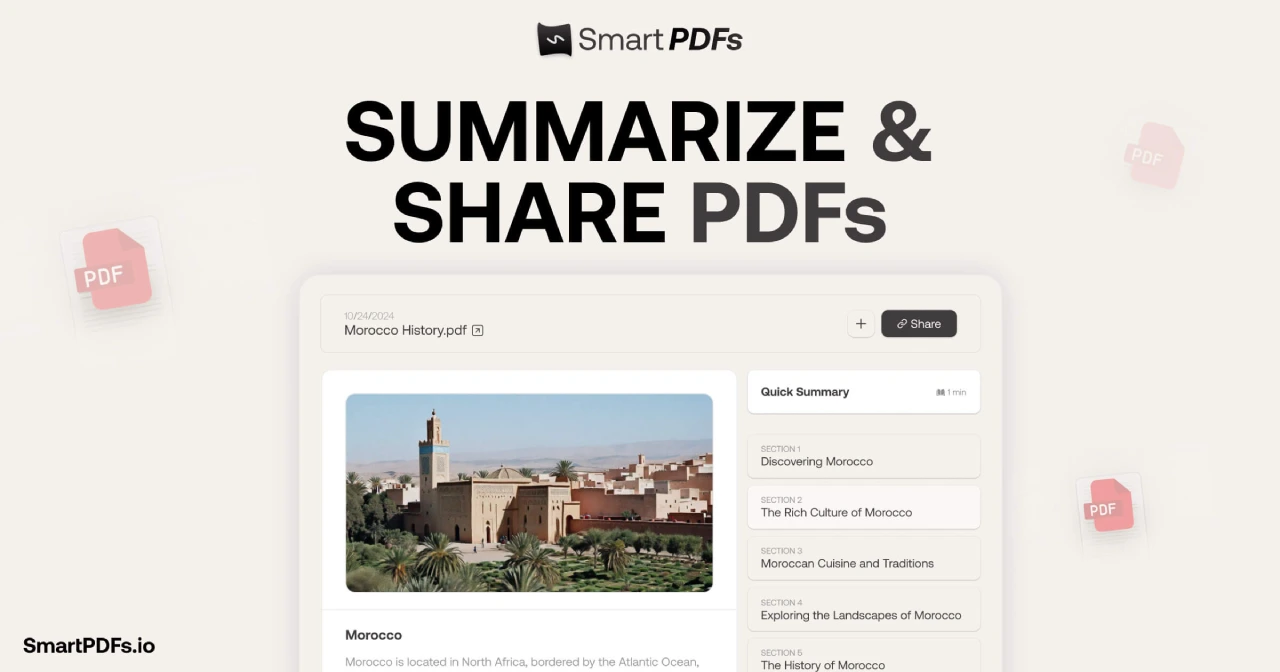
SmartPDF est un projet qui exploite la technologie ai pour traiter les fichiers PDF. Il est capable de résumer et de segmenter rapidement le contenu des fichiers PDF. Donnez-lui un document PDF et il produira un résumé segmenté, concis et contenant les éléments essentiels, ce qui s'avère particulièrement utile pour les utilisateurs qui doivent fréquemment lire de longs PDF. SmartPDF est alimenté par le modèle Llama 3.3 disponible sur la plateforme Together AI.
Fonctionnalités principales de SmartPDF
Extraction de texte PDF :à l'aide de la bibliothèque pdfjs-dist, le texte est extrait du fichier PDF puis découpé en blocs de taille appropriée.
export async function getPdfText(pdf: PDFDocumentProxy) {
// 实现 PDF 文本提取逻辑
}
export async function chunkPdf(pdf: PDFDocumentProxy) {
// 实现 PDF 文本分块逻辑
}
Résumé du contenu :en appelant le point de terminaison /api/summarize, la technologie IA est utilisée pour résumer chaque bloc de texte et générer un titre correspondant.
export async function summarizeStream(chunks: Chunk[], language: string) {
// 实现文本块总结逻辑
}
Génération d'images :à partir du contenu résumé, le point de terminaison /api/image est appelé afin de générer, grâce à l'IA, une image correspondant au résumé.
export async function generateImage(summary: string) {
// 实现图像生成逻辑
}
Partage de PDF :le contenu résumé, les images et les informations relatives au fichier PDF d'origine sont enregistrés dans la base de données, et un lien de partage est généré.
export async function sharePdf({
pdfName,
pdfUrl,
imageUrl,
sections,
}) {
// 实现 PDF 分享逻辑
}
Stack technique du projet
Front-end : React est utilisé comme framework de base, et next-s3-upload sert à téléverser les fichiers vers un bucket S3.
Back-end : les routes API de Next.js sont employées pour gérer les requêtes d'interface et appeler les modèles d'IA pour le résumé du contenu et la génération d'images.
Modèle d'IA : le modèle Llama 3.3 disponible sur la plateforme Together AI est utilisé.
Base de données : Prisma et la base de données Neon sont mis à contribution pour stocker les informations PDF ainsi que les résumés.
Étapes pour exécuter le projet
1. Cloner le dépôt :
git clone https://github.com/Nutlope/smartpdfs.git
cd smartpdfs
2. Installer les dépendances :
pnpm install
3. Configurer les variables d'environnement :définissez les variables d'environnement nécessaires dans le fichier .env, telles que les informations du bucket S3, la clé d'API du modèle d'IA, etc.
4. Lancer le projet :
pnpm dev
Adresse du projet
Site officiel :https://www.smartpdfs.ai/
Github :https://github.com/Nutlope/smartpdfs









