
 Assistant scénario▸
 Apps AI
 Actualités AI
Voila : un modèle vocal IA de bout en bout, open source
小编 ·

Voila : un modèle vocal IA de bout en bout, open source
Qu'est-ce que Voila ?
Voila est un modèle vocal IA de bout en bout, qui adopte une technologie full-duplex, capable d'écouter et de parler simultanément, avec une faible latence. Sa latence de réponse n'est que de 195 millisecondes, inférieure au temps de réaction moyen d'un être humain, et il abandonne le système de pipeline traditionnel.
Le modèle est préchargé avec plus d'un million de voix et prend en charge la reconnaissance automatique de la parole (ASR), la synthèse vocale (TTS) ainsi que la traduction vocale multilingue, entre autres fonctionnalités. De plus, Voila permet des conversations autonomes en temps réel, écoutant en continu, raisonnant et répondant de manière proactive aux utilisateurs. Les utilisateurs peuvent également définir l'identité, le ton et d'autres caractéristiques du locuteur par le biais d'instructions textuelles, offrant ainsi une expérience d'interaction vocale plus personnalisée et naturelle.
Fonctionnalités de Voila
Conversation full-duplex à faible latence : Voila permet une conversation full-duplex à faible latence, avec une latence de réponse de seulement 195 millisecondes, surpassant le temps de réaction moyen d'un être humain.
Préservation des détails vocaux : capable de préserver de riches détails vocaux tels que l'intonation, le rythme et les émotions.
Architecture Transformer hiérarchique multi-échelle : combine les capacités de raisonnement des grands modèles de langage (LLMs) avec une modélisation acoustique puissante, permettant une génération vocale naturelle et consciente du personnage. Les utilisateurs peuvent définir l'identité, le ton et d'autres caractéristiques du locuteur par le biais d'instructions textuelles.
Capacités de personnalisation vocale puissantes : prend en charge plus d'un million de voix préfabriquées et permet de personnaliser efficacement de nouvelles voix à partir d'échantillons audio aussi courts que 10 secondes.
Conception de modèle unifiée : applicable à un large éventail d'applications vocales, notamment la reconnaissance automatique de la parole (ASR), la synthèse vocale (TTS), ainsi que la traduction vocale multilingue avec une adaptation minimale.
Principes techniques
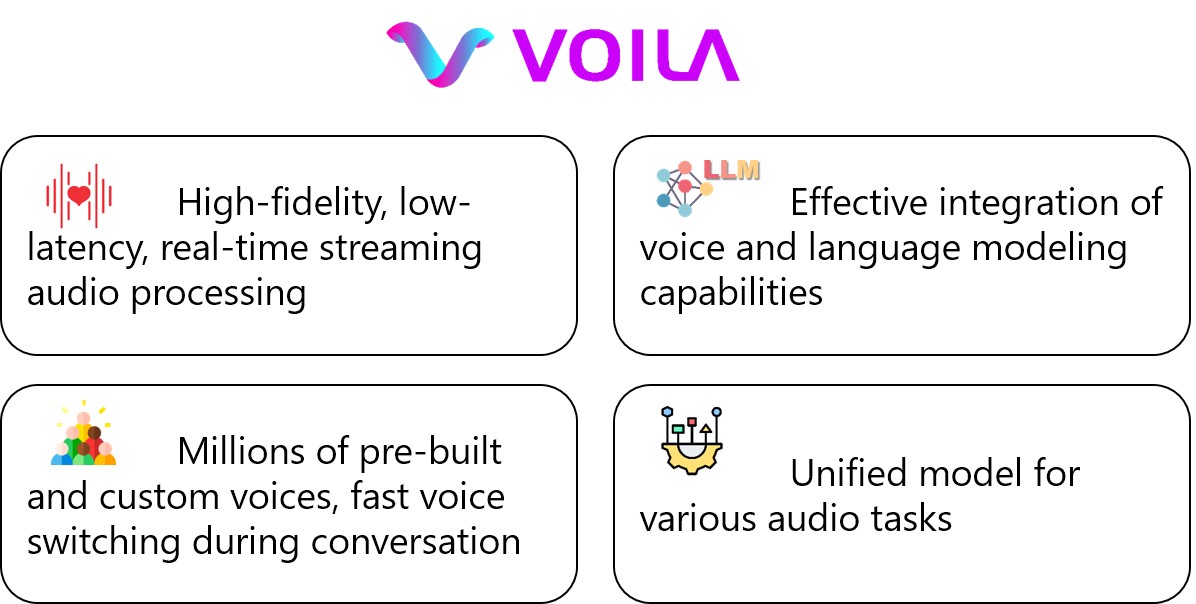
Traitement audio en flux continu en temps réel, haute fidélité et faible latence : permet des conversations à faible latence tout en préservant les détails vocaux.
Intégration efficace des capacités de modélisation vocale et linguistique : combine la modélisation textuelle et vocale pour améliorer le naturel de l'interaction.
Des millions de voix préfabriquées et personnalisées : prend en charge le changement rapide de voix pendant les conversations, enrichissant l'expérience interactive.
Modèle unifié pour diverses tâches audio : un seul modèle prend en charge plusieurs tâches audio, réduisant les coûts de développement et de déploiement.
Scénarios d'application de Voila
Assistant vocal : peut servir d'assistant vocal intelligent, interagissant avec les humains de manière autonome, en temps réel et expressive sur le plan émotionnel, en écoutant en continu, en raisonnant et en répondant de manière proactive, pour une expérience d'interaction fluide, dynamique et émotionnellement résonante.
Jeu de rôle vocal : dans des scénarios tels que le jeu de rôle, les utilisateurs peuvent définir l'identité, le ton et d'autres caractéristiques du locuteur, permettant ainsi une génération vocale naturelle et consciente du personnage.
Traduction vocale multilingue : après une adaptation minimale, peut être utilisée pour la traduction vocale multilingue.
Liens relatifs au projet
Page du projet : https://voila.maitrix.org/
Modèle : https://huggingface.co/collections/maitrix-org/voila-67e0d96962c19f221fc73fa5
Démonstration : https://huggingface.co/spaces/maitrix-org/Voila-demo
Article : https://arxiv.org/abs/2505.02707
Dépôt GitHub : https://github.com/maitrix-org/Voila









