
 Assistant scénario▸
 Apps AI
 Actualités AI
ACE-Step : un nouveau modèle open source de génération musicale
小编 ·

ACE-Step : un nouveau modèle open source de génération musicale
Qu'est-ce qu'ACE-Step ?
ACE-Step est un nouveau modèle fondamental open source de génération musicale développé conjointement par ACE Studio et StepFun. Il surmonte les limites des méthodes existantes de génération musicale en termes de vitesse de génération, de cohérence musicale et de contrôlabilité, en intégrant une technologie de génération basée sur la diffusion, un autoencodeur à compression profonde de Sana et un transformateur linéaire léger. Le modèle peut synthétiser jusqu'à 4 minutes de musique en 20 secondes sur un GPU A100, ce qui est 15 fois plus rapide que les modèles de référence basés sur les LLM, et il obtient une meilleure cohérence musicale ainsi qu'un meilleur alignement des paroles sur les indicateurs de mélodie, d'harmonie et de rythme. Il prend également en charge des mécanismes de contrôle avancés tels que le clonage vocal et l'édition des paroles, tout en reconnaissant certaines limites telles que l'incohérence des sorties et les performances médiocres sur des styles spécifiques.
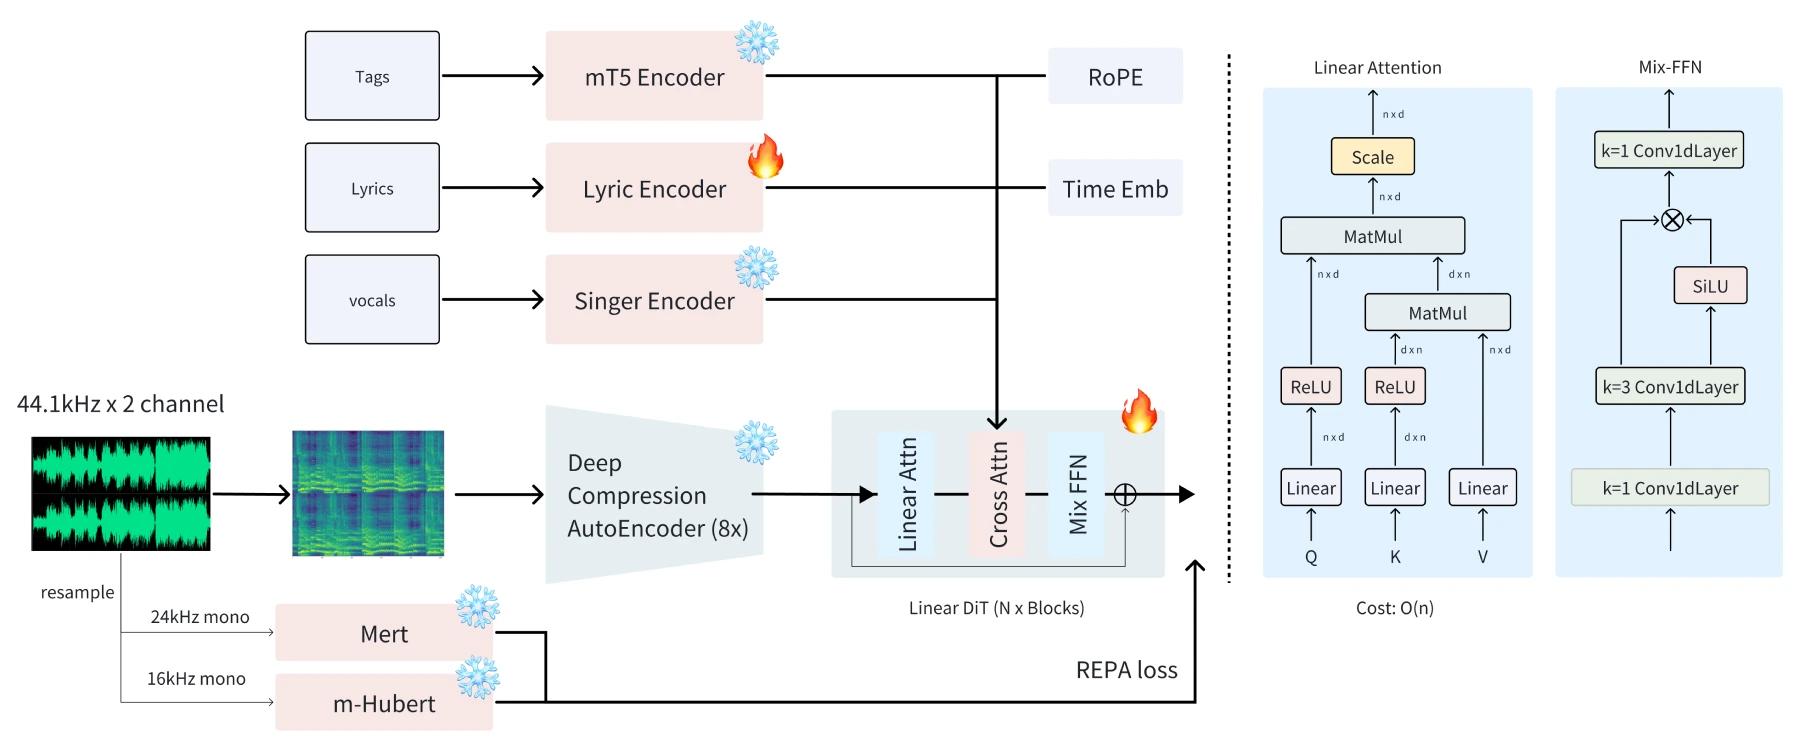
Architecture principale d'ACE-Step
ACE-Step permet une convergence rapide en intégrant un modèle de diffusion, un autoencodeur à compression profonde et un transformateur linéaire léger, et en utilisant MERT et m-hubert pour aligner les représentations sémantiques (REPA) pendant l'entraînement. Cette conception architecturale établit un équilibre entre la vitesse de génération, la cohérence musicale et la contrôlabilité.
Avantages d'ACE-Step
Vitesse de génération : ACE-Step peut générer jusqu'à 4 minutes de musique en seulement 20 secondes sur un GPU NVIDIA A100, soit 15 fois plus rapide que les méthodes de référence basées sur les grands modèles de langage (LLM).
Cohérence musicale : le modèle présente une cohérence musicale supérieure ainsi qu'un meilleur alignement des paroles sur les indicateurs de mélodie, d'harmonie et de rythme.
Préservation des détails : ACE-Step préserve les détails acoustiques fins et prend en charge des mécanismes de contrôle avancés, tels que le clonage vocal, l'édition des paroles, le remix et la génération de pistes.
Fonctionnalités d'ACE-Step
Styles variés : prend en charge les principaux styles de musique et peut traiter plusieurs formats de description, tels que des étiquettes courtes, du texte descriptif ou des descriptions de scénarios d'application. Il obtient également de bons résultats lors de tests d'entrée expérimentaux et peut générer des morceaux instrumentaux avec de nombreux instruments.
Support multilingue : prend en charge 19 langues, mais en raison de déséquilibres dans les données, certaines langues présentent des performances inférieures. Les 10 langues les mieux prises en charge incluent l'anglais, le chinois, le russe, etc.
Forte contrôlabilité :
Variations Generation : utilise une technique d'optimisation non entraînable au moment de l'inférence, qui ajuste le mélange entre le bruit initial et le bruit gaussien ajouté pour générer des variantes avec différents degrés de similarité avec le morceau original.
Repaint : en ajoutant du bruit à l'audio cible et en appliquant des contraintes de masquage pendant le processus ODE, il permet de modifier des parties spécifiques, et peut être combiné avec la technique de génération de variantes pour obtenir des changements locaux de style, de paroles ou de voix.
Edit : utilise la technique flow-edit, qui permet de modifier les paroles sans changer la mélodie, le timbre vocal ni la musique de fond, mais ne peut modifier qu'un petit segment de paroles à la fois.
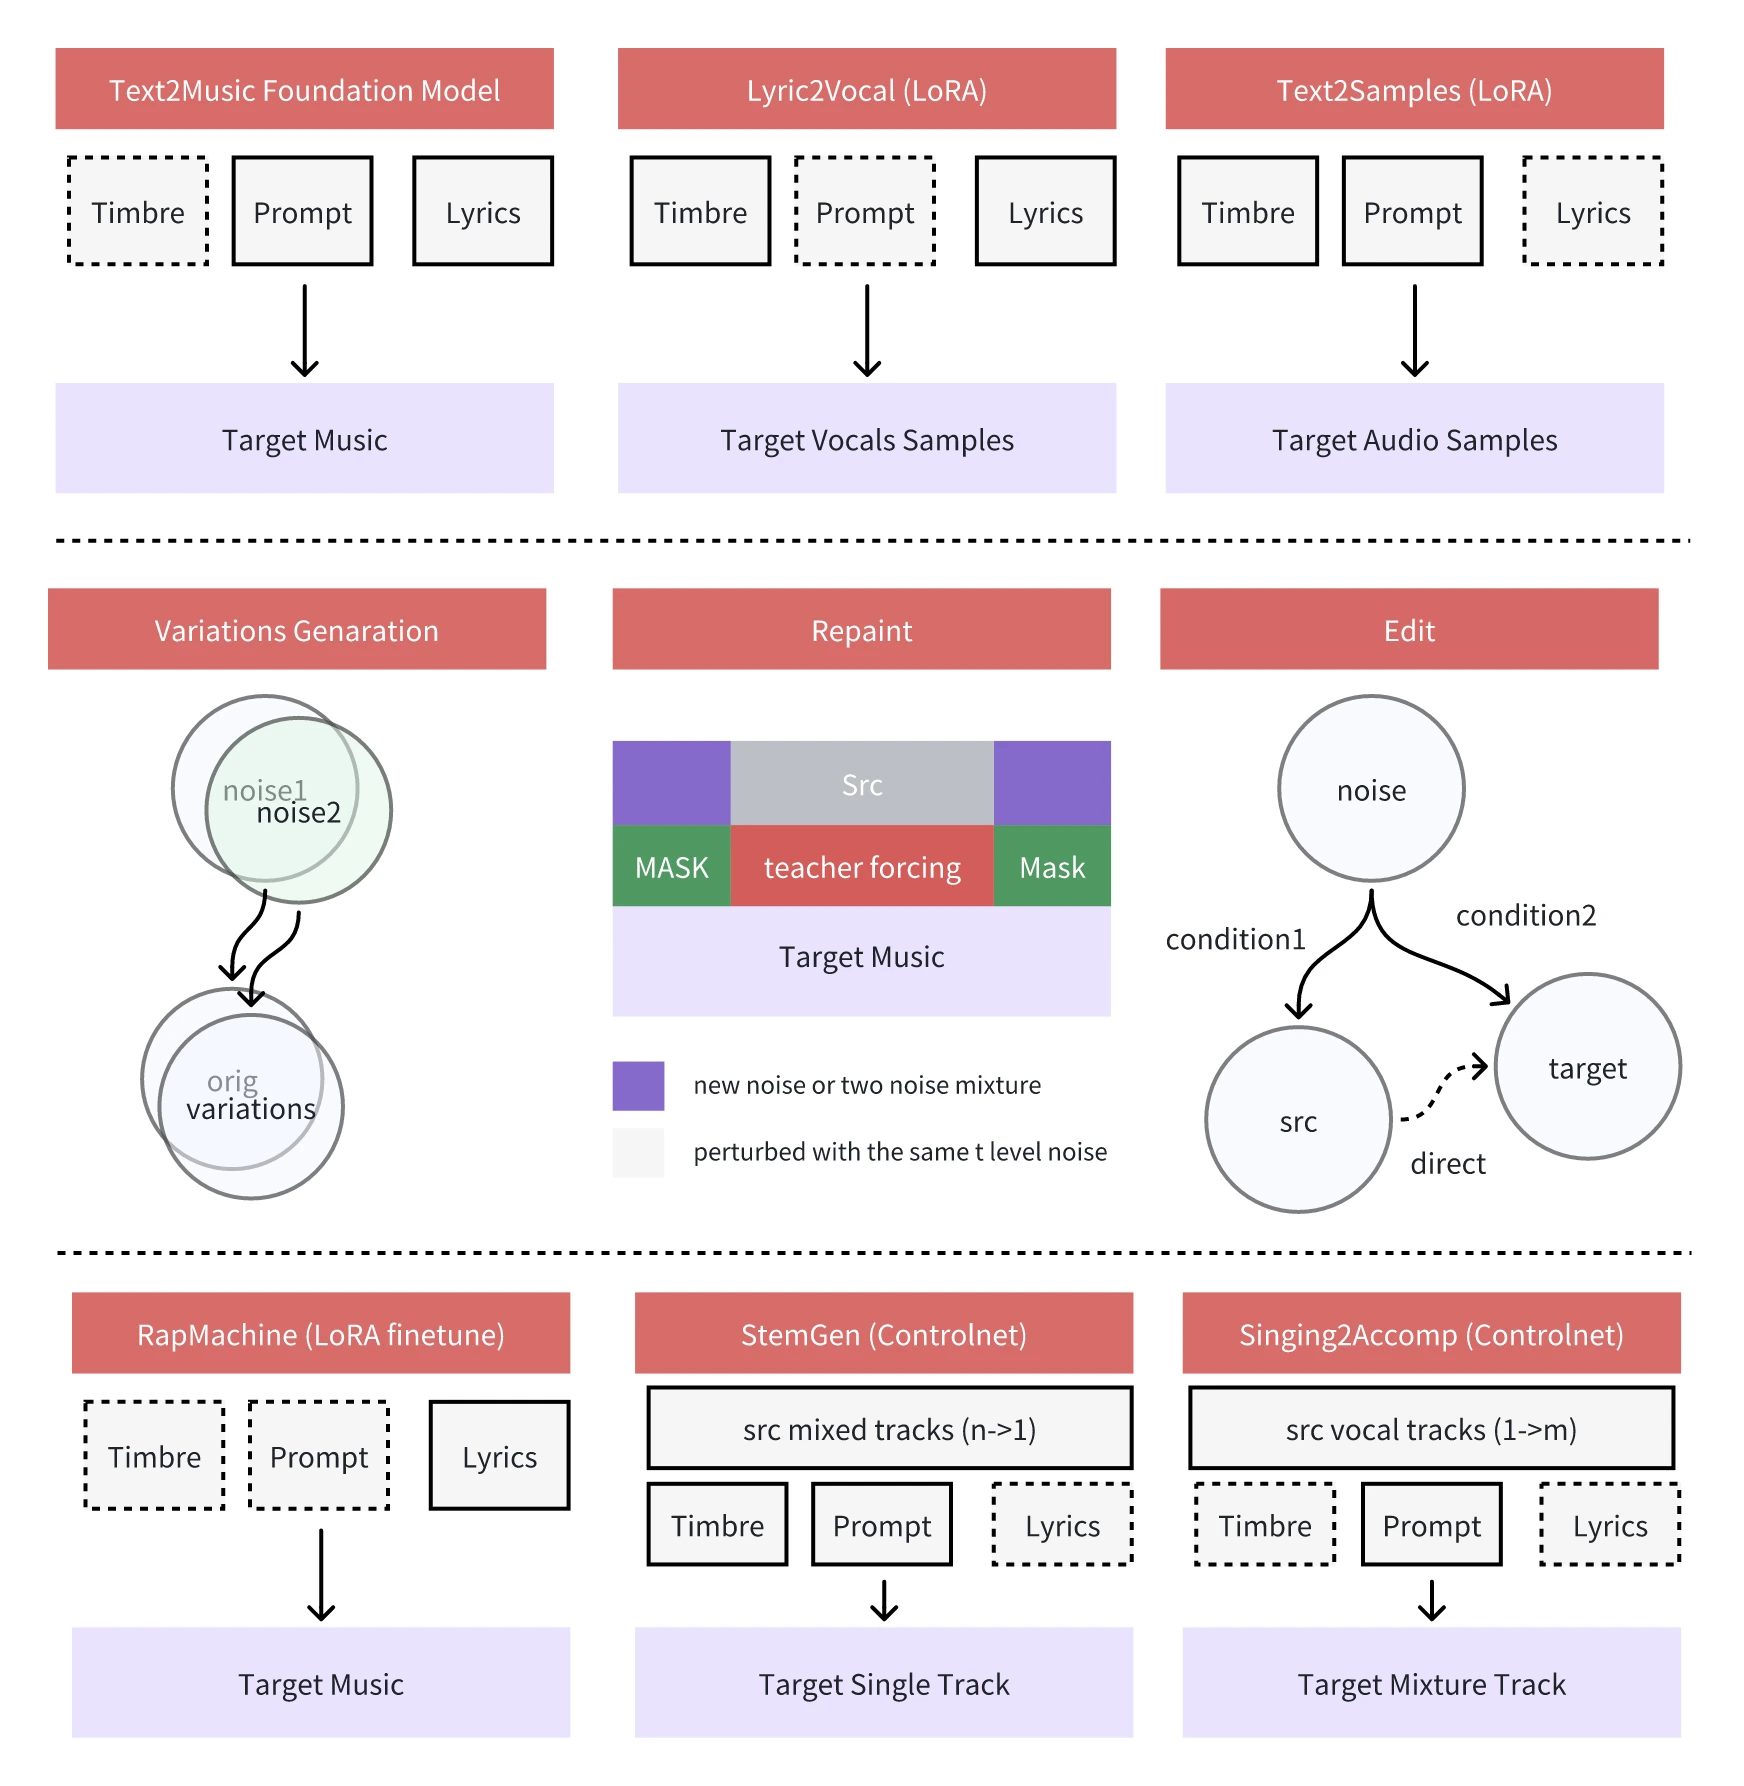
Scénarios d'application d'ACE-Step
Lyric2Vocal (LoRA) : affinage LoRA basé sur des données purement vocales, permettant de générer directement des échantillons vocaux à partir de paroles, utiles pour les démos vocales, l'aide à la composition de chansons, etc.
Text2Samples (LoRA) : affinage LoRA basé sur des données purement instrumentales et d'échantillons, permettant de générer des échantillons de production musicale conceptuels à partir de descriptions textuelles, utiles pour créer des boucles d'instruments, des effets sonores, etc.
Limites d'ACE-Step
Incohérence des sorties : sensible à la graine aléatoire et à la durée d'entrée, les résultats sont instables.
Performances inégales selon les styles : médiocres sur certains styles spécifiques (comme le rap chinois).
Problèmes de continuité : transitions peu naturelles lors des opérations de repeint ou d'extension.
Qualité vocale à améliorer : les voix synthétisées sont relativement rugueuses et manquent de détails.
Granularité de contrôle insuffisante : nécessite un contrôle plus fin des paramètres musicaux.
Optimisation des paroles multilingues : il faut améliorer la prise en charge des paroles multilingues pour renforcer la précision et le naturel.
Questions fréquentes sur ACE-Step
Par rapport aux autres modèles de génération musicale, quel est le plus grand avantage d'ACE-Step ?
Réponse :Le plus grand avantage d'ACE-Step est qu'il résout le compromis entre vitesse de génération, cohérence musicale et contrôlabilité rencontré par les modèles existants. Il peut synthétiser jusqu'à 4 minutes de musique en 20 secondes sur un GPU A100, soit 15 fois plus vite que les modèles de référence basés sur les LLM, tout en obtenant une meilleure cohérence musicale et un meilleur alignement des paroles sur les indicateurs de mélodie, d'harmonie et de rythme. Il dispose également de puissantes fonctionnalités de contrôle, telles que le clonage vocal et l'édition des paroles, qui sont difficiles à obtenir simultanément par d'autres modèles.
Quels sont les problèmes d'ACE-Step en matière de support multilingue ?
Réponse :Bien qu'ACE-Step prenne en charge 19 langues, en raison de déséquilibres dans les données, les langues les moins courantes présentent des performances inférieures. Lors du traitement de paroles multilingues, la précision et le naturel doivent être améliorés ; un travail d'optimisation supplémentaire est nécessaire pour renforcer le support des paroles multilingues et améliorer les performances globales du modèle dans différentes langues.
Dans les scénarios d'application d'ACE-Step, à quelles étapes de création correspondent respectivement Lyric2Vocal et Text2Samples ?
Réponse :Lyric2Vocal, basé sur un affinage LoRA de données purement vocales, convient à l'étape de démo vocale dans la composition de chansons, aidant les créateurs à tester rapidement l'effet du chant des paroles. Il peut également être utilisé pour produire des pistes引导 (guides), aider à la composition et mener des expériences d'arrangement vocal. Text2Samples, basé sur un affinage LoRA de données purement instrumentales et d'échantillons, convient à la création rapide, en amont de la production musicale, de boucles d'instruments, d'effets sonores et de divers éléments musicaux, fournissant des échantillons conceptuels pour la production musicale et améliorant l'efficacité créative.
Liens connexes
https://ace-step.github.io/









