
 Assistant scénario▸
 Apps AI
 Actualités AI
LLMWhisperer : outil d'analyse pour convertir des documents complexes en texte structuré
小编 ·

LLMWhisperer : outil d'analyse pour convertir des documents complexes en texte structuré
Qu'est-ce que LLMWhisperer ?
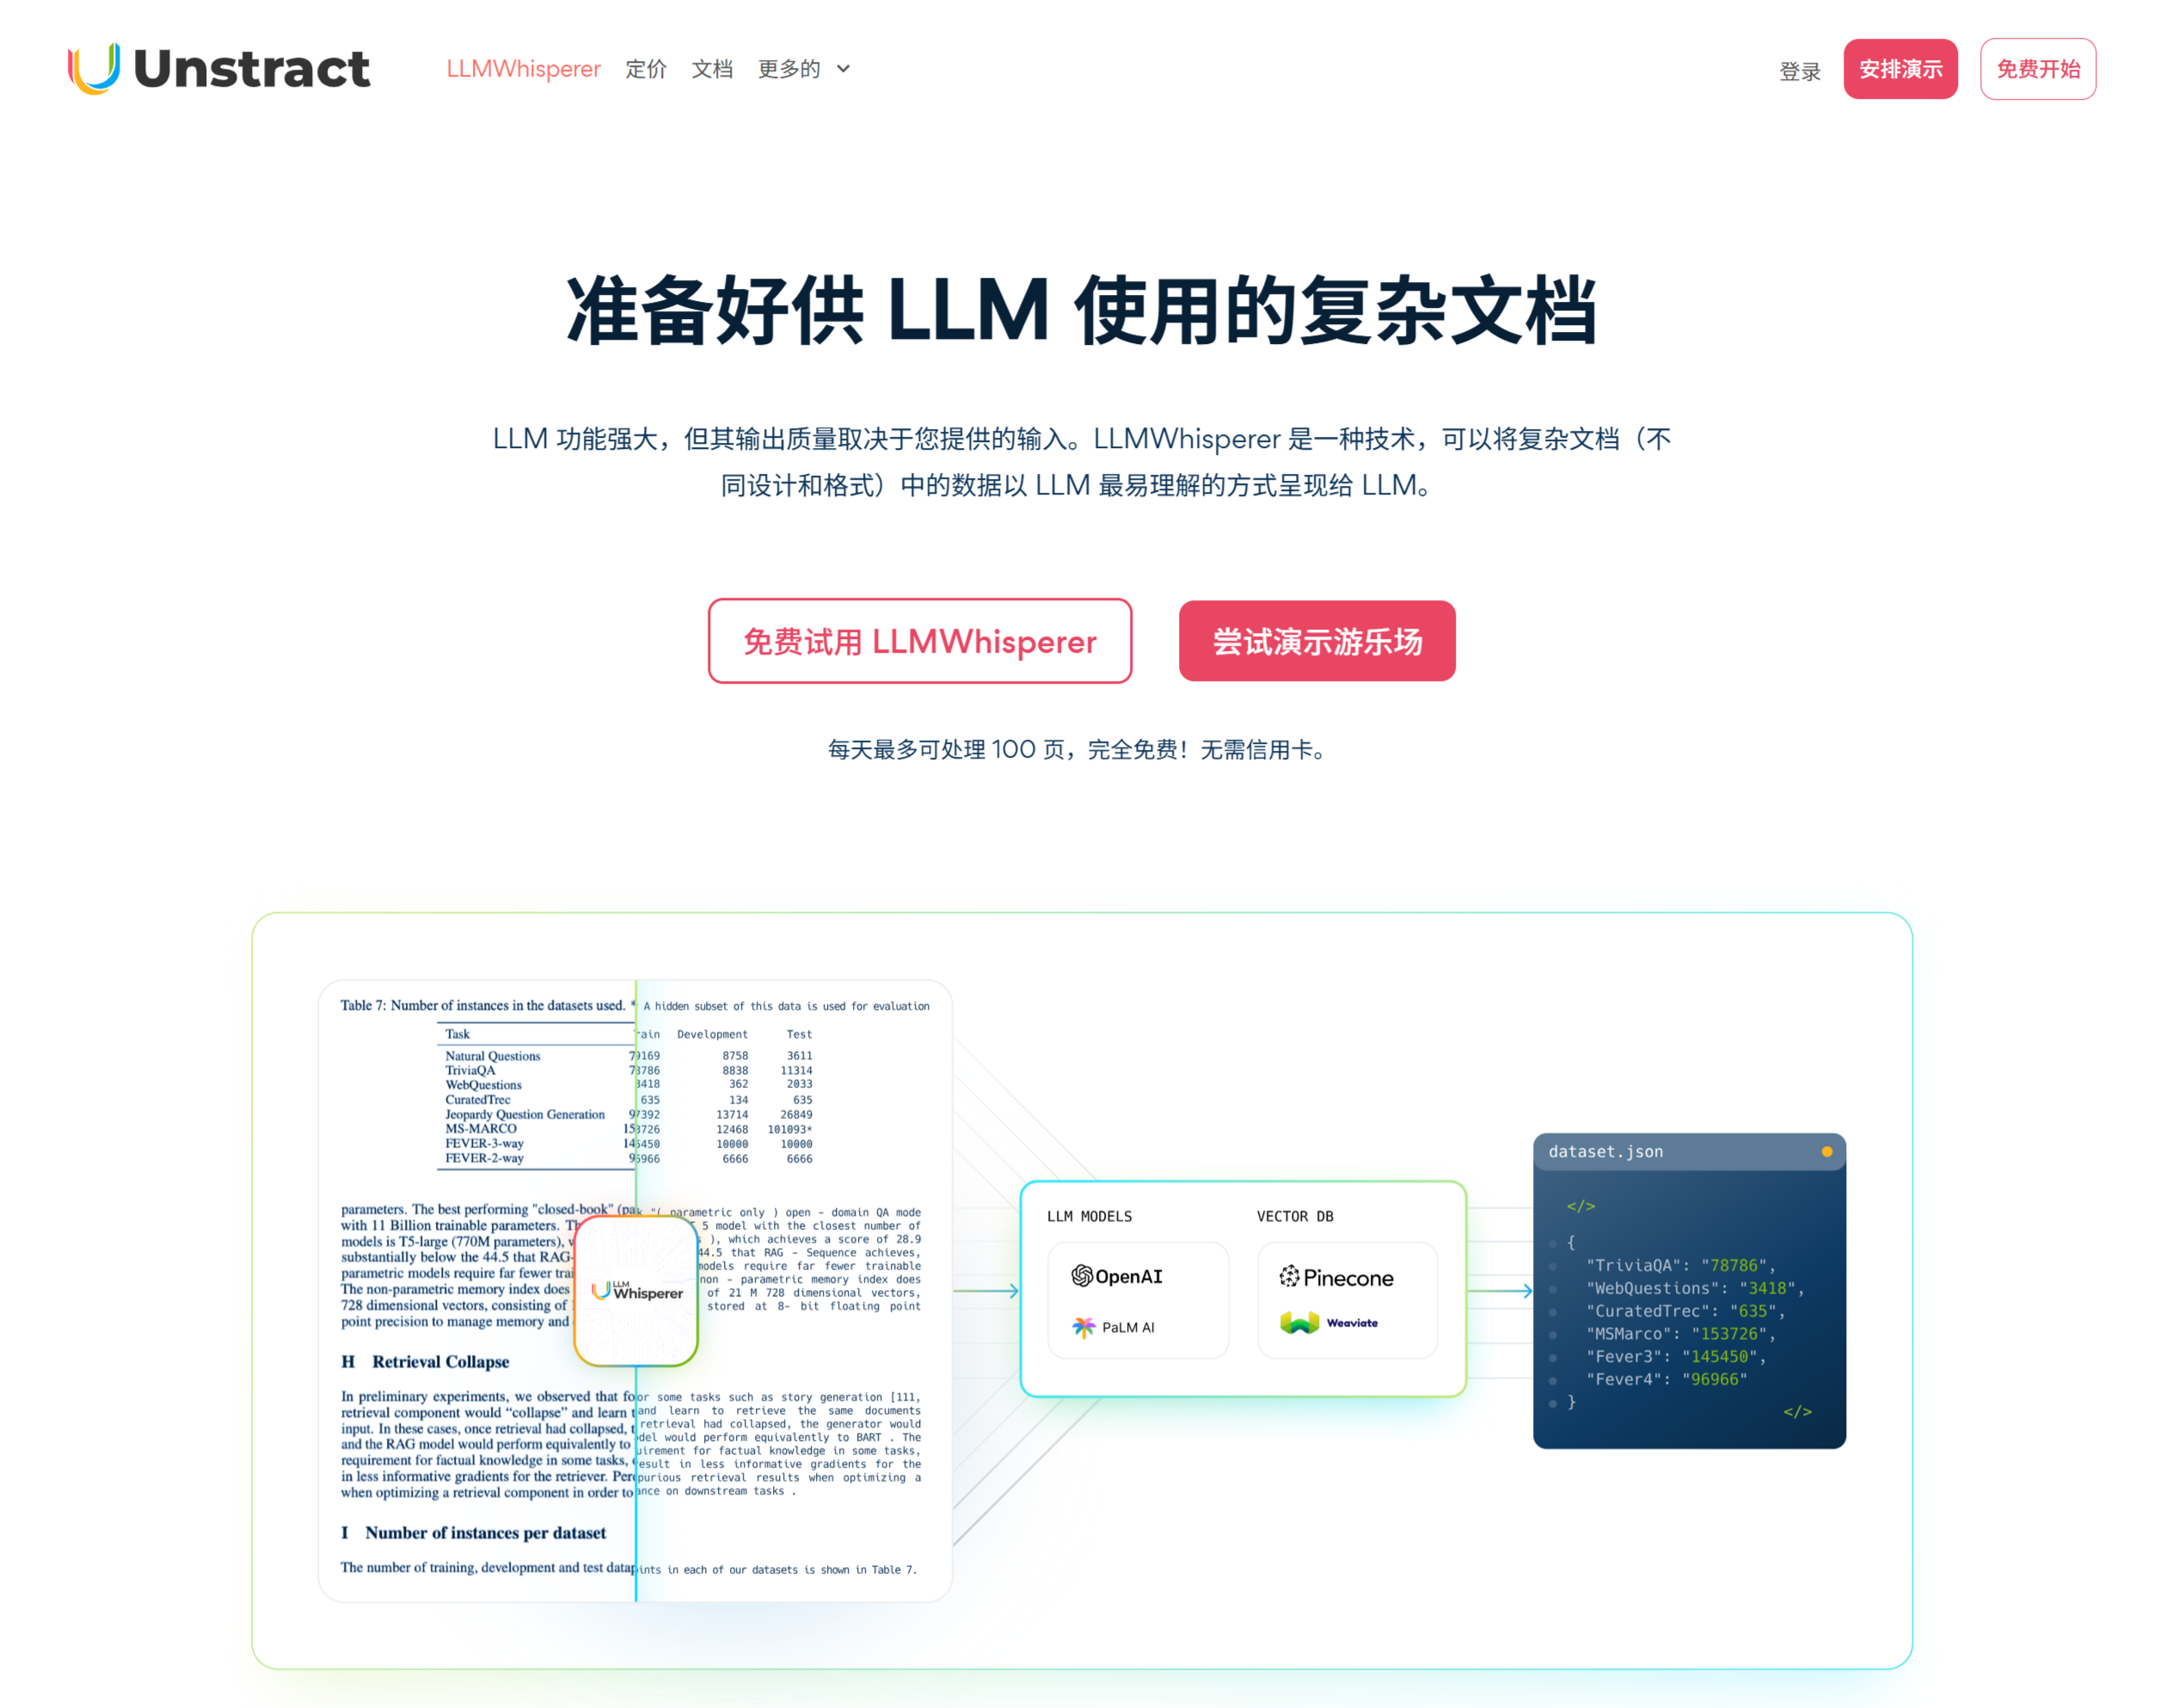
LLMWhisperer est un outil capable d'analyser des documents complexes au format LLM. Il permet d'extraire efficacement le texte, les URL, les métadonnées et d'autres informations approfondies des documents, et de les restituer dans un format structuré clair. Il prend en charge divers formats tels que les PDF et les images, et peut également extraire automatiquement des informations importantes comme les noms et les adresses. Il offre un traitement gratuit de 100 pages de documents par jour.
Il propose également un environnement de test en ligne, fournit des API et des kits de développement (SDK) pour JS/Python, et s'intègre facilement avec des technologies couramment utilisées telles que Next.js, Node.js et les bases de données. Son utilisation permet de réduire considérablement les coûts liés au traitement des entrées d'images, ce qui le rend particulièrement adapté aux scénarios impliquant des factures, des pièces d'identité et des notes de frais.
Fonctionnalités de LLMWhisperer
Préservation de la mise en page : le mode de préservation de la mise en page de LLMWhisperer permet de conserver la structure d'origine du document, y compris les tableaux, les paragraphes, les mises en page multi-colonnes, etc., garantissant ainsi la cohérence des données extraites avec le document d'origine.
Changement de mode automatique : l'outil est capable d'identifier automatiquement le type de document et de basculer entre le mode texte et le mode OCR. Si le document est une image numérisée ou contient du contenu manuscrit, il bascule automatiquement en mode OCR.
Reconnaissance des éléments de formulaire : LLMWhisperer est capable de reconnaître les cases à cocher et les boutons radio dans les formulaires PDF, et de présenter leurs valeurs sous forme de texte brut, facilitant ainsi leur compréhension par les LLM.
Compression automatique : lors du traitement des documents, LLMWhisperer peut compresser automatiquement les tokens superflus, réduisant ainsi le temps et les coûts de traitement tout en préservant les informations clés.
Prise en charge multilingue : LLMWhisperer prend en charge plus de 300 langues et peut traiter des documents multilingues, y compris ceux comportant des alphabets non latins (tels que l'arabe, le chinois, le japonais, etc.).
Prise en charge de plusieurs formats de documents : prise en charge des fichiers PDF, des images (JPEG, PNG, etc.), des fichiers MS Office (Word, Excel, PowerPoint), des formats OpenDocument (ODT, ODP, ODS) et des fichiers texte brut (TXT).
Comment utiliser LLMWhisperer
Intégration API : LLMWhisperer fournit une interface API qui peut être intégrée aux systèmes existants pour automatiser le prétraitement des documents.
Bibliothèques clientes : les utilisateurs peuvent appeler ses fonctionnalités en installant les bibliothèques clientes de LLMWhisperer (telles que llmwhisperer-client pour Python).
Test en ligne : LLMWhisperer propose un environnement Playground en ligne, permettant aux utilisateurs de télécharger des documents pour des tests en temps réel, sans inscription ni installation de logiciel.
Capacités d'optimisation
Changement de mode automatique : lors du traitement d'un document, si l'extraction en mode texte produit des résultats insuffisants, basculement automatique vers le mode OCR.
Compression automatique : compression des balises sans valeur pour la sortie tout en préservant la mise en page, réduisant ainsi le temps et les coûts de traitement pour les LLMs.
Contrôle du prétraitement : possibilité de contrôler le prétraitement des images numérisées et d'ajuster des paramètres tels que le filtre médian et le flou gaussien via l'API.
Site officiel :https://unstract.com/llmwhisperer/









