
 Assistant scénario▸
 Apps AI
 Actualités AI
Muyan-TTS : un modèle TTS open-source et entraînable de Muyan, conçu pour les podcasts
小编 ·

Muyan-TTS : un modèle TTS open-source et entraînable de Muyan, conçu pour les podcasts
Qu'est-ce que Muyan-TTS ?
Muyan-TTS est un modèle TTS open source et entraînable publié par Muyan Intelligence (Beijing), spécialement conçu pour les podcasts, avec un budget inférieur à 50 000 dollars américains. Muyan-TTS est pré-entraîné sur plus de 100 000 heures de données audio de podcasts, prend en charge la synthèse TTS zéro-shot, est capable de générer une voix de haute qualité, et prend également en charge l'adaptation au locuteur via quelques dizaines de minutes de voix cible.
Caractéristiques du modèle Muyan-TTS
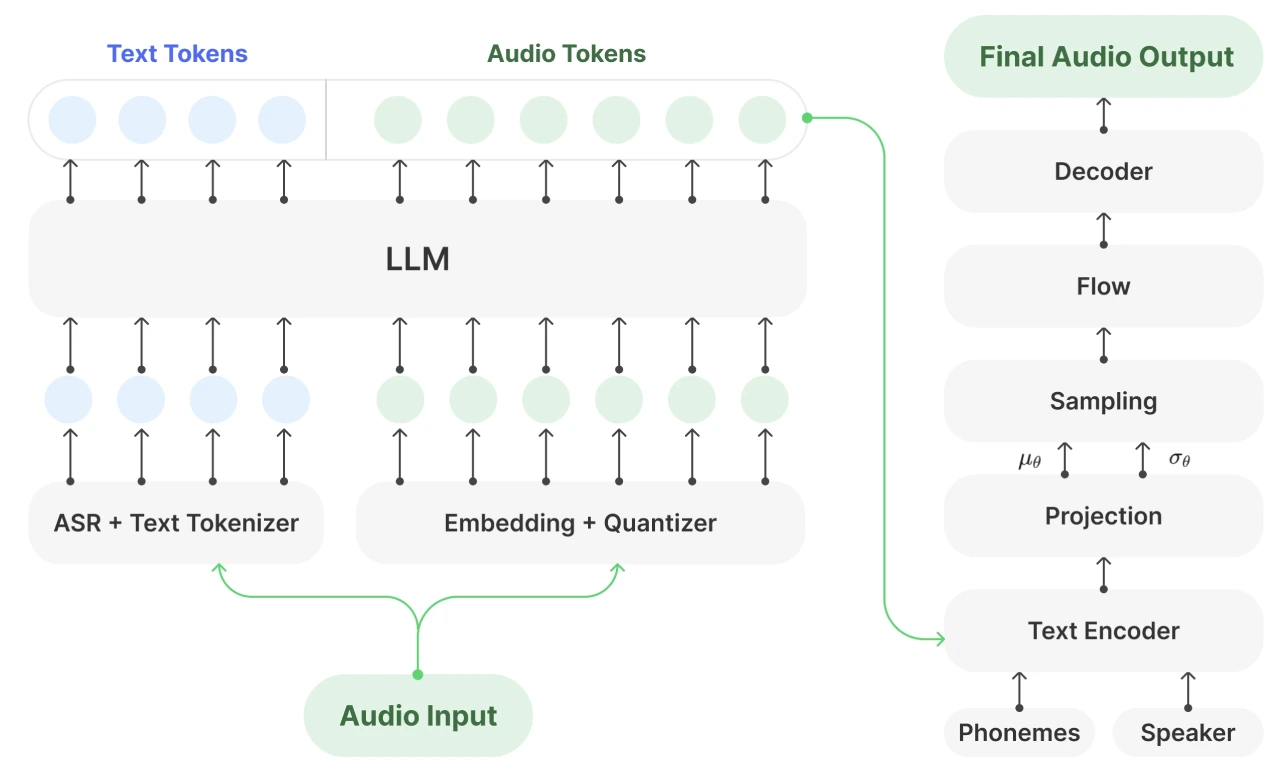
Pré-entraînement à grande échelle : Muyan-TTS est basé sur le modèle Llama-3.2-3B, pré-entraîné sur plus de 100 000 heures de données audio de podcasts, capable de réaliser une synthèse ia texte-vers-parole zéro-shot et de générer une voix de haute qualité.
Prise en charge de l'adaptation au locuteur : grâce à quelques dizaines de minutes de données vocales du locuteur cible, Muyan-TTS peut s'adapter davantage aux caractéristiques vocales d'un locuteur spécifique, permettant ainsi une synthèse vocale hautement personnalisée.
Conception de l'architecture : Muyan-TTS adopte la structure en deux étapes de GPT-SoVITS. La partie modèle de langage utilise Llama-3.2-3B comme backbone et continue le pré-entraînement, tandis que la partie décodeur utilise l'architecture SoVITS, combinant la capacité de modélisation sémantique du LLM et les caractéristiques phonème-à-phonème (G2P) du modèle VITS, réduisant efficacement les phénomènes d'hallucination.
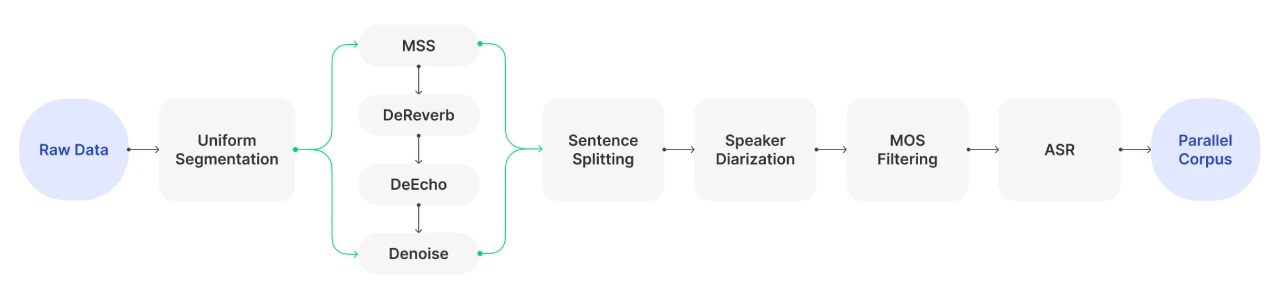
Traitement des données : un corpus parallèle contenant plus de 100 000 heures de voix de haute qualité avec les transcriptions correspondantes a été construit, adapté à l'entraînement TTS pour des scénarios audio longs tels que les podcasts.
Open source et entraînement
Informations open source : Muyan-TTS est entièrement open source, fournissant un flux complet de collecte et de traitement des données, des méthodes d'entraînement détaillées ainsi qu'un cadre d'inférence optimisé. Son code et ses modèles sont disponibles sur GitHub.
Coût d'entraînement : en termes de coût d'entraînement, en supposant que les prix de location des GPU A10 et A100 sont respectivement de 0,5 $ et 1 $ par heure, le coût total d'entraînement de Muyan-TTS est d'environ 50 540 dollars américains.
Performances
Synthèse zéro-shot : sur le jeu de données LibriSpeech, les performances de synthèse zéro-shot de Muyan-TTS sont excellentes, avec un taux d'erreur sur les mots仅次于 CosyVoice2, et un score moyen d'opinion supérieur à ceux de Spark-TTS et GPT-SoVITS v3.
Modèle de fine-tuning supervisé : après le fine-tuning supervisé, Muyan-TTS-SFT surpasse le modèle de base en termes de qualité vocale et de similarité avec le locuteur, mais présente une légère baisse du WER.
Vitesse d'inférence : la vitesse d'inférence de Muyan-TTS est la plus rapide parmi tous les modèles testés, ne nécessitant que 0,33 seconde pour synthétiser 1 seconde de parole, ce qui le rend adapté aux scénarios de génération vocale en temps réel.
Scénarios d'application de Muyan-TTS
Muyan-TTS convient à de nombreuses formes de contenu audio, telles que les voix off d'animateurs, la reproduction d'interviews, les résumés vocaux, etc. Il équilibre qualité de synthèse, capacité de personnalisation et efficacité d'exécution, et est adapté aux scénarios audio longs tels que les podcasts.
Limitations
Il dépend du module G2P dans le décodeur, nécessitant une séquence phonémique complète pour la synthèse, ce qui empêche l'inférence en streaming.
Les données d'entraînement sont principalement en anglais, ce qui limite les capacités de synthèse vocale multilingue.
En raison de l'absence d'annotations au niveau des instructions dans le corpus d'entraînement, Muyan-TTS ne prend pas actuellement en charge les tâches TTS avec suivi d'instructions.
Installation et utilisation de Muyan-TTS
Étapes d'installation
1. Cloner le dépôt et créer un environnement virtuel :
git clone https://github.com/MYZY-AI/Muyan-TTS.git
cd Muyan-TTS
conda create -n muyan-tts python=3.10 -y
conda activate muyan-tts
make build
2. Installer FFmpeg (système Ubuntu) :
sudo apt update
sudo apt install ffmpeg
3. Télécharger les modèles :
Les modèles Muyan-TTS et Muyan-TTS-SFT peuvent être téléchargés depuis Hugging Face ou ModelScope.
Vous devez également télécharger les poids de chinese-hubert-base.
Placez tous les modèles téléchargés dans le répertoire pretrained_models.
Méthode d'utilisation
Exécutez la commande suivante pour effectuer la synthèse vocale :
python tts.py
Le code d'inférence principal est le suivant :
async def main(model_type, model_path):
tts = Inference(model_type, model_path, enable_vllm_acc=False)
wavs = await tts.generate(
ref_wav_path="assets/Claire.wav",
prompt_text="Although the campaign was not a complete success, it did provide Napoleon with valuable experience and prestige.",
text="Welcome to the captivating world of podcasts, let's embark on this exciting journey together."
)
output_path = "logs/tts.wav"
with open(output_path, "wb") as f:
f.write(next(wavs))
print(f"Speech generated in {output_path}")
Dépôt GitHub :https://github.com/MYZY-AI/Muyan-TTS









