
 Assistant scénario▸
 Apps AI
 Actualités AI
Xiaomi MiMo : le premier LLM open-source de Xiaomi conçu pour le raisonnement
小编 ·

Xiaomi MiMo : le premier LLM open-source de Xiaomi conçu pour le raisonnement
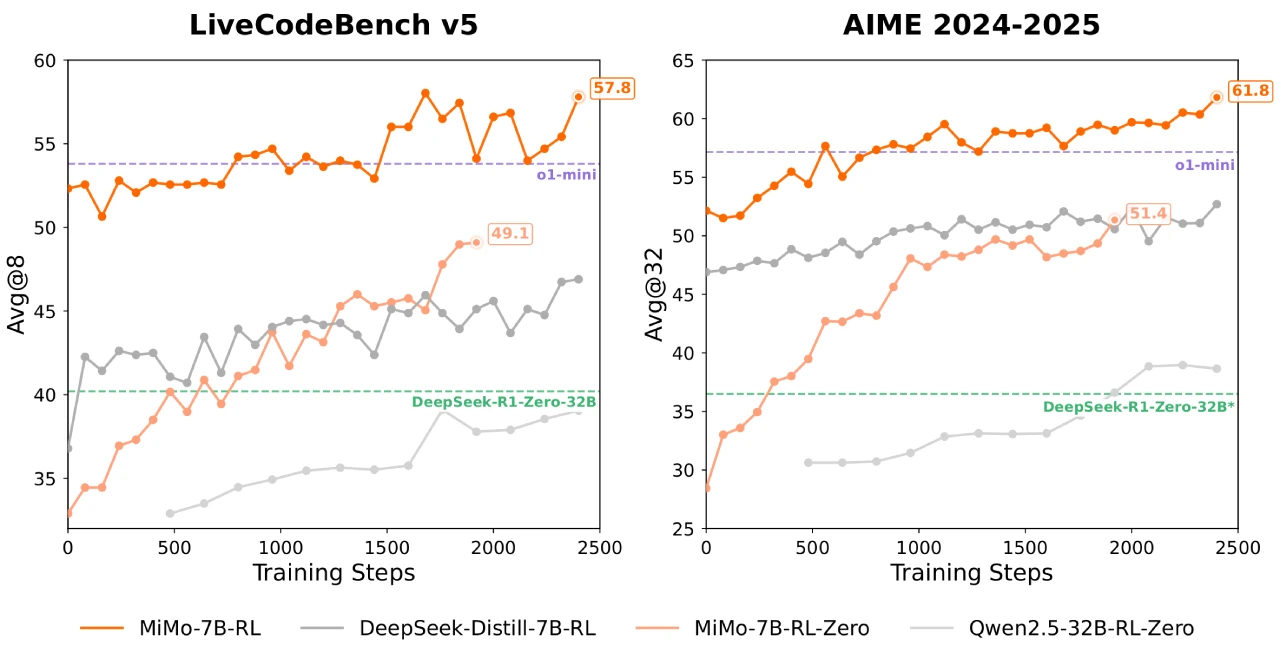
Xiaomi MiMo est le premier grand modèle d'IA conçu pour le raisonnement, open source par Xiaomi, annoncé le 30 avril 2025. La série de modèles MiMo - 7B exploite pleinement le potentiel de raisonnement des modèles de langage, en se concentrant non seulement sur le post-entraînement, mais aussi sur les stratégies de pré-entraînement axées sur le raisonnement. Avec une taille relativement modeste de 7B, cette série de modèles démontre des capacités de raisonnement surpassant de nombreux modèles 32B, parmi lesquels MiMo - 7B - RL atteint des performances comparables à celles d'OpenAI o1 - mini sur les tâches de raisonnement mathématique et de code.
Caractéristiques principales de MiMo
Pré-entraînement
Optimisation du prétraitement des données : amélioration de la boîte à outils d'extraction de texte, adoption d'un filtrage multidimensionnel des données, augmentation de la densité des schémas de raisonnement dans les données de pré-entraînement.
Génération de données synthétiques : utilisation de plusieurs stratégies pour générer de grandes quantités de données de raisonnement synthétiques diversifiées.
Mélange de données en trois phases : le pré-entraînement adopte une stratégie de mélange de données en trois phases, MiMo - 7B - Base est pré-entraîné sur environ 25 000 milliards de tokens.
Prédiction multi-tokens : introduction de la prédiction multi-tokens comme objectif d'entraînement supplémentaire, améliorant les performances du modèle et accélérant l'inférence.
Post-entraînement
Données d'entraînement de qualité : sélection rigoureuse de 130K problèmes de mathématiques et de code comme données d'entraînement RL, chaque problème étant soigneusement nettoyé et évalué en termes de difficulté, avec l'utilisation de validateurs basés sur des règles pour garantir la qualité des données.
Mécanisme de récompense pour le code : pour les problèmes de code difficiles, introduction d'une récompense basée sur la difficulté des tests, en attribuant des scores granulaires aux cas de test de différentes difficultés, afin d'optimiser la politique.
Rééchantillonnage des données : mise en œuvre d'une stratégie de rééchantillonnage des données pour les problèmes simples, améliorant l'efficacité du sampling et stabilisant la mise à jour de la politique.
Infrastructure RL
Moteur de rollout transparent : développement d'un moteur de rollout transparent intégrant le rollout continu, le calcul asynchrone des récompenses et des fonctions d'arrêt anticipé, réduisant les temps d'inactivité des GPU, multipliant la vitesse d'entraînement par 2,29 et la vitesse de validation par 1,96.
Prise en charge MTP : prise en charge de MTP dans vLLM et renforcement de la robustesse du moteur d'inférence dans le système RL.
Versions du modèle MiMo
MiMo - 7B - Base : modèle de base avec un potentiel de raisonnement exceptionnel
MiMo - 7B - RL - Zero : modèle RL entraîné à partir du modèle de base
MiMo - 7B - SFT : modèle SFT entraîné à partir du modèle de base
MiMo - 7B - RL : modèle RL entraîné à partir du modèle SFT, avec des performances comparables à celles d'OpenAI o1 - mini.
Détails techniques et innovations
Optimisation des données de pré-entraînement : grâce au filtrage multidimensionnel des données et à la génération de données de raisonnement synthétiques, la qualité des données de pré-entraînement et la densité des schémas de raisonnement ont été améliorées.
Module MTP : l'introduction du module MTP dans le pré-entraînement a considérablement amélioré les performances et la vitesse d'inférence sur les tâches de raisonnement.
Infrastructure RL : développement du moteur de rollout transparent (Seamless Rollout Engine), accélérant l'entraînement et la validation RL, avec des gains de vitesse respectifs de 2,29x et 1,96x.
Mécanisme de récompense basé sur la difficulté des tests : pour résoudre le problème des récompenses clairsemées dans les problèmes de code, un mécanisme de récompense basé sur la difficulté des tests a été proposé, améliorant l'efficacité d'apprentissage du modèle sur les problèmes difficiles.
Expériences et résultats
Performances du modèle de pré-entraînement
MiMo-7B-Base : surpasse d'autres modèles open source de taille 7B sur plusieurs benchmarks, tels que BBH, SuperGPQA, etc.
Évaluation du potentiel de raisonnement : l'utilisation de la métrique pass@k pour évaluer le potentiel de raisonnement montre que MiMo-7B-Base obtient des scores pass@k plus élevés sur tous les benchmarks.
Performances du modèle de post-entraînement
MiMo-7B-RL-Zero : entraîné directement par RL à partir de MiMo-7B-Base, démontre de solides capacités de raisonnement.
MiMo-7B-RL : entraîné par RL à partir du modèle SFT, finit par surpasser le modèle o1-mini d'OpenAI sur les tâches de mathématiques et de code.
Performances spécifiques :
Sur AIME 2025, MiMo-7B-RL obtient un score de 55,4, dépassant o1-mini de 4,7 points.
Sur LiveCodeBench v5 et v6, MiMo-7B-RL surpasse significativement o1-mini.
Liens connexes
Plateforme Hugging Face :https://huggingface.co/XiaomiMiMo
Dépôt GitHub :https://github.com/XiaomiMiMo/MiMo
Rapport technique :https://github.com/XiaomiMiMo/MiMo/blob/main/MiMo-7B-Technical-Report.pdf









