
 Assistant scénario▸
 Apps AI
 Actualités AI
Alibaba lance Qwen3 : deux modes de réflexion et prise en charge multilingue
小编 ·

Alibaba lance Qwen3 : deux modes de réflexion et prise en charge multilingue
Alibaba a officiellement lancé la série de modèles Qwen3 le 29 avril 2025. Il s'agit du dernier membre de la série de grands modèles linguistiques Qwen. Le modèle phare Qwen3-235B-A22B ainsi que le petit modèle MoE Qwen3-30B-A3B, parmi d'autres, ont obtenu d'excellents résultats sur des benchmarks de code, de mathématiques et de capacités générales. Qwen3 a publié en open source les poids de plusieurs modèles et est disponible sur plusieurs plateformes.
Qwen3 prend en charge deux modes de réflexion, dispose de capacités multilingues, et optimise les capacités d'Agent et de code. Ses données de pré-entraînement atteignent environ 36 000 milliards de tokens, le pré-entraînement se déroule en trois étapes, et le post-entraînement suit un流程 en quatre étapes.
Points forts du modèle
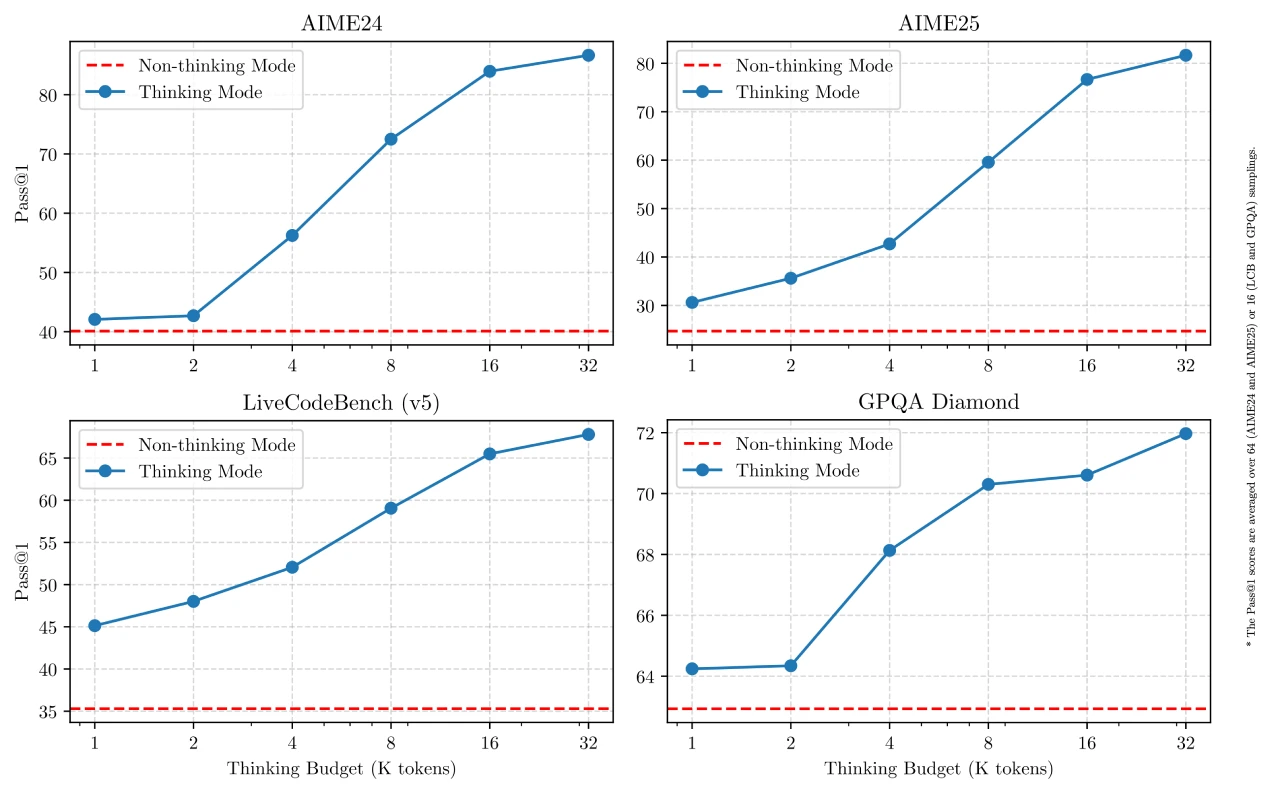
Modes de réflexion multiples : prend en charge les modes réflexion et non-réflexion. Le mode réflexion convient aux problèmes complexes, le modèle raisonne étape par étape ; le mode non-réflexion convient aux problèmes simples et fournit une réponse rapide. La combinaison des deux modes renforce la capacité de contrôle du « budget de réflexion », configurable par l'utilisateur selon ses besoins.
Capacités multilingues : prend en charge 119 langues et dialectes, couvrant plusieurs familles linguistiques telles que les langues indo-européennes et sino-tibétaines, offrant des possibilités pour les applications internationales.
Capacités d'Agent améliorées : optimisation des capacités d'Agent et de code, renforcement du support de MCP, permettant de réduire la complexité du code pour l'appel d'outils via Qwen-Agent.
Performances de Qwen3
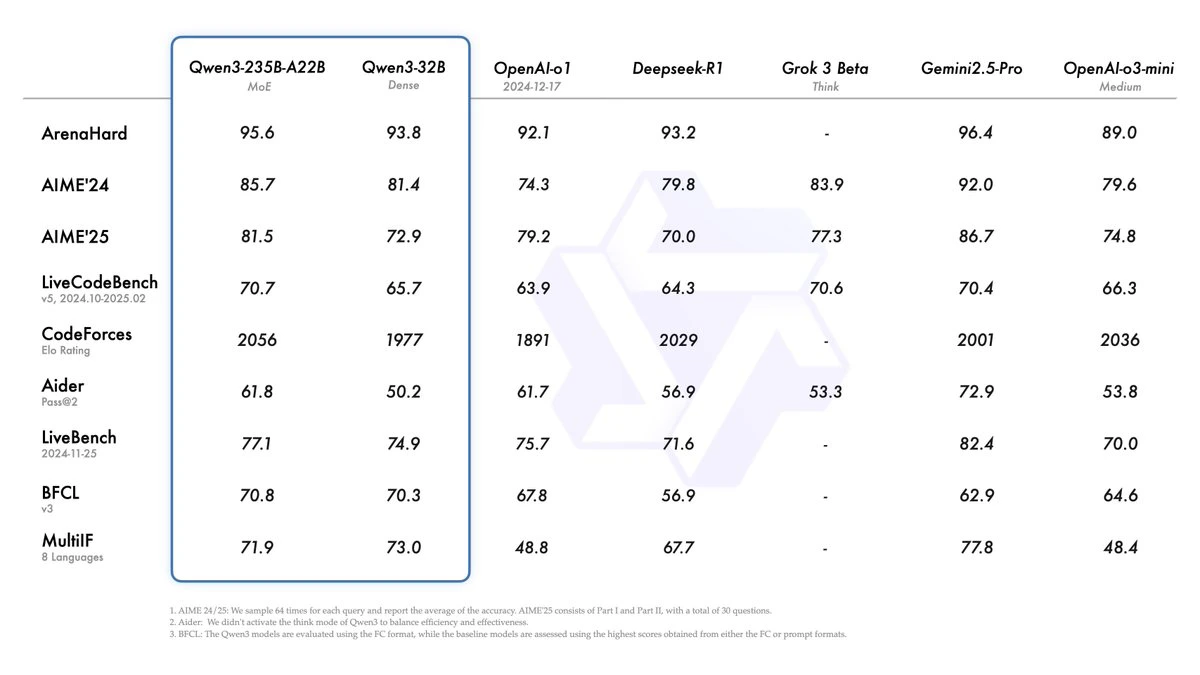
Modèle phare : Qwen3-235B-A22B est le modèle phare de la série, avec plus de 235 milliards de paramètres totaux et plus de 22 milliards de paramètres activés. Sur les benchmarks de code, de mathématiques et de capacités générales, ce modèle affiche des résultats très compétitifs face à des modèles de premier plan tels que DeepSeek-R1, les o1 et o3-mini d'Openai, Grok-3 de Musk et Gemini-2.5-Pro de Google.
Petit modèle : le petit modèle MoE Qwen3-30B-A3B dispose d'un nombre de paramètres activés représentant 10 % de celui de QwQ-32B, tout en offrant de meilleures performances. Par ailleurs, un petit modèle tel que Qwen3-4B peut égaler les performances de Qwen2.5-72B-Instruct.
Caractéristiques techniques de Qwen3
Modèle de raisonnement hybride : Qwen3 est le premier « modèle de raisonnement hybride » en Chine, intégrant la « réflexion rapide » et la « réflexion lente » dans un même modèle. Cette conception permet au modèle de raisonner en profondeur sur des problèmes complexes tout en répondant rapidement aux requêtes simples.
Support multilingue : Qwen3 prend en charge 119 langues et est entraîné sur près de 36 000 milliards de tokens, soit deux fois plus de données d'entraînement que Qwen2.5.
Longueur du contexte : Qwen3 prend en charge une longueur de contexte allant jusqu'à 256K, ce qui lui permet de gérer des tâches complexes telles que l'analyse de longs documents, la génération de code et les conversations multi-tours.
Performances et coûts des modèles Qwen3
Modèle phare Qwen3-235B-A22B : nombre total de paramètres de 235 milliards, paramètres activés de 22 milliards. Par rapport à DeepSeek-R1, son nombre total de paramètres ne représente qu'un tiers, et les coûts de déploiement devraient être réduits de plus de moitié. De plus, ce modèle permet d'activer à la demande le mode « réflexion approfondie », et peut être déployé localement avec seulement 4 cartes H20.
Qwen3-30B-A3B : nombre total de paramètres de 30 milliards, paramètres activés de 3 milliards, performances globales comparables à celles de Qwen2.5-32B.
Fonctionnalités de Qwen3
Support natif du protocole MCP : la série Qwen3 dispose de capacités d'appel d'outils, combinées à son propre framework Qwen-Agent, ce qui réduit considérablement la complexité de la programmation, prend en charge des tâches d'opération d'Agent sur téléphone et ordinateur, et fait passer l'IA de la conversation à l'exécution.
Support multilingue : prend en charge 119 langues, notamment le chinois, l'anglais, le français, l'espagnol, le russe, l'arabe, etc.
Modèles open source : la série Qwen3 a publié en open source 8 modèles, dont :
6 modèles Dense : 0.6B, 1.7B, 4B, 8B, 14B, 32B
2 modèles MoE : Qwen3-30B-A3B et le modèle phare Qwen3-235B-A22B
Le plus petit modèle Qwen3-0.6B : léger, idéal pour un déploiement sur des appareils en edge tels que les smartphones, tout en conservant de bonnes capacités de compréhension et de génération, parfaitement adapté aux applications intelligentes en périphérie.
Processus d'entraînement
Pré-entraînement : le jeu de données a été considérablement élargi par rapport à Qwen2.5, atteignant environ 36 000 milliards de tokens, soit le double de Qwen2.5. Les sources de données incluent le web, des documents PDF, etc., et des modèles experts sont utilisés pour synthétiser des données mathématiques et de code. Le pré-entraînement se déroule en trois étapes : depuis l'entraînement aux compétences linguistiques de base, en passant par l'ajout de données intensives en connaissances, jusqu'à l'extension de la longueur du contexte à 32K tokens.
Post-entraînement : adoption d'un流程 d'entraînement en quatre étapes, incluant le démarrage à froid avec chaîne de pensée longue, l'apprentissage par renforcement avec chaîne de pensée longue, la fusion des modes de pensée, et l'apprentissage par renforcement général, afin de développer un modèle hybride alliant raisonnement réfléchi et réponse rapide.
Méthode d'utilisation
Utilisation de base : un exemple de code standard est disponible pour utiliser Qwen3-30B-A3B dans les transformers de Hugging Face, permettant de basculer entre les modes de réflexion en modifiant le paramètre enable_thinking.
Déploiement : l'utilisation de sglang>=0.4.6.post1 ou vllm>=0.8.4 permet de créer un point d'accès API compatible avec l'API OpenAI ; la suppression de certains paramètres permet de désactiver le mode réflexion.
Développement local : des outils tels que ollama, LMStudio, llama.cpp et ktransformers peuvent être utilisés pour le développement local.
Usage avancé : un mécanisme de commutation souple est fourni, permettant d'activer/désactiver le mode réflexion à chaque tour en ajoutant /think et /no_think dans l'invite utilisateur ou le message système.
Liens associés
Blog :https://qwenlm.github.io/zh/blog/qwen3/
HF :https://huggingface.co/collections/Qwen/qwen3-67dd247413f0e2e4f653967f
github :https://github.com/QwenLM/Qwen3
Demo :https://huggingface.co/spaces/Qwen/Qwen3-Demo
Qwen Chat :https://chat.qwenlm.ai









