
 Assistant scénario▸
 Apps AI
 Actualités AI
No-OCR : un outil de traitement de documents sans extraction de texte OCR
小编 ·

No-OCR : un outil de traitement de documents sans extraction de texte OCR
Qu'est-ce que No-OCR ?
No-OCR est un outil de traitement de documents qui ne nécessite pas d'extraction de texte OCR complexe. Il suffit de télécharger un fichier PDF pour rechercher ou interroger rapidement du contenu dans plusieurs collections de documents, sans dépendre des technologies OCR traditionnelles, ce qui améliore l'efficacité de l'analyse documentaire. Il permet de créer et de gérer des collections de PDF/documents, organisées par « cas », tout en construisant automatiquement des jeux de données de style Hugging Face. De plus, No-OCR offre une recherche vectorielle de pages PDF et d'images associées (utilisant LanceDB), ainsi qu'un question-réponse visuel sur les images et les graphiques grâce à Qwen2-VL. Il prend en charge la recherche hybride texte et visuelle, peut être déployé rapidement via Docker avec une configuration simple, et fournit des instructions détaillées d'installation pour le développement.
Caractéristiques de No-OCR
Sans OCR : ne dépend pas du tout de la technologie OCR, adapté aux fichiers PDF riches en contenu visuel.
Simple et facile à utiliser : il suffit de télécharger un fichier PDF pour effectuer des recherches, prenant en charge des contenus visuels complexes (comme des tableaux, des graphiques, des mises en page, etc.).
Modèles open source : utilise des LLM (grands modèles de langage) open source pour la recherche et l'interprétation de contenu.
Déployable : prend en charge le déploiement via Docker, adapté à tout environnement d'entreprise.
Cas d'utilisation de No-OCR
Cas adapté : si les documents contiennent un contenu visuel riche (comme des tableaux, des graphiques, des mises en page, etc.), No-OCR est un excellent choix.
Cas non adapté : si les documents sont principalement du texte brut, la recherche traditionnelle BM25 peut être plus appropriée.
Contenu mixte : si les documents contiennent un mélange de texte et de contenu visuel, il peut être nécessaire d'adapter la solution en fonction des besoins.
Conception de l'architecture de No-OCR
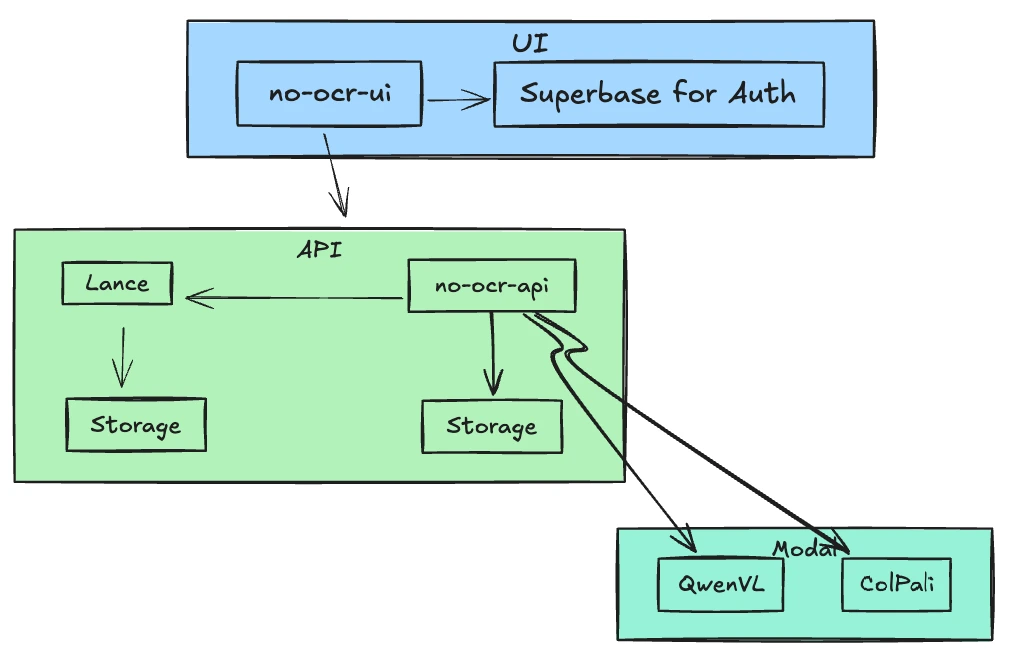
Architecture simple : ne dépend pas de base de données ni de file de messages, toutes les opérations de persistance sont basées sur le système de fichiers.
Services principaux :
Modal : utilisé pour le déploiement des LLM.
Qdrant : utilisé pour la recherche multi-vectorielle.
Supabase : utilisé pour l'authentification et l'autorisation des utilisateurs.
Création d'un cas : l'utilisateur télécharge un fichier PDF et spécifie un nom de cas, le système convertit le PDF en jeu de données et le télécharge sur Qdrant.
Processus de recherche : l'utilisateur saisit une requête de recherche, le système identifie les pages pertinentes via le LLM et interprète le contenu.
Modèles LLM de No-OCR
Famille ColPali : utilisée pour la recherche d'images, convertissant les images en format recherchable.
Famille Qwen2-VL : utilisée pour le raisonnement sur le contenu visuel, en particulier le modèle Qwen2-VL-7B-Instruct, qui est l'un des modèles visuels open source les plus avancés à ce jour.
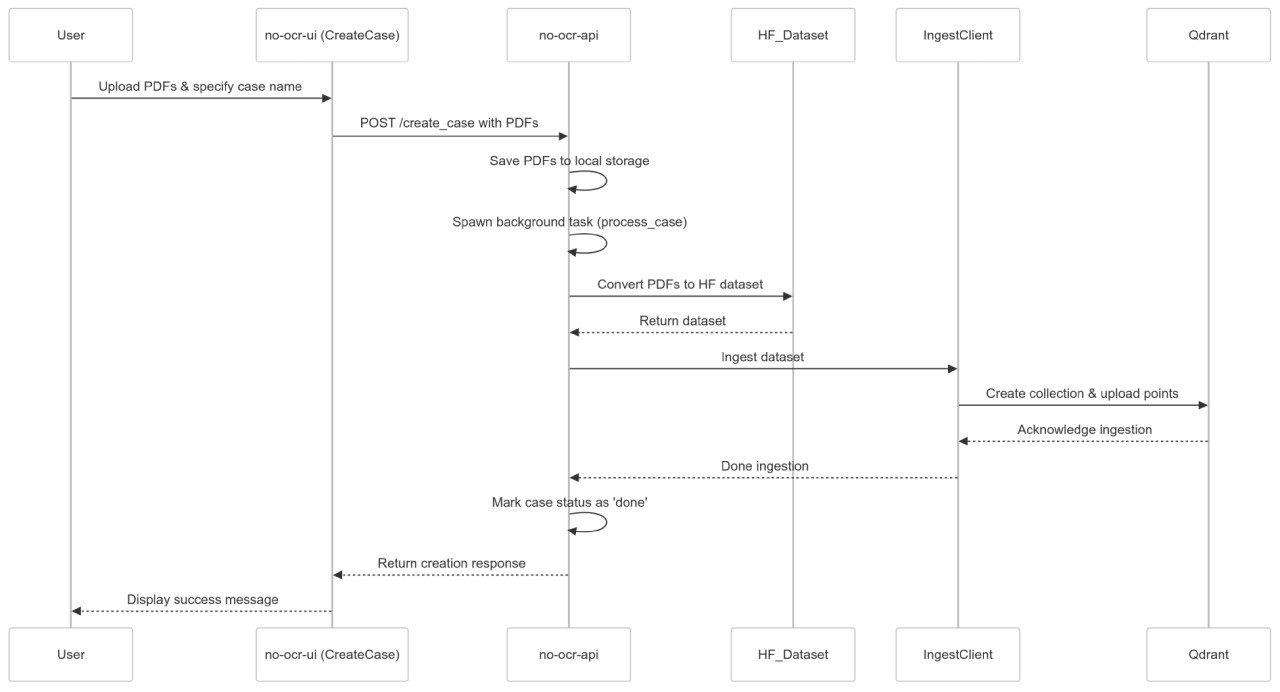
Processus de création d'un cas
Fonctionnement
La plateforme No-OCR adopte une approche RAG simplifiée. L'utilisateur télécharge simplement des fichiers PDF pour créer un cas, le système traite ces fichiers et les rend recherchables. L'utilisateur peut poser toutes sortes de questions, y compris sur des éléments visuels, et la plateforme utilise les meilleurs modèles de raisonnement open source pour fournir des réponses.
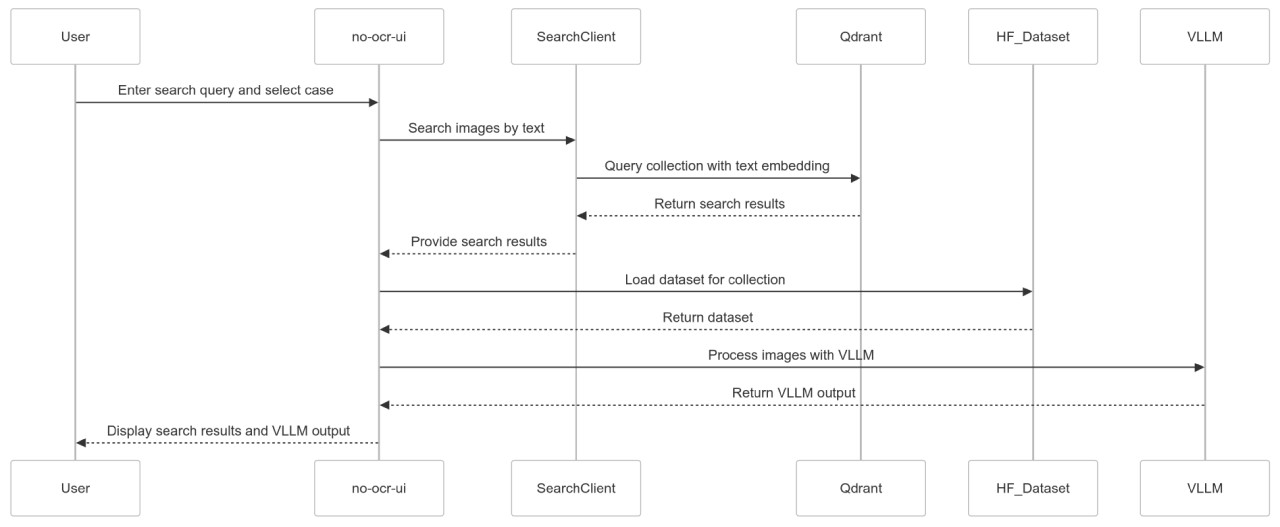
Processus de recherche
Étapes d'utilisation de No-OCR
Téléverser et traiter des PDF complexes : l'utilisateur télécharge des fichiers PDF difficiles pour créer un nouveau cas, le système génère des embeddings sans traitement OCR complexe.
Rendre le contenu recherchable : une fois le traitement terminé, l'utilisateur peut exécuter des requêtes basées sur du texte et trouver rapidement les pages et références pertinentes, quelle que soit la complexité de la mise en page du PDF.
Poser des questions visuelles : la plateforme localise rapidement les pages pertinentes, puis affine davantage les réponses grâce à des modèles visuels open source spécialisés, fournissant des informations contextuelles même si le PDF contient des diagrammes ou des graphiques.
TLDR :https://no-ocr.com/about
Github :https://github.com/kyryl-opens-ml/no-ocr









