
 Assistant scénario▸
 Apps AI
 Actualités AI
WeClone : ajustez un LLM avec votre historique de discussion WeChat pour créer un jumeau numérique personnel
小编 ·

WeClone : ajustez un LLM avec votre historique de discussion WeChat pour créer un jumeau numérique personnel
Qu'est-ce que WeClone ?
WeClone est un projet open source qui vise à affiner un LLM à partir de l'historique de discussions WeChat, et à combiner les messages vocaux WeChat avec un grand modèle pour réaliser un clonage vocal de haute qualité. Il est ensuite lié à un robot WeChat afin de créer un jumeau numérique IA personnel.
Fonctionnalités de WeClone
Affinage d'un LLM avec l'historique de discussions WeChat : le modèle de langage est affiné à partir de vos propres discussions WeChat, ce qui le rend plus proche de votre style et de vos habitudes linguistiques personnelles.
Clonage vocal de haute qualité : combinaison des messages vocaux WeChat et d'un grand modèle de 0,5B pour obtenir un clonage vocal de haute qualité.
Liaison avec un robot WeChat : le modèle affiné est lié à un robot WeChat pour activer la réponse automatique et d'autres fonctions, formant ainsi votre jumeau numérique personnel.
Caractéristiques de WeClone
Exigences matérielles : le modèle chatglm3-6b est utilisé par défaut ; un affinage avec la méthode LoRA nécessite environ 16 Go de mémoire vidéo. D'autres modèles et méthodes peuvent être configurés librement.
Exigences logicielles : il est recommandé d'utiliser Python 3.10, ainsi que des versions spécifiques de PyTorch, Transformers et d'autres bibliothèques.
Configuration de l'environnement : clonez le projet via Git, créez un environnement avec Conda et installez les dépendances.
Préparation des données : utilisez PyWxDump pour extraire l'historique de discussions WeChat et exportez-le au format CSV.
Prétraitement des données : suppression des informations sensibles, prise en charge de plusieurs méthodes de traitement des données.
Téléchargement du modèle : il est recommandé de télécharger le modèle ChatGLM3 depuis Hugging Face ou la communauté ModelScope (魔搭社区).
Affinage du modèle : modifiez les paramètres dans settings.json pour effectuer un entraînement sur une ou plusieurs cartes graphiques.
Inférence et test : une démo navigateur et des fonctions d'inférence via API sont fournies, avec prise en charge des tests de questions courantes.
Déploiement du robot WeChat : connexion via QR code, prise en charge des interactions en discussions privées et en groupes.
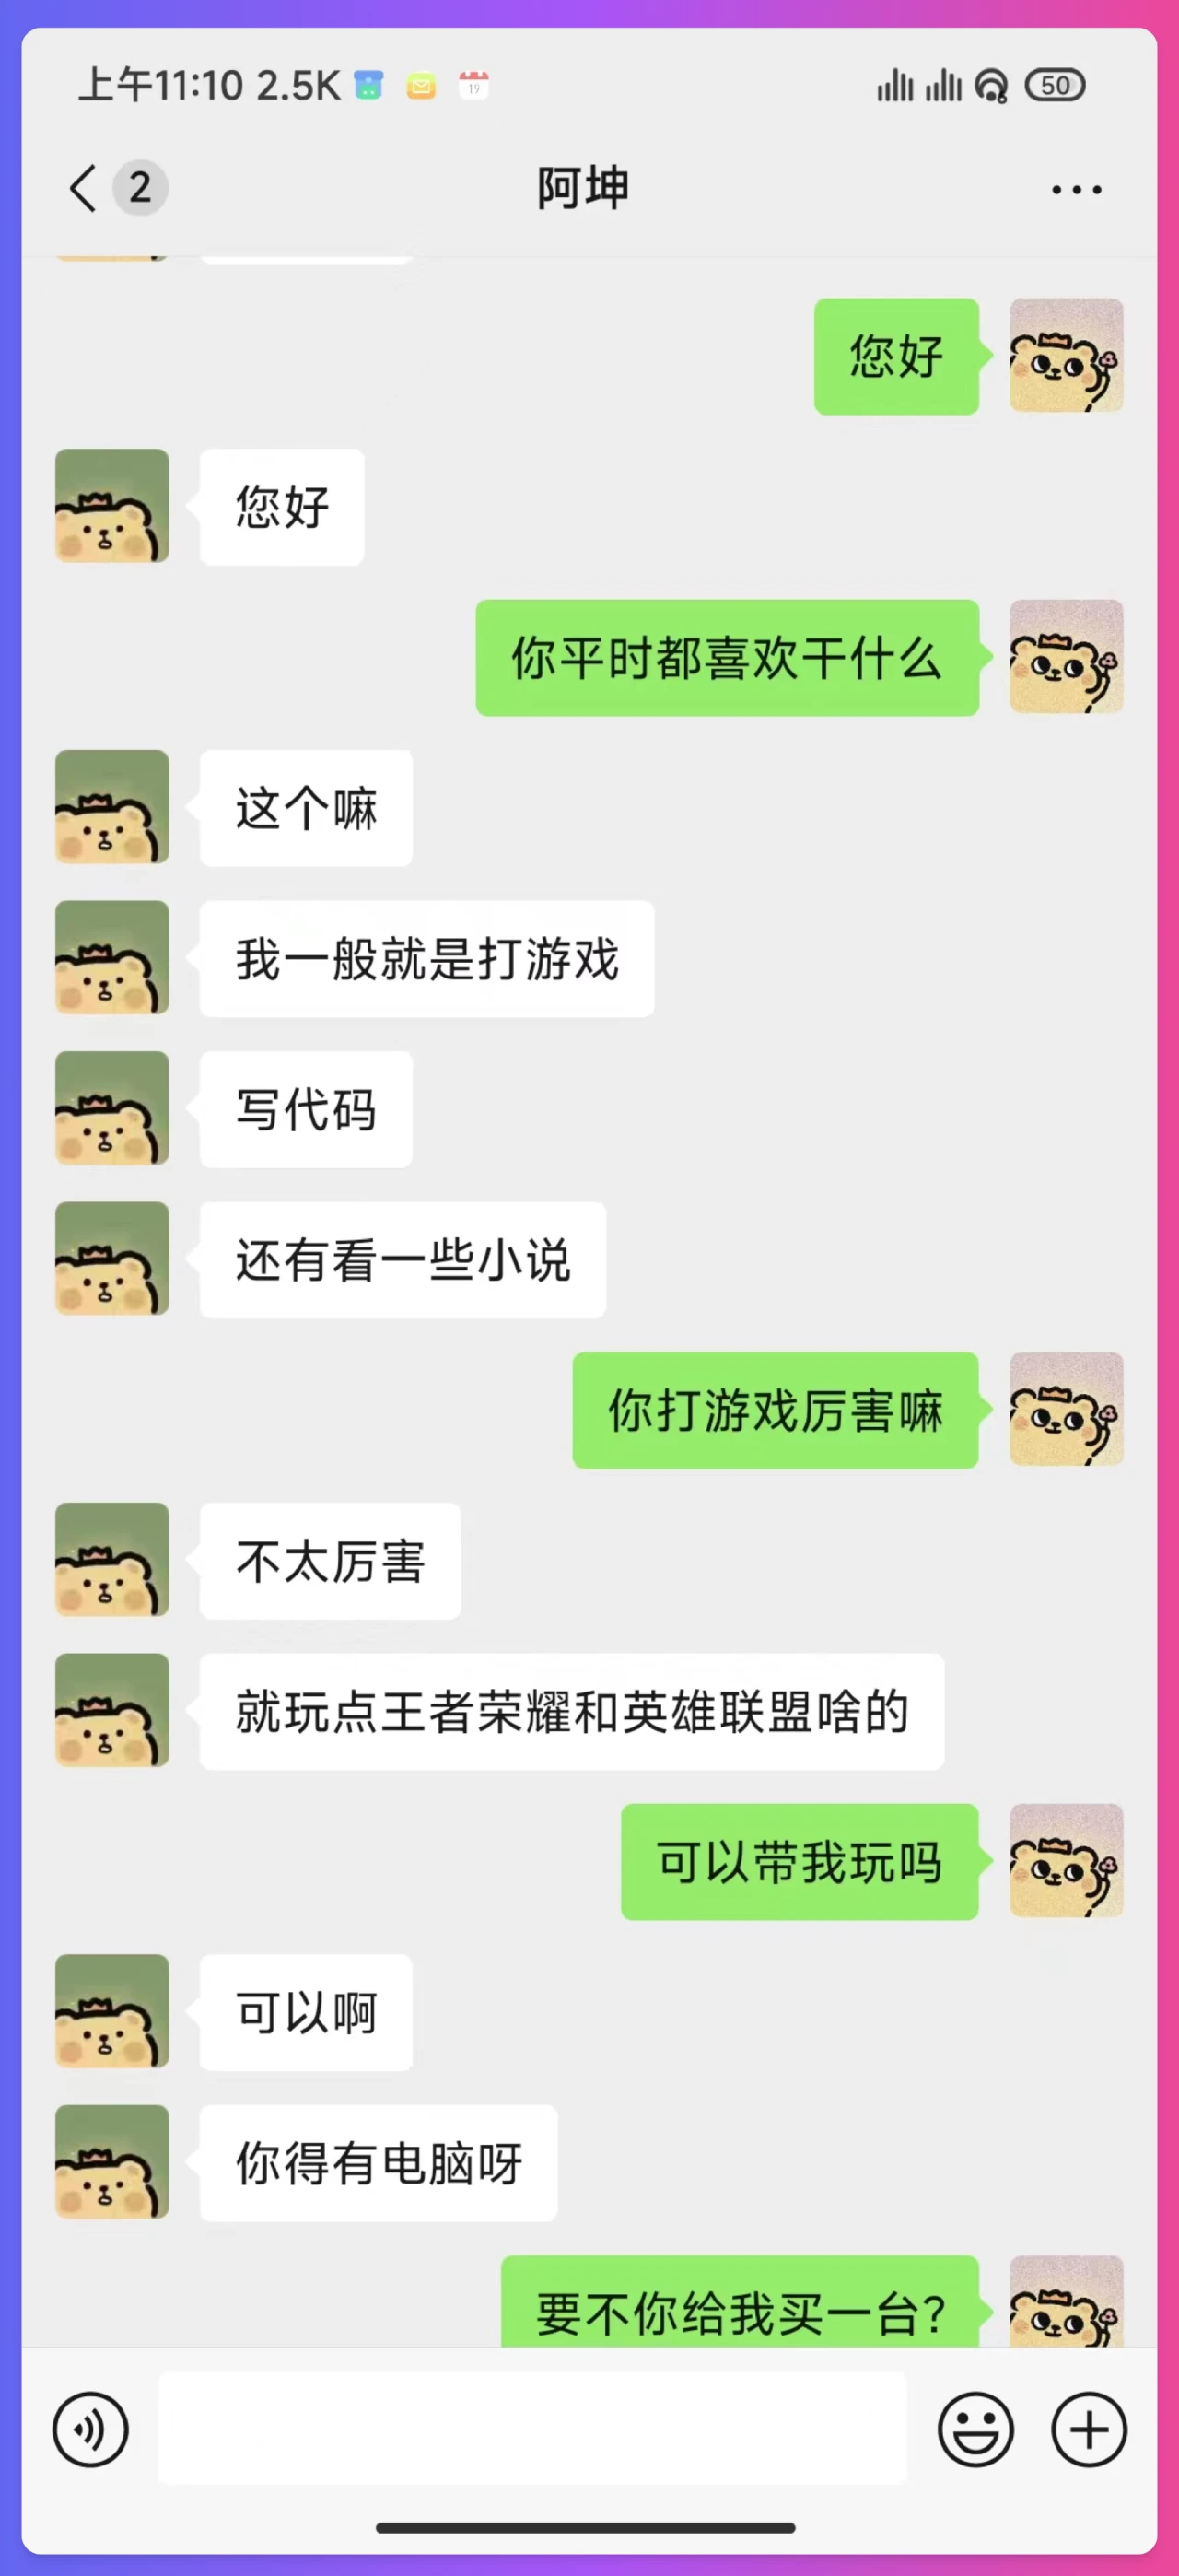
Étapes d'utilisation de WeClone
Configuration de l'environnement
Cloner le projet : exécutez la commande suivante dans le terminal pour cloner le projet WeClone en local.
git clone https://github.com/xming521/WeClone.git
Créer et activer un environnement virtuel : créez un nouvel environnement Python avec Conda, puis activez-le.
conda create -n weclone python=3.10
conda activate weclone
Installer les dépendances : accédez au répertoire du projet et installez les paquets requis.
cd WeClone
pip install -r requirements.txt
Préparation des données
Extraction de l'historique de discussions WeChat : utilisez le logiciel PyWxDump pour extraire l'historique des discussions WeChat. Téléchargez et installez ce logiciel, déchiffrez la base de données, puis cliquez sur « Sauvegarde de discussion » et choisissez le format d'export CSV. Vous pouvez exporter l'historique de plusieurs contacts ou groupes.
Placement des données : placez le dossier CSV exporté situé dans wxdump_tmp/export dans le répertoire ./data du projet, c'est-à-dire que les dossiers d'historiques de différentes personnes doivent être placés ensemble dans ./data/csv. Un exemple de données est disponible dans data/example_chat.csv.
Prétraitement des données
Suppression des informations sensibles : par défaut, le projet supprime les numéros de téléphone, les numéros de carte d'identité, les adresses e-mail, les URL et autres informations sensibles des données. De plus, une liste de mots bloqués (blocked_words) est fournie ; vous pouvez y ajouter les mots ou phrases à filtrer, et le programme supprimera par défaut toute phrase contenant un mot bloqué.
Traitement du format des données : exécutez le script ./make_dataset/csv_to_json.py pour traiter les données. Lorsqu'une même personne répond par plusieurs phrases consécutives, vous pouvez choisir l'une des trois méthodes de traitement suivantes :
Utiliser csv_to_json.py : relie les réponses en plusieurs phrases par des virgules.
Utiliser csv_to_json-单句回答.py (obsolète) : ne sélectionne que la réponse la plus longue comme donnée finale.
Utiliser csv_to_json-单句多轮.py : place les réponses en plusieurs phrases dans le champ « history » des prompts.
Téléchargement du modèle
Préférer Hugging Face : téléchargez le modèle ChatGLM3 depuis Hugging Face. Si vous rencontrez des problèmes lors du téléchargement depuis Hugging Face, vous pouvez utiliser le modèle disponible sur la communauté ModelScope (魔搭社区).
Utiliser la communauté ModelScope : si vous choisissez d'utiliser le modèle de la communauté ModelScope, exécutez d'abord les commandes suivantes.
export USE_MODELSCOPE_HUB=1 # Windows 使用 `set USE_MODELSCOPE_HUB=1`
git lfs install
git clone https://www.modelscope.cn/ZhipuAI/chatglm3-6b.git
Remarque : le fichier modeling_chatglm.py de la communauté ModelScope doit être remplacé par celui de Hugging Face.
Configuration des paramètres et affinage du modèle
Modifier le fichier de configuration : les paramètres liés à l'entraînement et à l'inférence sont centralisés dans le fichier settings.json. Vous pouvez modifier les paramètres suivants selon vos besoins :
Modifier per_device_train_batch_size ainsi que gradient_accumulation_steps pour ajuster l'occupation de la mémoire vidéo.
Modifier les paramètres num_train_epochs, lora_rank, lora_dropout, etc. en fonction de la quantité et de la qualité de l'ensemble de données.
(Facultatif) Modifier settings.json pour sélectionner un autre modèle téléchargé localement.
Entraînement sur une seule carte : exécutez la commande suivante pour l'affinage de l'étape sft.
python src/train_sft.py
L'auteur indique que sa loss n'est descendue qu'à environ 3,5 ; la faire trop baisser peut entraîner un surapprentissage. Il a utilisé environ 20 000 entrées de données effectives après consolidation.
Entraînement sur plusieurs cartes : si vous disposez de plusieurs cartes graphiques, vous pouvez utiliser deepspeed pour l'entraînement multi-cartes. Installez d'abord deepspeed, puis exécutez la commande suivante.
pip install deepspeed
deepspeed --num_gpus=使用显卡数量 src/train_sft.py
Inférence et test
Utiliser la démo navigateur pour une inférence simple : le projet fournit une démo navigateur permettant d'effectuer des tests d'inférence simples.
Inférence via API : exécutez la commande suivante pour démarrer le service API.
python ./src/api_service.py
Tester avec des questions courantes : exécutez la commande suivante pour tester des questions courantes.
python ./src/test_model.py
Déploiement du robot de discussion WeChat
Démarrer le service API : exécutez d'abord la commande suivante pour démarrer le service API.
python ./src/api_service.py
Lancer le script du robot WeChat : exécutez ensuite la commande suivante pour démarrer le robot de discussion WeChat.
python ./src/wechat_bot/main.py
Par défaut, un QR code s'affiche dans le terminal ; il suffit de le scanner pour se connecter. Vous pouvez discuter en privé ou mentionner le robot avec @ dans un groupe pour l'utiliser.
Remarques : WeChat présente un risque de bannissement de compte ; il est recommandé d'utiliser un petit compte (sub-account) et une carte bancaire doit obligatoirement être liée pour pouvoir l'utiliser.
eferrer noopener">module de clonage vocal (WeClone-audio)
Solution Spark-TTS (recommandée) :
Importer les modules nécessaires.
import SparkTTS
from SparkTTS import SparkTTS
Initialiser le modèle.
model = SparkTTS("WeClone-audio/pretrained_models/Spark-TTS-0.5B", "cuda")Effectuer l'inférence de clonage vocal.
with torch.no_grad():
wav = model.inference(
text="要生成的文本内容",
prompt_speech_path="示例音频路径",
prompt_text="示例音频对应的文本",
)
Solution Llasa :
Importer les modules nécessaires.
from text_to_speech import TextToSpeech
Initialiser et effectuer l'inférence.
tts = TextToSpeech(sample_audio_path, sample_audio_text)
result = tts.infer("要生成的文本内容")
Adresse Github :https://github.com/xming521/WeClone









