
 Assistant scénario▸
 Apps AI
 Actualités AI
PDF Document Layout Analysis : un service d'analyse de mise en page PDF et d'OCR PDF basé sur Docker
小编 ·

PDF Document Layout Analysis : un service d'analyse de mise en page PDF et d'OCR PDF basé sur Docker
Qu’est-ce que PDF Document Layout Analysis ?
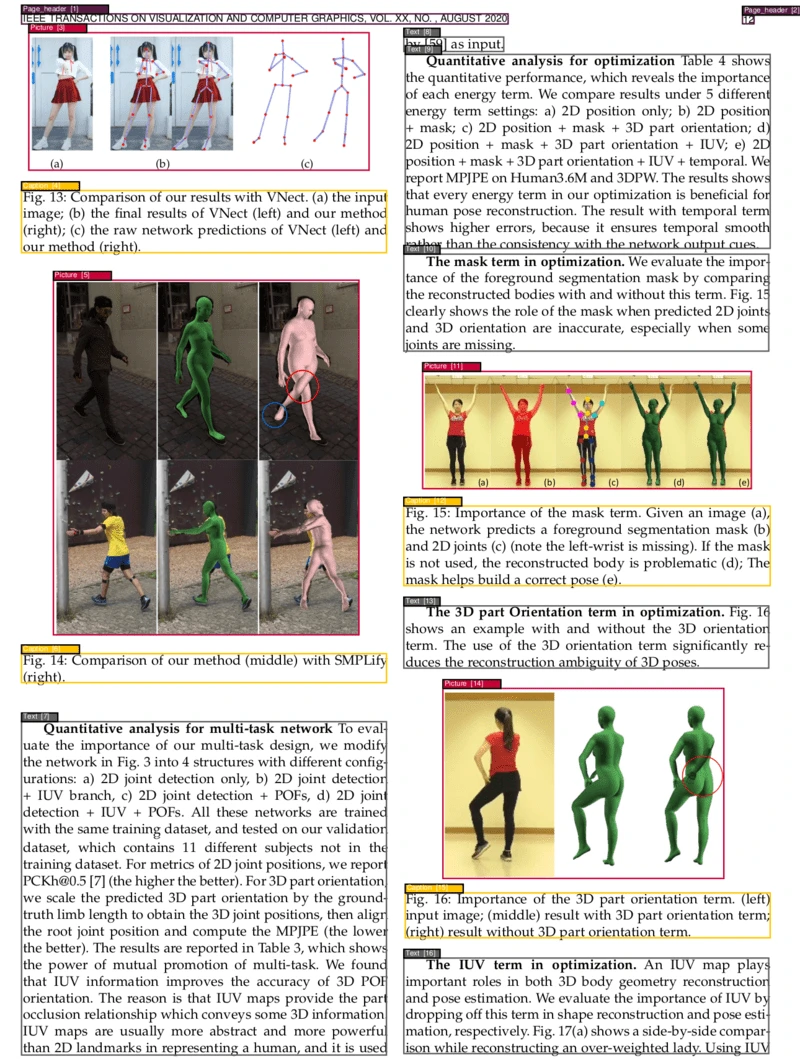
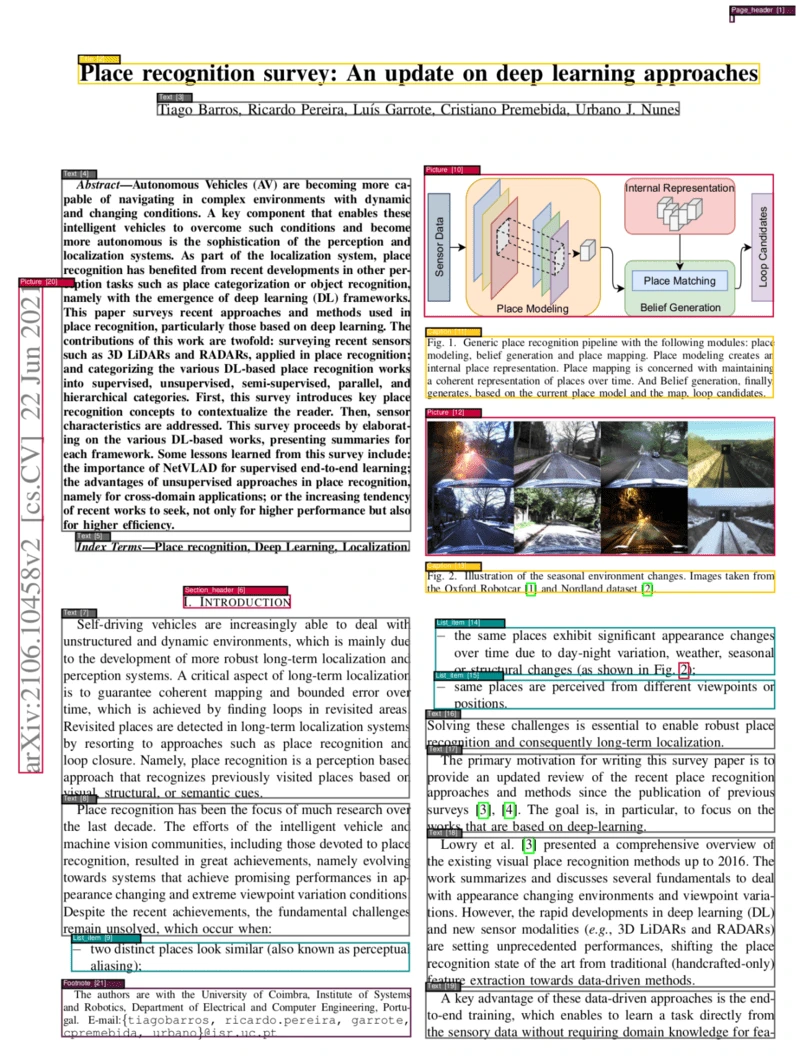
PDF Document Layout Analysis est un service basé sur Docker, destiné à analyser la mise en page de documents PDF. Il permet de segmenter et de classifier les différentes parties d’une page PDF, d’identifier automatiquement et avec précision des éléments tels que le texte, les titres, les images, les tableaux, et de déterminer l’ordre correct de ces éléments.
Fonctionnalités de PDF Document Layout Analysis
1. Fonctionnalité OCR
Prise en charge multilingue : le service prend en charge l’OCR dans plusieurs langues ; les utilisateurs peuvent traiter des documents PDF en différentes langues en spécifiant le paramètre de langue approprié.
Extraction de texte : convertit les images ou le texte non recherchable d’un PDF en texte recherchable, facilitant ainsi le traitement et l’analyse ultérieurs.
2. Segmentation et classification des pages
Reconnaissance de multiples éléments : capable d’identifier et de classifier divers éléments présents sur une page PDF :
Texte : contenu textuel standard.
Titres : titres et sous-titres du document.
Images : images présentes sur la page.
Tableaux : contenu tabulaire.
Formules : formules mathématiques, avec prise en charge de la sortie au format LaTeX.
Éléments de liste : listes ordonnées ou non ordonnées.
En-têtes et pieds de page : en-têtes et pieds de page.
Notes de bas de page : notes de bas de page du document.
Autres : légendes d’images, titres de tableaux, etc.
Classification précise : utilise des modèles visuels avancés (tels que Vision Grid Transformer - VGT) et des modèles de machine learning (les alimentant comme LightGBM) afin de garantir des résultats de classification très précis.
3. Ordonnancement des éléments
Ordre logique : détermine automatiquement l’ordre logique des éléments en fonction de la mise en page de la page et du type d’élément, garantissant que le résultat respecte l’ordre de lecture du document.
Règles d’ordonnancement personnalisables : combine l’ordre de lecture initial fourni par Poppler et le type de paragraphe pour ordonner les éléments, assurant la cohérence et la logique du résultat.
4. Sortie visuelle
PDF visualisé : permet de visualiser les résultats de l’analyse sous forme de nouveau fichier PDF, offrant une vue intuitive de la segmentation et de la classification effectuées.
Fonction d’annotation : dans la sortie visuelle, les différents types d’éléments sont annotés avec des couleurs ou des styles distincts, facilitant leur distinction.
5. Extraction de tableaux et de formules
Extraction de tableaux : prend en charge l’extraction des tableaux dans plusieurs formats, tels que Markdown, LaTeX ou HTML, pour un traitement et une analyse ultérieurs.
Extraction de formules : les formules sont exportées au format LaTeX, facilitant leur utilisation dans les documents académiques et techniques.
Cas d’utilisation de PDF Document Layout Analysis
Recherche académique : extraction et organisation du texte, des figures, des tableaux et des bibliographies à partir d’articles scientifiques, pour faciliter les revues de littérature et l’analyse de données.
Analyse de documents juridiques : analyse et structuration des actes juridiques, contrats et dossiers juridiques.
Rapports d’entreprise : extraction automatisée des données financières, graphiques et indicateurs clés, facilitant la génération d’informations et de résumés.
Archives et numérisation : numérisation et classification de documents historiques, manuscrits et archives, dans un format facilement interrogeable.
Édition et médias : organisation et mise en forme du contenu de manuscrits, articles et rapports, afin de garantir cohérence et qualité.
Démarrage rapide
Lancement du service : prise en charge des modes GPU et non GPU.
Fonctionnalité OCR : prise en charge de plusieurs langues, invocable via la commande curl.
Obtention des résultats de segmentation : envoi d’un fichier PDF via la commande curl afin d’obtenir les résultats de la segmentation.
Arrêt du service : commande fournie pour arrêter le serveur.
Dépendances et exigences
Docker Desktop : nécessite l’installation de Docker Desktop 4.25.0 ou version ultérieure.
Prise en charge GPU : si l’accélération GPU est nécessaire, les logiciels de prise en charge GPU correspondants doivent être installés.
Exigences matérielles : au moins 2 Go de mémoire sont requis ; en cas d’utilisation du GPU, 5 Go de mémoire GPU sont nécessaires.
Modèles
Modèle visuel (Vision Grid Transformer - VGT) : modèle par défaut, entraîné par l’équipe de recherche d’Alibaba, prenant en charge une analyse de mise en page plus complexe, mais nécessitant davantage de ressources.
Modèle LightGBM : modèle non visuel utilisant les informations XML extraites par Poppler pour la classification et la segmentation, plus rapide et moins gourmand en ressources.
Données
Données d’entraînement : utilisation du jeu de données DocLayNet, qui comprend 11 catégories telles que titres, notes de bas de page, formules, éléments de liste, etc.
Mode d’emploi
Commande de base : envoyer un fichier PDF via la commande curl en choisissant le modèle visuel ou non visuel.
Sortie visuelle : permet de visualiser les résultats de l’analyse sous forme de fichier PDF.
Extraction de tableaux et de formules : permet d’extraire les tableaux et les formules dans différents formats (tels que LaTeX, Markdown).
Ordre de sortie
Règles d’ordonnancement : basées sur l’ordre de lecture initial fourni par Poppler et sur le type de paragraphe, garantissant un ordre logique de la sortie.
Performances et rapidité
Performance : le modèle VGT obtient d’excellents résultats sur le jeu de données PubLayNet, avec une précision moyenne supérieure à 96 %.
Rapidité : le modèle non visuel traite chaque page en 0,42 seconde sur CPU ; le modèle visuel prend 1,75 seconde sur GPU et 13,5 secondes sur CPU.
Liens connexes
GitHub :https://github.com/huridocs/pdf-document-layout-analysis
DockerHub :https://hub.docker.com/r/huridocs/pdf-document-layout-analysis









