
 Assistant scénario▸
 Apps AI
 Actualités AI
Cloudflare lance AutoRAG : un pipeline RAG entièrement géré
小编 ·

Cloudflare lance AutoRAG : un pipeline RAG entièrement géré
Qu'est-ce qu'AutoRAG
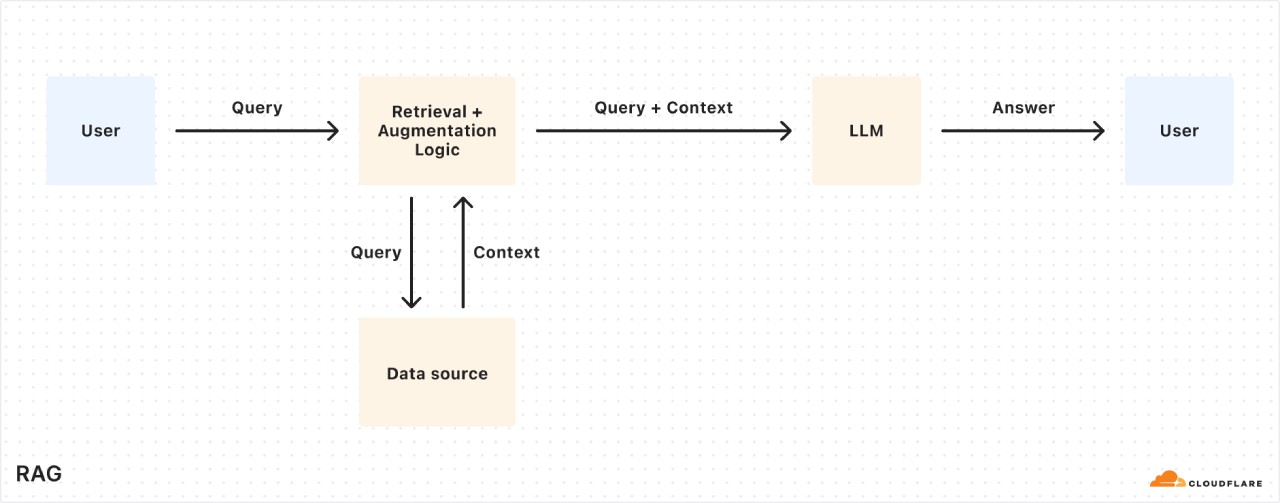
AutoRAG est un pipeline RAG entièrement géré, propulsé par Cloudflare. Le RAG est une méthode qui permet de générer des réponses plus précises et mieux adaptées au contexte en récupérant des informations à partir des données propres de l'utilisateur et en les fournissant à un grand modèle de langage (LLM).
Les points faibles des pipelines RAG traditionnels
La construction d'un pipeline RAG nécessite d'assembler plusieurs outils et services, tels que le stockage de données, les bases de données vectorielles, les modèles d'embedding, les LLM, etc. De plus, à mesure que les données évoluent, il faut réindexer manuellement et régénérer les embeddings pour maintenir la pertinence et les performances du système. AutoRAG a été conçu pour éliminer cette complexité en proposant, en quelques clics, un pipeline RAG entièrement géré de bout en bout : de l'ingestion des données au chunking et à l'embedding automatisés, en passant par le stockage des vecteurs dans la base de données Vectorize de Cloudflare, l'exécution de la recherches sémantique et la génération de réponses de haute qualité grâce à Workers ai. AutoRAG surveille et indexe en permanence les sources de données en arrière-plan, sans effort manuel, pour maintenir l'IA à jour.
Pourquoi utiliser le RAG
Limites des LLM : Bien que puissants, les LLM comme Llama 3.3 de Meta ne connaissent que les données rencontrées pendant leur entraînement et peinent souvent à fournir des réponses précises sur des informations récentes, propriétaires ou spécifiques à un domaine. Fournir des invites système pertinentes peut aider, mais cela augmente la taille de l'entrée et est limité par la fenêtre de contexte. Le fine-tuning des modèles est coûteux et nécessite un réentraînement continu pour rester à jour.
Avantages du RAG : Le RAG peut récupérer des informations pertinentes à partir des sources de données au moment de la requête, les associer à la requête de l'utilisateur, puis les transmettre ensemble à un LLM pour générer une réponse basée sur les données de l'utilisateur. Cela rend le RAG particulièrement adapté aux cas d'usage tels que les chatbots de support pilotés par l'IA, les assistants de connaissances internes, ou la recherche sémantique à travers plusieurs documents, où les sources d'information évoluent en permanence.
Comment fonctionne AutoRAG
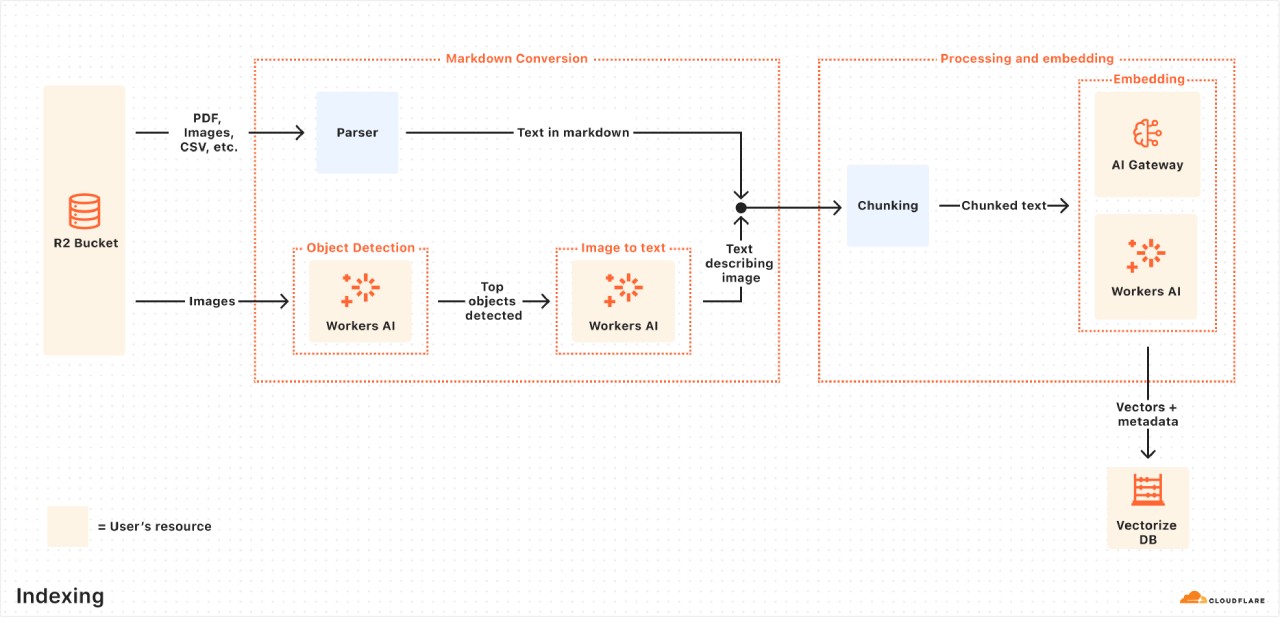
Processus d'indexation : Il s'agit d'un processus asynchrone qui s'exécute en arrière-plan, démarrant automatiquement à la création d'AutoRAG et se répétant en boucle pour traiter les nouveaux fichiers ou les fichiers mis à jour après chaque précédent travail. Pendant l'indexation, le contenu est converti en vecteurs optimisés pour la recherche sémantique.
Ingestion de fichiers : AutoRAG lit directement les fichiers depuis les sources de données et prend actuellement en charge l'intégration avec Cloudflare R2, où l'on peut stocker des documents dans divers formats (PDF, images, texte, HTML, CSV, etc.) destinés à être traités.
Conversion Markdown : La conversion Markdown de Workers AI est utilisée pour transformer tous les fichiers en un format Markdown structuré, garantissant la cohérence entre les types de fichiers. Pour les images, Workers AI est utilisé pour la détection d'objets, suivie d'une conversion visuel-vers-texte afin de transformer les images en texte Markdown.
Chunking : Le texte extrait est divisé en blocs plus petits pour affiner la granularité de la récupération.
Embedding : Chaque bloc est intégré à l'aide des modèles d'embedding de Workers AI, convertissant le contenu en vecteurs.
Stockage vectoriel : Les vecteurs obtenus, ainsi que les métadonnées (telles que l'emplacement source et le nom du fichier), sont stockés dans la base de données Vectorize de Cloudflare, créée sur votre compte.
Processus de requête : Il s'agit d'un processus synchrone, déclenché lorsqu'un utilisateur envoie une requête de recherche.
Réception d'une requête depuis l'API AutoRAG : Le flux de travail de la requête commence lorsque vous envoyez une requête aux endpoints de recherche IA ou de recherche d'AutoRAG.
Réécriture de la requête (optionnelle) : AutoRAG propose une option pour réécrire la requête d'entrée à l'aide de l'un des LLM de Workers AI, améliorant la qualité de la récupération en transformant la requête originale en une requête de recherche plus efficace.
Embedding de la requête : La requête réécrite (ou originale) est convertie en vecteur via le même modèle d'embedding utilisé pour l'embedding des données, afin de pouvoir être comparée aux données vectorisées pour trouver les correspondances les plus pertinentes.
Recherche vectorielle dans Vectorize : Le vecteur de la requête est recherché parmi les vecteurs stockés dans la base de données Vectorize associée à AutoRAG.
Récupération des métadonnées + du contenu : Vectorize renvoie les blocs les plus pertinents ainsi que leurs métadonnées, et le contenu original est récupéré depuis le bucket R2. Ce contenu est transmis au modèle de génération de texte.
Génération de la réponse : Le modèle de génération de texte de Workers AI est utilisé pour produire une réponse basée sur le contenu récupéré et la requête originale de l'utilisateur.
Tutoriel d'utilisation d'AutoRAG
Utilisation de l'API Browser Rendering : Si le contenu ne se trouve pas dans un bucket R2, mais qu'il est encore sur un site web ou doit être rendu dynamiquement via une interface front-end, l'API Browser Rendering peut être utilisée pour crawler votre propre site web et obtenir le contenu qui alimentera le RAG. L'API REST Browser Rendering est désormais entièrement disponible et propose des endpoints pour les opérations courantes du navigateur, notamment l'extraction de contenu HTML, la capture de captures d'écran et la génération de PDF. De plus, un endpoint de crawling est bientôt disponible, ce qui facilitera encore davantage la récupération de contenu web.
Étape 1 : Créer un Worker pour crawler les pages web et les télécharger vers R2
Créez un nouveau projet Worker nommé browser-r2-worker et sélectionnez les options appropriées pour le configurer.
Installez @cloudflare/puppeteer afin de contrôler l'instance de rendu du navigateur.
Créez un nouveau bucket R2 nommé html-bucket.
Ajoutez la configuration correspondante dans le fichier de configuration Wrangler afin que le Worker puisse utiliser le Browser Rendering et le nouveau bucket R2.
Remplacez le contenu de src/index.ts en écrivant le code du script permettant de crawler les pages web et de les stocker dans le bucket R2.
Déployez le Worker sur votre compte Cloudflare.
Testez le Worker à l'aide d'une requête cURL pour crawler le fichier HTML d'une page web et le télécharger dans le bucket html-bucket.
Étape 2 : Créer AutoRAG et surveiller l'indexation
Dans le tableau de bord Cloudflare, accédez à AI > AutoRAG.
Choisissez de créer un AutoRAG et terminez le processus de configuration, incluant la sélection du bucket R2 contenant la base de connaissances, du modèle d'embedding, du LLM, de la passerelle AI, la dénomination de l'AutoRAG ainsi que la sélection ou la création d'un jeton d'API de service.
Une fois l'AutoRAG créé, il créera automatiquement une base de données Vectorize dans votre compte et commencera l'indexation des données. Vous pouvez suivre la progression des tâches d'indexation sur la page de présentation de l'AutoRAG.
Étape 3 : Tester et intégrer dans votre application
Une fois l'indexation terminée, vous pouvez commencer à poser des questions à AutoRAG. Vous pouvez poser des questions dans l'onglet Playground de votre instance AutoRAG, par exemple « Qu'est-ce qu'AutoRAG ? ».
Si vous êtes satisfait des résultats dans le Playground, vous pouvez intégrer AutoRAG directement dans l'application que vous construisez. Si vous utilisez un Worker pour construire votre application, vous pouvez appeler AutoRAG directement via une liaison AI.
Pendant la phase de test en accès libre (open beta), AutoRAG est gratuit. Les opérations de calcul liées à l'indexation, à la récupération et à l'augmentation n'entraînent aucuns frais supplémentaires à ce stade.
Présentation officielle détaillée :https://blog.cloudflare.com/introducing-autorag-on-cloudflare/









