
 Assistant scénario▸
 Apps AI
 Actualités AI
Crawl4AI : un crawler et scraper web open source et adapté à l'IA
小编 ·

Crawl4AI : un crawler et scraper web open source et adapté à l'IA
Qu'est-ce que Crawl4ai ?
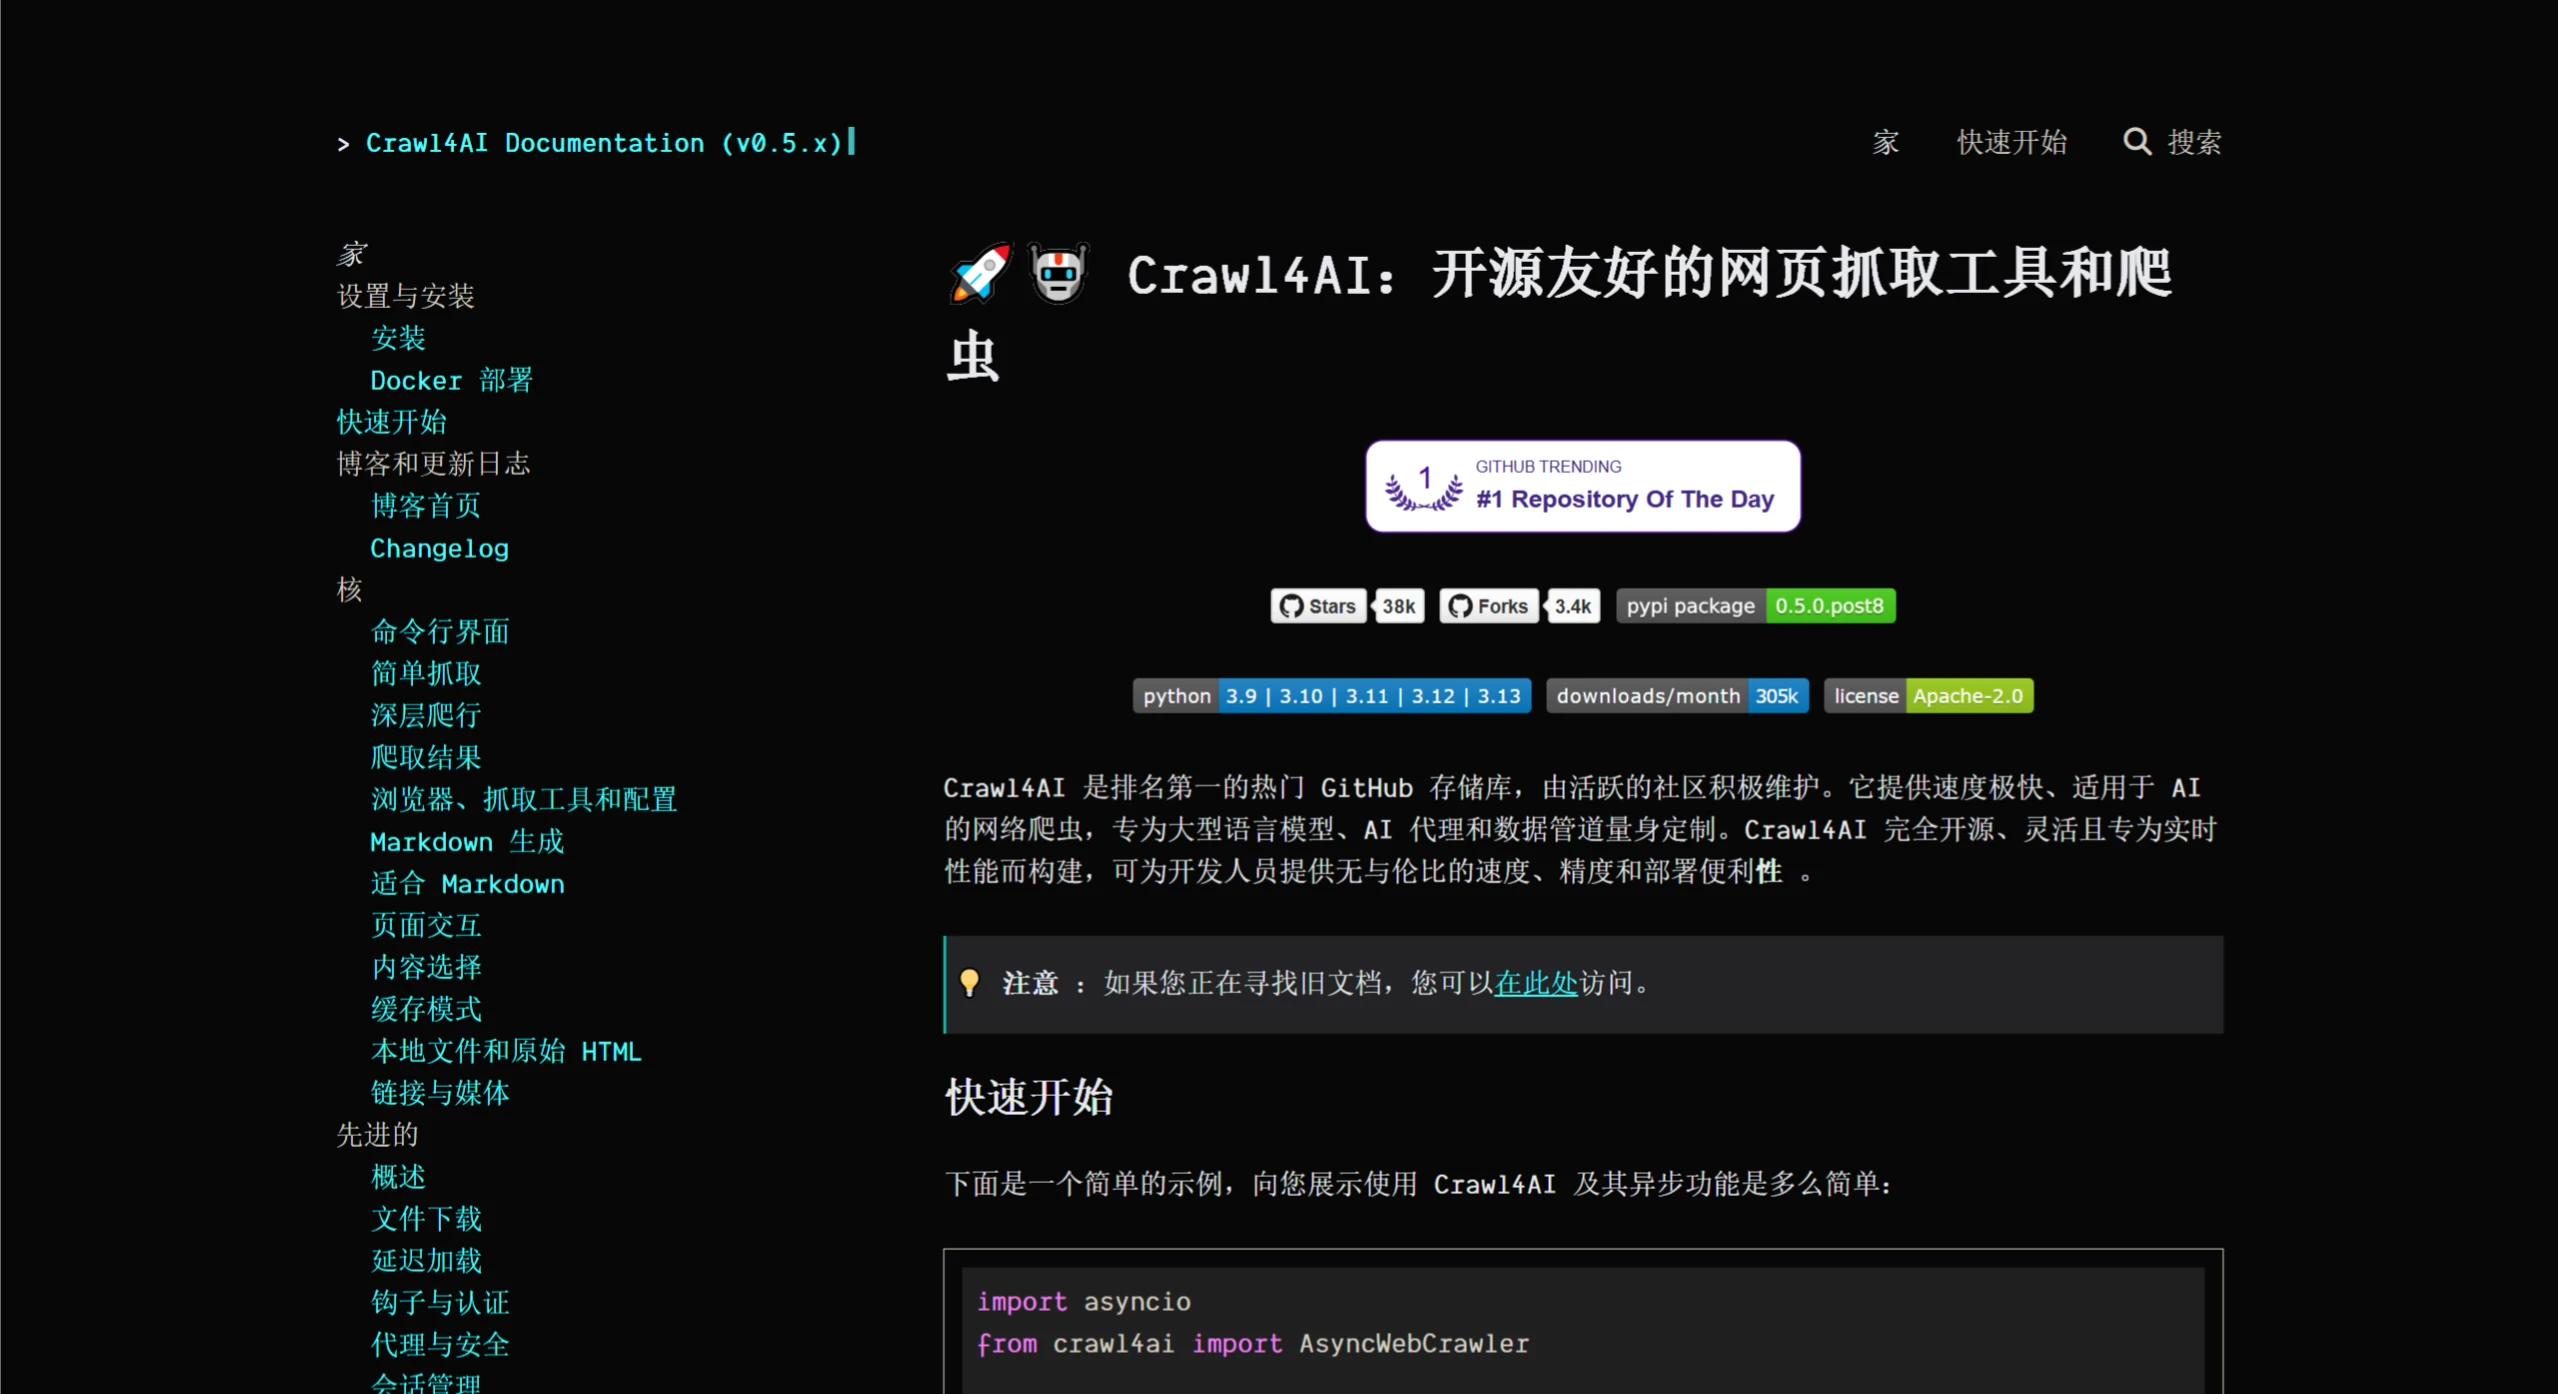
Crawl4AI est un web crawler et scraper open-source convivial pour l'IA, un projet populaire sur GitHub, conçu pour les LLM, les agents IA et les pipelines de données. Il prend en charge une extraction rapide et flexible des données web, génère des données au format Markdown adaptées aux LLM, et offre l'extraction de données structurées, l'intégration au navigateur, le traitement de contenu dynamique, etc.
Fonctionnalités de Crawl4AI
Génération Markdown
Markdown propre : génère un texte Markdown à la structure claire et au format précis.
Markdown adapté : filtre le bruit et le contenu non pertinent grâce à des algorithmes heuristiques pour produire un Markdown adapté au traitement par IA.
Citations et références : convertit les liens de la page en listes de références numérotées, accompagnées de citations claires.
Stratégies personnalisées : les utilisateurs peuvent créer leurs propres stratégies de génération Markdown pour répondre à des besoins spécifiques.
Algorithme BM25 : filtre le contenu sur la base de l'algorithme BM25 afin d'extraire les informations essentielles et d'éliminer les éléments superflus.
Extraction de données structurées
Extraction pilotée par LLM : prend en charge tous les LLM (open-source et propriétaires) pour l'extraction de données structurées.
Stratégies de découpage : implémente un découpage basé sur les topics, les expressions régulières et le niveau de phrase.
Similarité cosinus : trouve les blocs de contenu pertinents à partir d'une requête utilisateur pour une extraction sémantique.
Extraction basée sur CSS : utilise XPath et les sélecteurs CSS pour une extraction rapide de données basée sur des motifs.
Définition de schémas : définit des schémas personnalisés pour extraire des données JSON structurées à partir de motifs récurrents.
Intégration au navigateur
Navigateur hébergé : utilise votre propre navigateur pour éviter d'être détecté comme un crawler.
Contrôle à distance du navigateur : se connecte à un navigateur distant via le protocole Chrome DevTools pour l'extraction de données à grande échelle.
Profils de navigateur : crée et gère des profils persistants pour conserver les états d'authentification, les cookies et les paramètres.
Gestion de session : préserve et réutilise l'état du navigateur pour permettre un crawling en plusieurs étapes.
Prise en charge des proxys : se connecte de manière transparente à des proxys avec authentification afin de garantir un accès sécurisé.
Contrôle complet du navigateur : modifie les en-têtes de requêtes, les cookies, le user agent, etc., pour personnaliser les paramètres de crawling.
Prise en charge multi-navigateurs : compatible avec Chromium, Firefox et WebKit.
Ajustement dynamique du viewport : ajuste automatiquement la fenêtre du navigateur en fonction du contenu de la page afin d'assurer un rendu complet et la capture de tous les éléments.
Crawling et scraping
Prise en charge des médias : extrait les images, l'audio, la vidéo ainsi que les formats d'images responsives (tels que srcset et picture).
Crawling dynamique : exécute du JavaScript et attend le contenu asynchrone ou synchrone pour extraire le contenu dynamique.
Captures d'écran : capture des captures d'écran de la page pendant le processus de crawling, à des fins de débogage ou d'analyse.
Crawling de données brutes : traite directement le HTML brut (raw: ) ou les fichiers locaux (file://).
Extraction complète des liens : extrait les liens internes, externes ainsi que le contenu des iframes intégrées.
Crochets personnalisés : définit des crochets à chaque étape afin de personnaliser le comportement du crawling.
Cache : met les données en cache pour accélérer le traitement et éviter les抓取 répétitifs.
Extraction des métadonnées : extrait des métadonnées structurées à partir des pages web.
Extraction du contenu des iframes : extrait de manière transparente le contenu des iframes intégrées.
Gestion du lazy loading : attend le chargement complet des images afin de ne rien omettre à cause du chargement différé.
Numérisation de la page entière : simule le défilement pour charger et capturer tout le contenu dynamique, adapté aux pages à défilement infini.
Autres fonctionnalités
Mode furtif : évite la détection en tant que crawler en imitant le comportement d'un utilisateur réel.
Extraction de contenu basée sur des balises : affine le contenu爬取 en fonction de balises, titres ou métadonnées personnalisés.
Analyse des liens : extrait et analyse tous les liens pour une exploration détaillée des données.
Gestion des erreurs : gestion robuste des erreurs garantissant une exécution fluide.
CORS et service statique : prend en charge la mise en cache basée sur le système de fichiers et les requêtes cross-origin.
Documentation claire : guides simplifiés pour la prise en main et l'utilisation avancée.
Avantages de Crawl4AI
Conçu sur mesure pour les LLM : génère un Markdown intelligent et concis, adapté aux applications RAG et au fine-tuning.
Performance extrême : performances en temps réel et économiques, jusqu'à 6 fois plus rapides que les méthodes traditionnelles.
Contrôle flexible du navigateur : offre la gestion de session, la prise en charge des proxys et des crochets personnalisés, garantissant un accès fluide aux données.
Intelligence heuristique : utilise des algorithmes avancés pour extraire efficacement le contenu, réduisant la dépendance à des modèles coûteux.
Open-source et déployable : entièrement open-source, sans clé API requise, prend en charge Docker et l'intégration au cloud.
Cas d'application de Crawl4AI
IA et apprentissage automatique : fournit des données d'entraînement de haute qualité aux LLM, prend en charge le traitement du langage naturel et la construction de graphes de connaissances.
Pipelines de données : construit des pipelines de données efficaces pour extraire et traiter en temps réel les données web.
Extraction de contenu : extrait du texte, des images, des vidéos et d'autres contenus multimédias à partir des pages web, destinés aux systèmes de gestion de contenu.
Recherche académique : aide les chercheurs à extraire articles et données de recherche depuis le web, soutenant les travaux de recherche académique.
Business intelligence : extrait des données de marché, des informations produits et des avis utilisateurs pour appuyer les décisions commerciales.
Médias d'information :抓取 rapidement le contenu des actualités, prenant en charge l'agrégation d'actualités et l'analyse de contenu.
Tutoriel d'installation et d'utilisation de Crawl4AI
Installation
Installation de base :
pip install crawl4ai
crawl4ai-setup  # 设置浏览器
Installer la version pre-release :
pip install crawl4ai --pre
Installation pour le développement :
git clone https://github.com/unclecode/crawl4ai.git
cd crawl4ai
pip install -e .  # 基本安装
pip install -e ".[all]"  # 安装所有可选功能
Adresse Github :https://github.com/unclecode/crawl4ai
Documentation Crawl4AI :https://docs.crawl4ai.com/
Discord :https://discord.com/invite/jP8KfhDhyN









