
 Assistant scénario▸
 Apps AI
 Actualités AI
Versatile-OCR-Program : un OCR capable d'extraire des données structurées de matériaux complexes comme des copies d'examen
小编 ·

Versatile-OCR-Program : un OCR capable d'extraire des données structurées de matériaux complexes comme des copies d'examen
Qu'est-ce que Versatile-OCR-Program ?
Versatile-OCR-Program est un système OCR spécifiquement optimisé pour l'entraînement de modèles d'apprentissage automatique. Il est capable d'extraire des données structurées à partir de documents éducatifs complexes (tels que des sujets d'examen) et de les restituer aux formats JSON ou Markdown. Il prend en charge le japonais, le coréen et l'anglais, et peut être étendu à d'autres langues, aux formules mathématiques, aux tableaux, aux diagrammes et aux graphiques. Il permet également l'annotation sémantique en générant des descriptions en langage naturel.
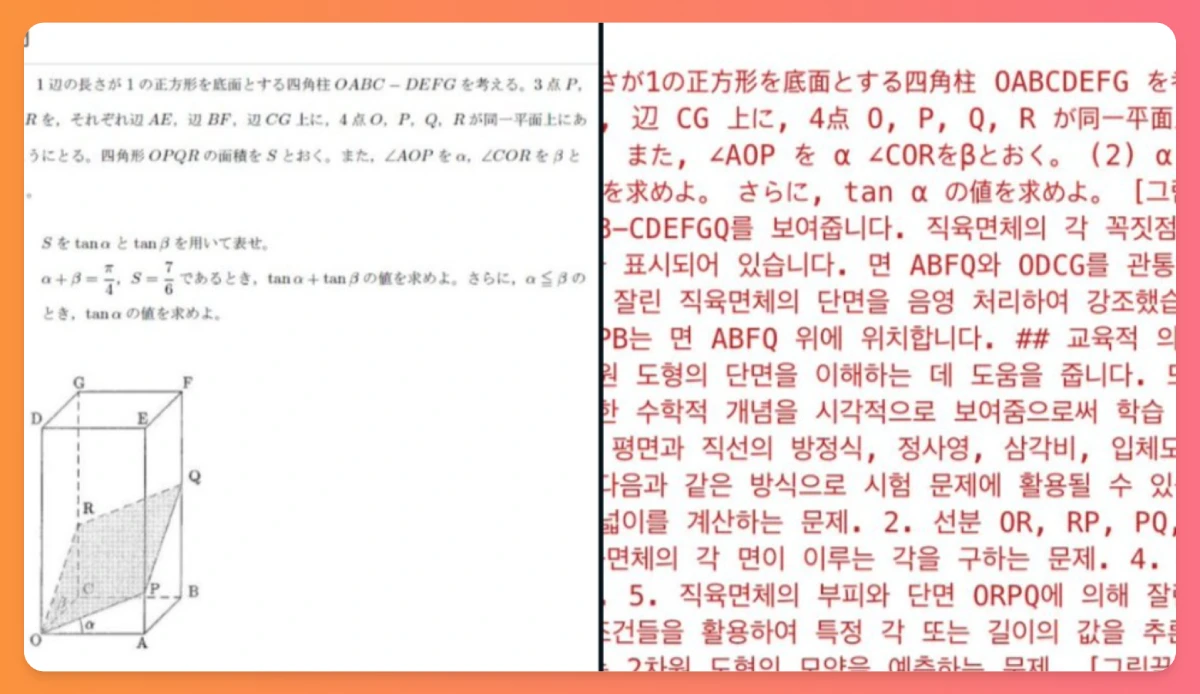
Caractéristiques principales de Versatile-OCR-Program
Optimisé pour l'entraînement de modèles d'apprentissage automatique : les éléments extraits (tels que les diagrammes, les tableaux et les figures) sont annotés sémantiquement, y compris la génération automatique de descriptions en langage naturel du contenu visuel, afin d'améliorer l'entraînement des modèles en aval.
Support multilingue : prend en charge le japonais, le coréen et l'anglais, et peut être facilement personnalisé pour d'autres langues.
Sortie structurée : génère des sorties prêtes pour l'IA aux formats JSON ou Markdown, incluant des descriptions lisibles par l'homme des expressions mathématiques, des résumés de tableaux et des légendes de figures.
Haute précision : atteint un taux de précision de 90 % à 95 % sur des jeux de données académiques réels tels que la biologie EJU et les mathématiques de l'Université de Tokyo.
Prise en charge des mises en page complexes : capable de traiter avec précision des PDF de type examen contenant un contenu scientifique dense, des paragraphes riches en formules et de nombreux éléments visuels.
Implémentation technique : utilise des technologies telles que DocLayout-YOLO, Google Vision API, Gemini Pro Vision, MathPix OCR, OpenAI API, OpenCV, etc.
Exemples de sortie
Fournit des exemples concrets de sortie, incluant les images d'entrée et les images de sortie converties pour des problèmes de mathématiques et de biologie, ainsi que le contexte sémantique traduit en anglais et les données extraites.
Exemple de problème mathématique : montre comment extraire des informations à partir d'une image contenant des figures géométriques et des angles, et générer les descriptions et questions associées.
Exemple de problème de biologie : montre comment extraire des informations à partir d'une image illustrant le processus de mitose des cellules de la pointe de racine d'oignon, et générer les descriptions et questions associées.
Processus d'utilisation de Versatile-OCR-Program
Étape 1 : Extraction OCR initiale : exécutez le script ocr_stage1.py pour extraire les éléments bruts (texte, tableaux, figures, etc.) du PDF d'entrée, effectuer la détection de la mise en page et stocker les résultats intermédiaires.
Étape 2 : Interprétation sémantique et sortie finale : exécutez le script ocr_stage2.py pour traiter les données intermédiaires et les convertir en une sortie structurée et lisible par l'homme, y compris la génération d'explications en langage naturel, de résumés et l'organisation du contenu dans un format prêt pour l'IA (JSON/Markdown).
Implémentation technique
Optimisation du traitement des tableaux : utilise DocLayout-YOLO pour détecter les zones de tableaux, Google Vision OCR pour le traitement des tableaux (plus efficace pour les textes japonais), et conserve la structure des tableaux dans un format JSON structuré.
Traitement des images et des zones spéciales : utilise la fonctionnalité d'analyse d'images de Google Vision API pour traiter les zones d'images, Google Cloud Vision API pour générer des descriptions d'images, la fonctionnalité d'analyse de documents de Google Cloud Vision API pour traiter les graphiques/diagrammes, et stocke les résultats du traitement dans un format JSON structuré.
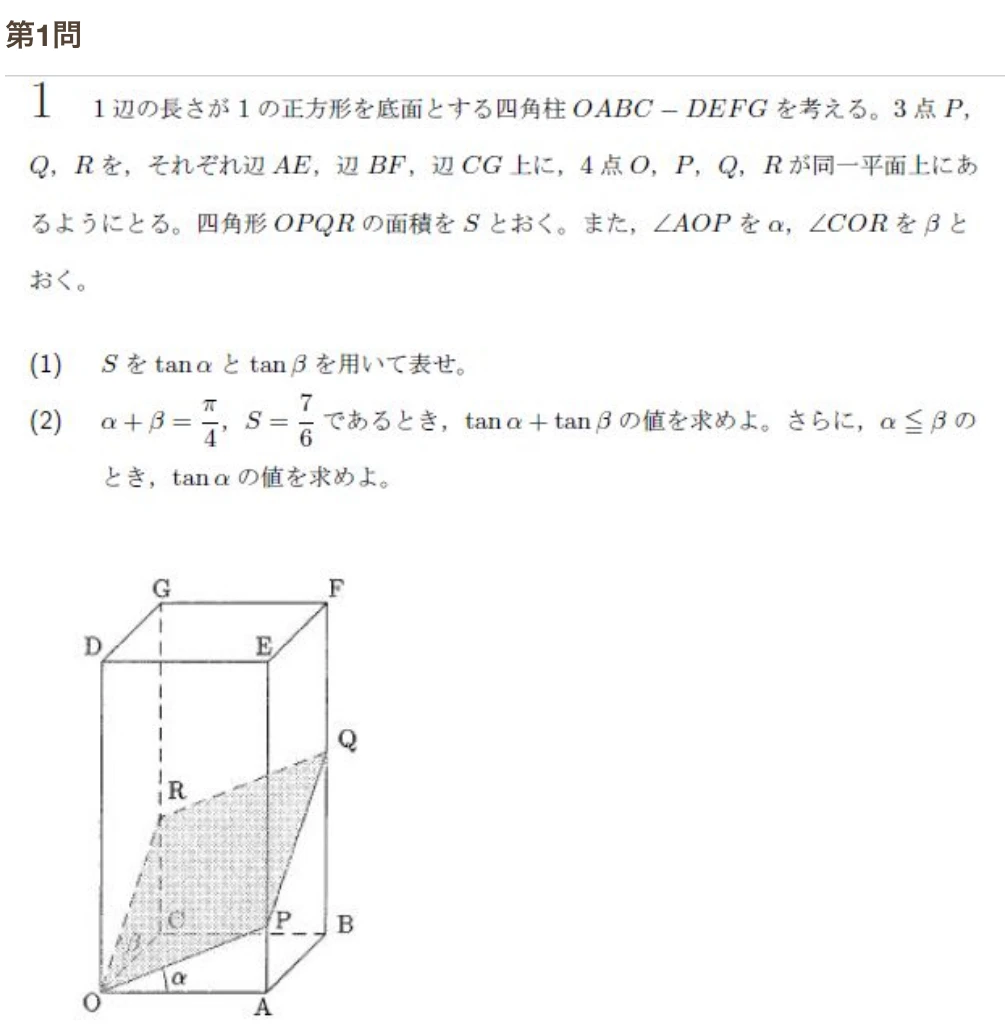
Effet d'entrée
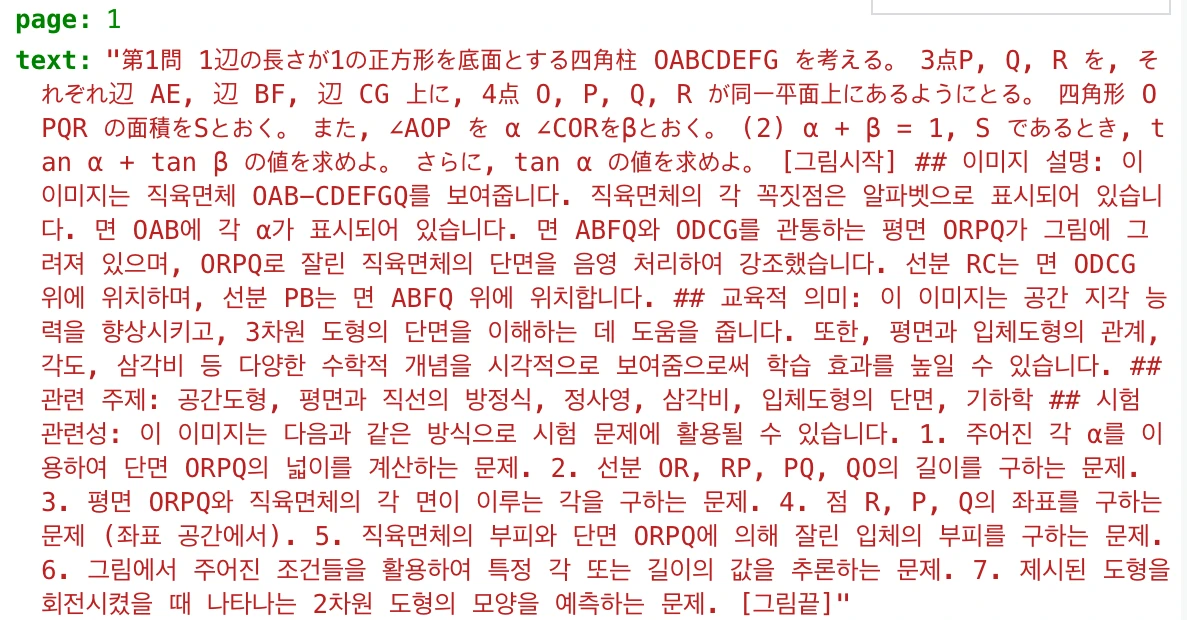
Effet de sortie
Applications de Versatile-OCR-Program
Domaine éducatif : utilisé pour extraire et organiser les données de sujets d'examen, d'articles académiques et d'autres supports pédagogiques, afin de soutenir la recherche et l'apprentissage en éducation.
Entraînement de modèles d'apprentissage automatique : produit des jeux de données d'entraînement de haute qualité, utilisés pour entraîner des modèles d'apprentissage automatique, en particulier dans les applications du domaine éducatif.
Traitement de documents multilingues : convient aux scénarios nécessitant le traitement de documents en plusieurs langues, tels que les échanges académiques internationaux, la numérisation de supports pédagogiques multilingues, etc.
Projet GitHub :https://github.com/ses4255/Versatile-OCR-Program









