
 Assistant scénario▸
 Apps AI
 Actualités AI
OmniTalker : le framework d'Alibaba pour avatars parlants en temps réel
小编 ·

OmniTalker : le framework d'Alibaba pour avatars parlants en temps réel
Qu'est-ce qu'OmniTalker ?
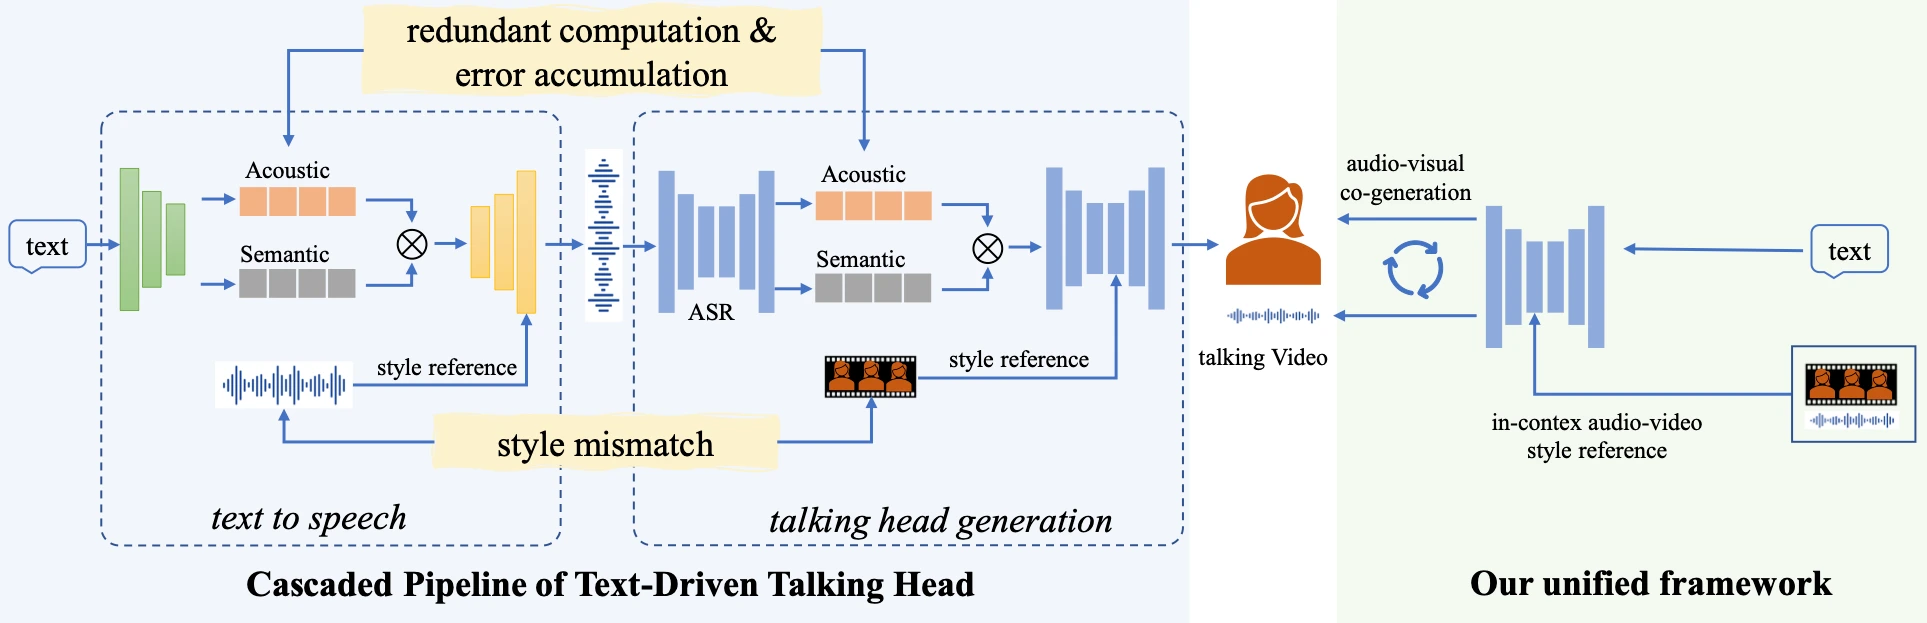
OmniTalker est un cadre de génération multimodal piloté par texte en temps réel d'avatar parlant, développé par le laboratoire Tongyi d'Alibaba. Il peut générer en temps réel une voix et des animations vidéo correspondant au contenu textuel saisi. La voix et la vidéo générées sont non seulement de haute qualité, mais reproduisent également de manière réaliste les expressions faciales et les mouvements de tête, comme si un véritable « humain numérique » discutait avec vous. OmniTalker prend en charge la conversion entre le chinois et l'anglais, ainsi que l'expression émotionnelle telle que le calme, la joie, la tristesse, la colère, etc., et prend également en charge la génération de longues vidéos.
Fonctionnalités d'OmniTalker
Traitement d'entrée multimodal : capable de percevoir plusieurs modalités telles que le texte, l'image, l'audio et la vidéo.
Génération en flux : génère du texte et des réponses vocales naturelles en flux continu. Les encodeurs audio et vidéo adoptent une méthode de traitement par blocs, découplant ainsi le traitement des données multimodales de longues séquences.
Synchronisation audio-vidéo précise : grâce à la technologie TMRoPE, garantit une synchronisation précise entre les entrées vidéo et audio.
Interaction en temps réel : prend en charge l'entrée par blocs et la sortie instantanée, permettant une interaction entièrement en temps réel.
Génération vocale naturelle et fluide : excellentes performances en termes de naturel et de stabilité de la génération vocale, surpassant de nombreuses alternatives en flux et non en flux existantes.
Avantages en termes de performances : performances remarquables dans les tests de référence multimodaux, avec des capacités audio supérieures à celles de Qwen2-Audio de taille similaire, et au même niveau que Qwen2.5-VL-7B.
Technologie de base d'OmniTalker
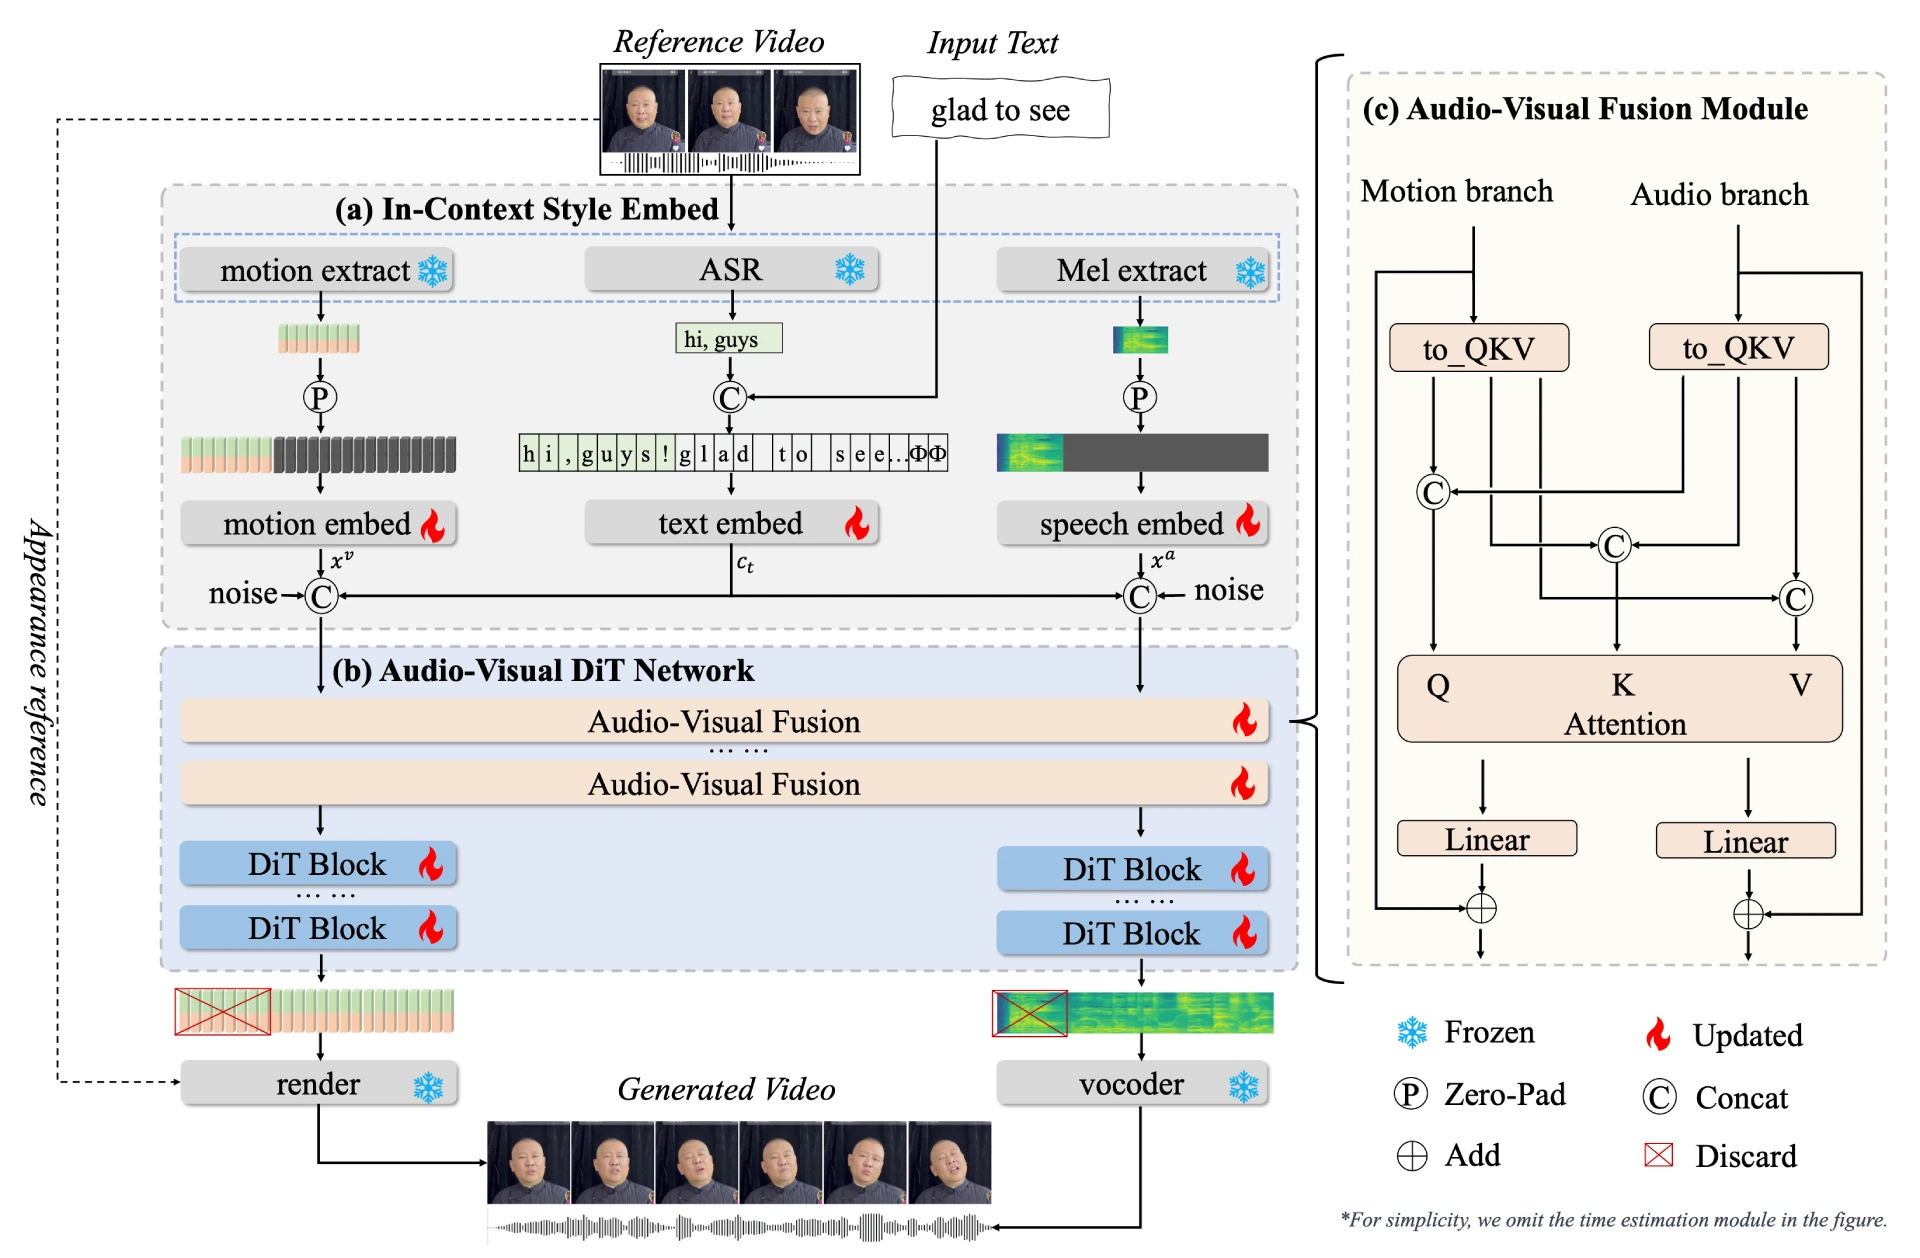
1. Architecture à double branche de transformateur de diffusion (DiT)
Comprend une branche audio et une branche visuelle :
Branche audio : synthétise une voix de haute qualité à partir du texte.
Branche visuelle : prédit les poses de la tête et la dynamique faciale.
Grâce à un nouveau module de fusion audio-visuel, garantit la synchronisation temporelle et la cohérence stylistique des sorties audio et vidéo.
2. Apprentissage contextuel de référence
OmniTalker est capable de capturer les caractéristiques de la voix et du style facial à partir d'une seule vidéo de référence, sans nécessiter de module supplémentaire d'extraction de style. Cela signifie que, quel que soit le texte saisi, OmniTalker est capable de générer un contenu vocal et vidéo hautement cohérent avec le style de la vidéo de référence.
3. Temps réel et efficacité
OmniTalker est capable de générer en temps réel de la voix et de la vidéo à une vitesse de 25 FPS, ce qui est très avancé parmi les technologies similaires. Cette vitesse d'inférence efficace permet à OmniTalker d'être appliqué dans des scénarios tels que les discussions vidéo en temps réel et le streaming virtuel, offrant aux utilisateurs une expérience交互 fluide.
Scénarios d'application d'OmniTalker
Assistant vocal intelligent : traite les commandes vocales des utilisateurs et génère des réponses vocales en temps réel.
Création de contenu multimodal : traite simultanément les entrées texte, image et vidéo pour générer des descriptions textuelles ou vocales correspondantes.
Éducation et formation : génère des enseignants virtuels qui produisent de la voix et de la vidéo en fonction du contenu pédagogique.
Service client et assistants virtuels : crée des assistants ou un service client virtuels qui génèrent des réponses vocales et vidéo en temps réel.
Divertissement et médias : crée des présentateurs et acteurs virtuels qui génèrent du contenu de表演 en temps réel.
Avantages d'OmniTalker
Génération de haute qualité : le contenu vocal et vidéo généré est de haute qualité et reproduit précisément le style de la vidéo de référence, y compris les variations subtiles de l'intonation, du rythme et des expressions faciales.
Apprentissage zéro-shot : ne nécessite pas de grandes quantités de données d'entraînement, peut générer rapidement du contenu en fonction du texte saisi et de la vidéo de référence, s'adaptant à différents scénarios et besoins.
Interaction en temps réel : génère de la voix et de la vidéo en temps réel à une vitesse de 25 FPS, avec une faible latence, adapté aux scénarios tels que les discussions vidéo en temps réel et le streaming virtuel.
Site officiel du projet :https://humanaigc.github.io/omnitalker/
Article technique :https://arxiv.org/pdf/2504.02433v1









